Gluesync 2.3.0:AI Studioで独自のLLMプロバイダーを利用可能、オンプレミスのエンタープライズブレインを共有、挿入競合ルールの選択、矢印を描いてフィールドをマッピング。
Gluesync 2.3.0は、2026年10月13日より一般提供が開始されました。このリリースでは、モデルの選択、書き込みルール、フィールドのマッピングをユーザーが自由に制御できるようになりました。AI Studioはユーザーが登録したLLMプロバイダー上で動作し、エンタープライズブレインはCore Hubの横に共有スキーマメモリを保持します。また、すべての挿入競合戦略はエンティティごとに選択可能であり、フィールドエディタではソースからターゲットへのマッピングを矢印で描画できます。
バージョン2.3.0は、Core Hubモジュール全体を通じて、Gluesync史上最大規模のアップデートとなります。
Sparkのご紹介
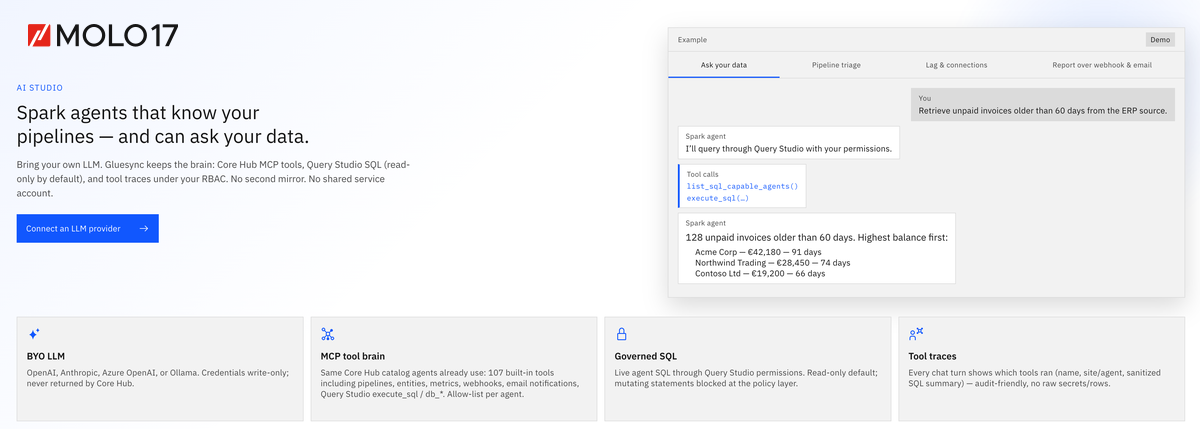
SparkエージェントはGluesync AI Studio内に存在します。独自のLLMを活用しましょう:Sparkは、Core Hub MCPツールおよびRBACの下で管理された読み取り専用のQuery Studio SQLを通じて動作し、すべてのツール呼び出しにはトレースが残ります。エージェントハーネスを使用して再利用可能でバージョン管理されたエージェントを構築し、モデルゲートウェイを経由してルーティングし、SparkエージェントAPIを使用してアプリケーションから呼び出すことができます。Sparkの詳細はこちら。
AI Studio:独自のモデル、独自の鍵、独自のルール
AI Studioは、Control Plane内のワークスペースであり、ここで独自のLLMプロバイダーを登録し、ガバナンスが適用されたSparkエージェントを運用します。OpenAI、OpenAI互換のエンドポイント、Anthropic、Azure OpenAI、またはローカルのOllamaインスタンスを利用できます。認証情報は、スーパー管理者だけが管理する暗号化された保管庫に保存され、オプションでトークン単価を設定できるため、財務部門に確認を求める前に推定費用を把握できます。
- エージェントはログイン中のユーザーとして実行され、エージェントごとにツール許可リストが設定されます。RBAC(ロールベースのアクセス制御)は有効なまま維持され、各エージェントは指定されたツールにのみアクセスできます
- 不変のスキルやバージョン管理されたTEXTエージェントを公開し、重複防止、結果の伏せ書き、耐久性のあるSSEタイムラインを備えた非同期実行を開始できます。会話内容は検索可能で、保存期間もユーザーが制御できます
- 固定されていた8ラウンドのツール上限は廃止されました。ループポリシーは、ステップの上限、同一呼び出しのフィンガープリント、連続失敗回数、実行時間、およびコストによって各ターンを制限し、停止理由を記録します。公開された実行ステップは永続化されるため、Hubを再起動した際に安全な処理を再開したり、曖昧な処理に対して「最大1回」の書き込みとしてマークしたりできます。
AIワークロード向けのガバナンスとAPI
機能、コンテキスト、リジデンシー、健全性、価格、および加重品質に基づいて、標準モデルカタログから最適なモデルをルーティングし、リクエストの実行前に包含・除外をプレビューできます。所有者およびAPIキーの予算、スコープ指定された1回限りのgsa_シークレット、レート制限、使用状況の計上、および監査証跡がプラットフォームに標準で搭載されています。
ネイティブの /api/ai/v1 に加え、OpenAI互換の /v1/models および /v1/chat/completions は、ストリーミング、Responses API フォーマット、埋め込み、サーキットブレーカー付き自動モデルフォールバック、正確なレスポンスキャッシュ(所有者、APIキー、モデルごと)、および情報マスキングに対応したPrometheus/OTLPテレメトリをサポートしています。GET /api/ai/v1/capabilities は、そのノードが実際に実行しているもののみを一覧表示します。
パイプラインの変更ツールは引き続き確認を必要とします。最初の呼び出しは保留中のアクションとなり、5分以内に明示的な確認を行うと実行されます。破壊的なツールはチャット内に「確認」/「キャンセル」ボタンと共に保留され、APIキーおよびChronosへの書き込みは、WAITING_APPROVAL状態で、ログイン済みのユーザーを待ちます。認証情報は全工程を通じて伏せられたままです。
Query Studio、パイプライン、Chronosを横断するSpark
- Query Studio AIヘルパー — スキーマをすでに把握しているチャット機能に加え、サフィックスのみを基にしたTabキーによるゴーストテキスト自動補完機能により、次の候補を提案しつつ、入力した内容を上書きすることはありません。同じ保管庫、同じキー。機密扱いのPIIセルはモデルに送信されることはありません
- AI as SQL — Hubが所有する読み取り専用の
gluesync.aiカタログは、他のテーブルと同様にQuery Forgeによって提供されるため、JDBC接続が可能な環境であれば、SELECT … FROM gluesync.ai WHERE question = …を実行して行を取得できます。詳細はAI as SQLをご覧ください - パイプライン作成ツール — 会話内に順序付けられたマルチパイプライン計画を保持し、「続行」で最初の未完了項目を再開し、最終的なSOURCEとTARGETが指定されると、ウィザードと同じ完了遷移を経て「下書き」状態を離れます
- Ask Spark — すべてのチャットで、読み取り専用の
search_documentationおよびsearch_support_knowledgeが利用可能で、これらはhttps://docs.molo17.comで返される内容からのみ引用されます - Chronos — 「スケジュール」と「イベント」では、そのページに基づいたSparkパネルが開きます。Chronos 0.3.0では、
ai_agent_runを通じて、プロンプトテンプレート、ペイロードの許可リスト、ループガードを設定して、公開されたエージェントを実行できます。すべての書き込みは確認を待ちます
Enterprise brain:インフラストラクチャ上の単一の共有メモリ
gluesync.db
の隣にある専用の
gluesync-ai-brain.db
には、スキーマグラフ(MySQL、MariaDB、Oracle、SQL Server、Db2からの外部キーエッジを含む)、エージェントのメモリ、会話、スキルの添付データ、および承認済みの社内ツールが格納されています。メモリはデフォルトで、そのエージェントを使用するすべてのユーザー間で共有されます。「これを非公開にする」と指定すれば、そのデータはあなただけのものになります。
メモリには場所と手順が記録されますが、行データや機密情報は一切記録されません。
キーワード検索は常に有効です。EMBEDDINGS機能を備えたモデルが存在する場合、埋め込み機能が提供されます。社内ツールは、事前設定済みのギャラリー(Slack、Gmail、GitHub、GitLab、Notion、Microsoft Agent 365 サーバーなど)またはカスタム HTTPS MCP サーバーから取得され、ツールバンドルスキルとして公開されます。外部クライアントは、list_published_agents、start_agent_run、get_agent_run、publish_skill、およびsearch_enterprise_brainといったMCPツールを、呼び出し元の権限の範囲内で使用します。所有権はあなたにあり、管理もあなたが行い、これはSaaSではありません。
書き込みパス:ルールはユーザーが選択します
- 競合処理戦略の挿入 — エンティティごとに、
UPSERT(デフォルト)、SKIP、またはFAILのいずれかを選択します。これは、挿入対象がターゲットにすでに存在する行と重複した場合に適用されます - スカラー関数呼び出し — フィールド関数は、バインドプレースホルダーの代わりに、ターゲット側のスカラー関数をステートメントに書き込みます(Oracleの
pkg.f_…、およびこの機能を採用している他のRDBMSライターでも同様の形式となります) - カスタムフィールド関数 — パイプラインレベルで再利用可能なJava関数:コレクションを公開・インストールし、フィールドエディタでターゲット列を複数のソース列または固定値を引数としてバインドし、エンティティやUDF間で共有し、まずテストパネルで試すことができます。カスタムフィールド関数
- UDFの進化 — 配列やマップ列によってエディタが固まることがなくなり、すべてのUDFにはCDCからの初期ロードを判別するための
isSnapshotフラグが付与されます。フィールド関数とUDFは併用可能です。UDFがまず行の形状を変更し、フィールド関数はその出力に対して実行されます
フィールドエディタ:マッピングを描画する
ソーステーブルとターゲットテーブルの間にはガターがあり、各関係は、あるドットから別のドットへとドラッグする矢印で表されます。クリックやキーボード操作も可能です。
- 意図的にサポートされているすべての関係タイプ:1:1、N:1、1:N、読み取り専用(書き込み不可)のソース、およびフィールド関数またはUDFによってのみ値が供給されるターゲット列。M:Nはサポートされていません
- 矢印は、名前(まず大文字小文字を区別した完全一致、次に大文字小文字を区別しない一意の一致)または順序位置によって提案されます。「マッピングのリセット」で提案が復元され、「マッピングのクリア」で全ての矢印が削除されます
- キーは矢印に従います。ソースの主キーは、主キーを持つターゲットの非キー列にはリンクできません。その場合はエディタがその理由を通知します
- 「元に戻す」は1ステップずつ実行されます。「スクロールロック」を有効にすると、両方のテーブルとその矢印が連動して移動します
- ディスカバリーで返されなくなった保存済み列は、自身の矢印のみを削除します。データベースから削除されたターゲット列は「データベースに存在しません」というタグが付いたままとなり、削除するまで保存がブロックされます
以前のリリースでロック解除されていたスキーマは、もはやサポートされていません。ロック解除されたエンティティを初めて編集すると、マッピングが移行され、保存するまでUDF、設定、フィルター、およびキーマッピングが保持されます。フィールドエディタのドキュメントを参照してください。
2.3.0 のその他の機能
- MCP カタログのツール数が 125 種類に — パイプライン作成、Chronos、通知、Validator、保存済みクエリ、PII 分類、ドキュメント検索、AI エージェントツールが、同一の Core Hub MCP サーバーおよびベアラートークン上で利用可能
- データガバナンス — Query Studio および Fields Editor での PII 検出とマスキング、接続スコープのデータアクセスマトリックス、カスタムアクセステンプレート
- コネクタ —
ReplacingMergeTree経由の ClickHouse ターゲット; SQL Server の自動 CDC / 変更追跡の有効化(デフォルトでは無効);Kafka、Solace、Google Pub/Sub でのストリーミングによるビフォアイメージ - データバリデータ — エンティティごとの非同期かつキャンセル可能な比較機能。差異は永続化され、オプションで調整が可能
- スマートアラート v2 — 各エンティティの活動頻度を学習してから「非アクティブ」と判定;ベースラインは Core Hub の再起動後も維持される
 RSSフィードを取得する