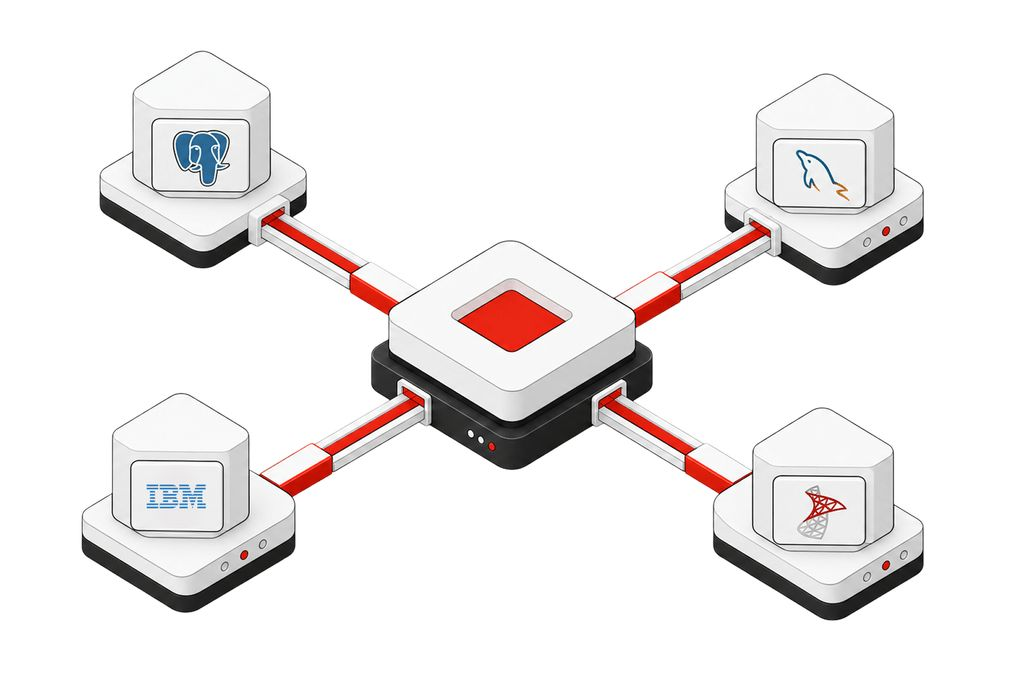
フェデレーションSQL(クエリフェデレーション)とは、物理的に分散・サイロ化された複数の異なるデータソース(MySQL、PostgreSQL、Snowflake、BigQueryなど)にデータを集約(ETL)することなく、1つのSQL文で同時にアクセスして結合・分析できる技術や機能のことです。
GlueSyncのCore Hub への JDBC URL は 1 つだけです。スキーマは、すでに稼働しているエージェントにマッピングされます。データウェアハウスを構築することなく、エージェント間の結合が可能です。
通常、データベース間の結合を行うには、データウェアハウス、ETLジョブ、あるいはスプレッドシートでのデータ統合が必要となります。Query Forgeは、それとは異なる選択肢です。Core Hubへの1つのJDBC URL、すでに稼働しているSQL対応エージェントにマッピングされたスキーマ、そして同じQuery Studioパスを通じてフィルターを適用するクエリ。新しいデータチャネルも、書き込みパスも不要です。
ここでは、リリースされたばかりのQuery Forgeについて、「なぜ」「いつ」「概要(何)」「方法」を解説します。
なぜ
アナリストやBIツールには、Gluesyncエージェントの背後にすでに配置されているシステム全体にわたる単一のSQL操作画面が必要です。システム環境の複製を新たに構築するのはコストがかかります。すべてのデータベースをすべてのノートPCからアクセス可能にするのは、さらに問題です。
Query Forgeは、Core Hubをその操作画面に変えます。外部のJDBCクライアント(DBeaver、DataGrip、Tableau、ダッシュボード、スクリプトなど)は、SQL対応のエージェントを複数にまたがる単一のステートメントを実行します。Query Studioは、単一のエージェント向けのポータル内ワークベンチとしての役割を維持します。Query Forgeは、フェデレーションのための外部ゲートウェイとなります。
読み取り操作では、権限が設定されたQuery Studioの実行パスを再利用します。エンジンは、呼び出し元がすでに読み取りを許可されている行のみを認識します。フェデレーションによって、顧客データへの第二のパスが新たに作成されることはありません。
いつ
Query Forge をご利用ください:
- 標準の JDBC または BI クライアントから、エージェント間の
JOIN(またはマルチスキーマ SQL)が必要な場合。 - エージェントはすでに接続済みで SQL に対応しており、データウェアハウスを構築せずにクエリアクセスを行いたい場合。
- 認証はユーザー単位(Core HubのIDとスコープ)で維持され、読み取り専用の実行パス上で行われる必要があります。
- APIにアクセスする場合と同様、Gluesync Connectを介してCore Hubにアクセスします。プロキシを接続します。「Connectとローカル」の区別による設定の分岐はありません。
以下の場合は、Query Studioを使用し続ける(またはフェデレーションをスキップ)してください:
- コントロールプレーン内から1つのエージェントを調査している場合。
- ワークロードに書き込みが必要な場合。Query ForgeはQuery Studioの読み取り専用パスを通じて実行されます。
- クエリに、巨大なリモートテーブルに対して有効なフィルタがない場合。そのテーブルは結合の前にフェッチされ、プッシュダウン選択性が重要となります。
- 現時点でネイティブな
DATE/TIMESTAMP型が必要な場合。ドキュメントでは現在、日付/時刻はテキストとして公開されています(ISO文字列は依然として比較およびソートが可能です)。
概要
アクセス単位。 SQL対応のエージェント(パイプライン+エージェント)ごとに1つのスキーマが形成されます。そのエージェント下のテーブルは、そのスキーマ下のテーブルとなります。
スキーマの命名規則。
- パイプライン内にSQL対応のエージェントが1つの場合:スキーマ名はパイプライン名と同じになります(例:
sales.orders)。 - SQL対応のエージェントが複数ある場合:曖昧さを解消した名前になります(例:
sales__pg.orders)。 - 識別子は大文字小文字を区別しません。
ドライバー:Query Forge には、gluesync-unified-jdbc という名前の専用ドライバー(JAR)が同梱されています。これは、Query Forge セットアップウィザードに従うことで、Core Hub から直接入手できます。接続 URL:jdbc:gluesync://<host>:<port>。
認証(自身として): 共有サービストークンはありません。
- SSO / OIDC:
token接続プロパティを設定するか、ユーザー名に__token__を指定し、トークンをパスワードとして使用します。セッショントークンまたはパーソナルAPIトークン(gsp_…)。一度設定するJDBCクライアントには、PATの使用が推奨されます。 - ローカルアカウント:Core Hubのユーザー名とパスワード(バックエンドでトークンに変換されます)。
プッシュダウン: カラム投影;比較演算子(=、<>、<、<=、>、>=)、IS NULL/IS NOT NULL、LIKE、およびAND/OR/NOT。複雑なINリストやカラム間の比較は、フェッチ後も中央処理のままです。集計および型付き比較のための型情報は、エージェントスキーマのメタデータから取得されます。
セキュリティ: ユーザーごとのスキーマ可視性。不正な認証情報の場合、接続は失敗します。読み取り専用。TLSを前段に配置してください(リバースプロキシまたはプラットフォームターミネーション)。
Query ForgeはCDCバスではありません。ConnectはこのパスにおいてCDC行データを転送しません。ConnectはCore Hub APIをプロキシする役割を果たします。データの移動は引き続きパイプラインが行いますが、Forgeを使用すると、それらのエージェントがすでに公開しているデータに対してクエリを実行できます。
方法
1. SQL対応のエージェントが存在し、呼び出し元がそれらに対してクエリを実行できることを確認します(Query Studioと同じスコープ)。
2.クライアントのクラスパスに gluesync-unified-jdbc を追加します。
3. jdbc:gluesync://<host>:<port> (ドキュメントの例:jdbc:gluesync://corehub.example.com:8765)で接続します。
4. 認証を行います(ローカルユーザー名/パスワード、または __token__ / token + gsp_…)。
5.スキーマを閲覧します:アクセス可能な SQL 対応エージェントごとに 1 つずつ表示されます。
6.フェデレーテッド SQL を作成します:
SELECT c.name, COUNT(o.id) AS order_count, SUM(o.total) AS revenue
FROM crm.customers c
JOIN sales.orders o ON o.customer_id = c.id
GROUP BY c.name
ORDER BY c.name;
 RSSフィードを取得する