Gluesync 2.3.2:任意の時点からCDCを再生、スタンバイのCore Hubサイトを稼働、Query Studioでレイクファイルをクエリ、Podmanへのデプロイ、そしてスピードテストによるスナップショットの最適化が可能になりました。
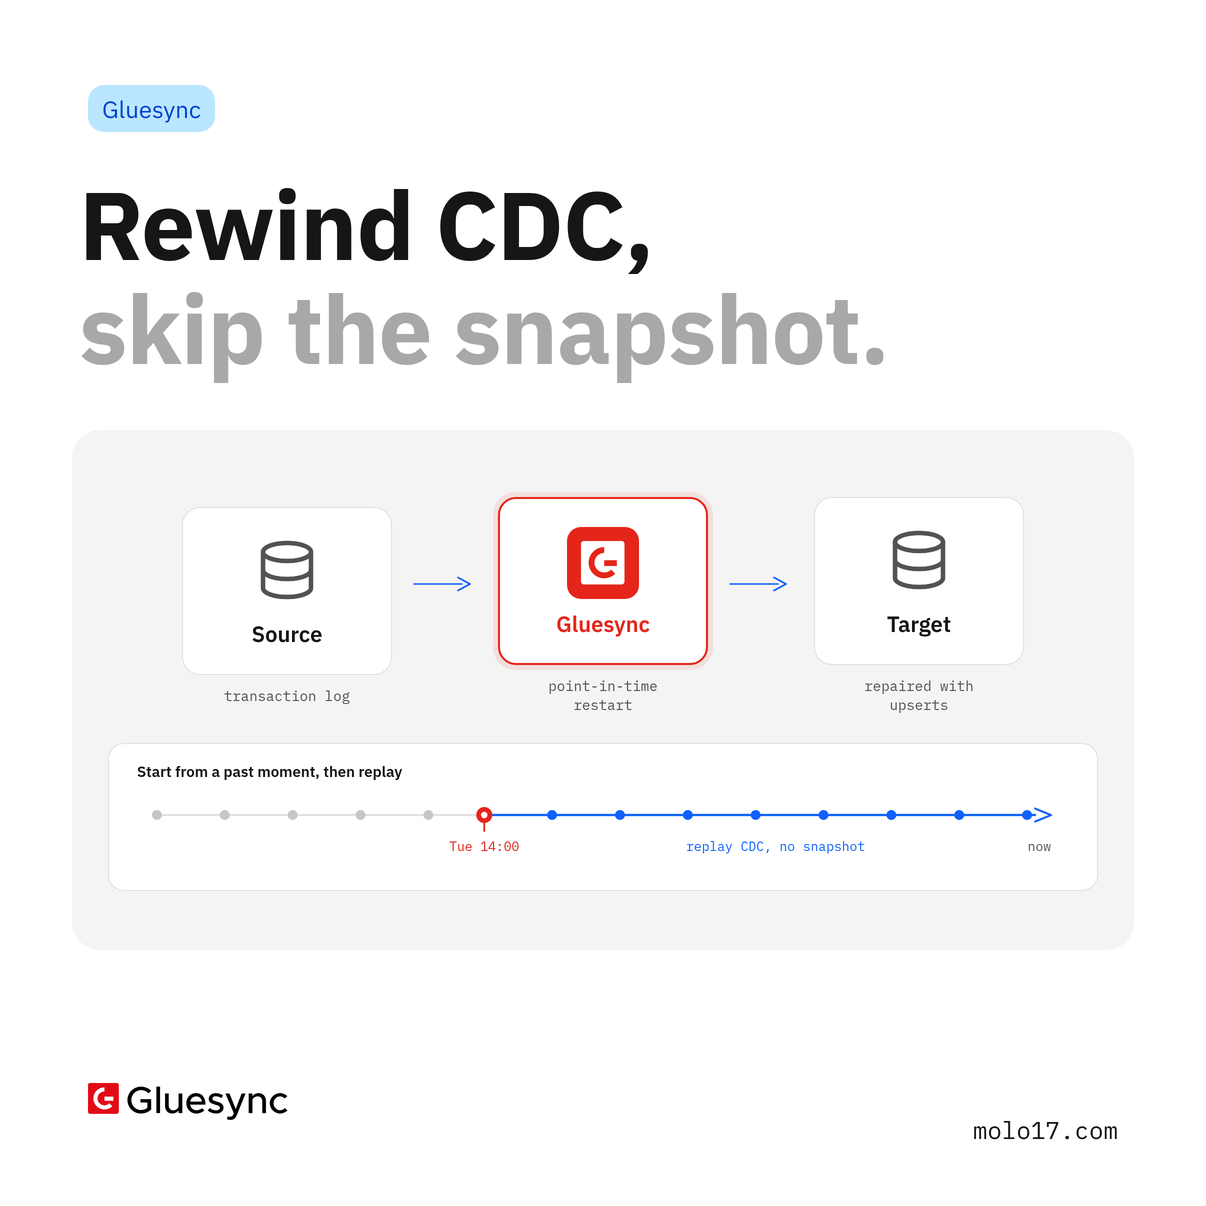
Gluesync 2.3.2 が 2026年11月10日にリリースされました。停止したエンティティは、スナップショットなしで、対応しているソースにおいて、過去の日時から CDC を再開できるようになりました。2つ目の Core Hub サイトが、約1秒遅れでスタンバイし、引き継ぎの準備を整えることができます。Query Studio および Query Forge は、パイプラインによってデータレイクに格納された Parquet、CSV、JSON ファイルを読み取ります。GluesyncはPodman上で動作し、速度テストでは測定結果に基づいてスナップショット設定が選択されます。
前回のリリースでは、Databricksターゲットへの対応を完了し、ログイン方法を追加しました。今回のリリースでは、オンコール担当のエンジニアなら誰もが抱く「火曜日の14:00以降すべてのデータをリプレイできるか?」という疑問に答えます。
特定時点からの再開:CDCを巻き戻し、スナップショットをスキップ
デプロイの失敗、ターゲットテーブルの切り捨て、下流のジョブによって半日分の行が処理されてしまった場合など、任意の時点を選択すれば、Gluesyncはその時点以降のすべてを再実行します。停止したエンティティは、最後のチェックポイントからではなく、過去の日時、またはソースのネイティブ位置からCDCを再開します。その時点以降に行われた変更は、ソースから再度読み込まれ、ターゲットに書き込まれます。
- ・[開始] ダイアログで 特定時点を選択すると、Gluesync は変更が行われる前の各エンティティの再開位置を表示します
- ・ネイティブ位置には、SQL ServerのCDC LSNおよび変更追跡バージョン、IBM iのジャーナルレシーバーとシーケンス、MySQLおよびMariaDBのバイナリログファイルと位置、OracleのLogMinerおよびXStreamのSCN、InformixのLSN、MongoDBの再開トークン、DynamoDBのストリーム位置、ScyllaDBの
cdc$time、Couchbase Eventingのイベントカウンターなどが含まれます。Couchbase DCPおよびCosmos DBは、日付と時刻から再開します - ・再開ポイントと各ターゲットが到達していた位置との間の変更は、挿入競合や変更された列の設定にかかわらず、すべての列のアップサートとして書き込まれるため、再開によってターゲットが修復されます
- ・ソースが保持している最も古い変更よりも古い時点は拒否されます。Oracle XStreamには、その分の履歴にアクセスできるようにする再開期間(時間単位、デフォルトは0)が設定されます
- ・自動化:REST
POST /pipelines/{id}/restart-positions/resolveで位置情報をプレビューし、POST /pipelines/{id}/commands/sync/start-fromでエンティティを再起動します。MCPツールはresolve_restart_positionsおよびstart_sync_from_pointです - ・利用可能性はソースに準じます:Oracleトリガー、Sybaseログリーダー、PostgreSQLおよびYugabyteDB(レプリケーションスロットは過去へ遡れません)、レガシーIBM iの
DSPJRNリーダー、および「Delete Events On Sync Confirmed on」が有効なCouchbase Eventingは、利用不可としてリストされています。「サポートされている統合」の「ポイント・イン・タイム再起動」列に全体像が記載されています
これは同じCDCであり、現在は過去へ遡るようになりました。
災害復旧:必要になる前に準備が整っているセカンドサイト
2つの完全なGluesyncサイトがペアを構成します。アクティブサイトはパイプラインとスケジュールを実行し、スタンバイサイトはアクティブサイトに保存されているすべてのデータのコピーを、約1秒の遅れで保持し、いつでも引き継げる状態を維持します。
- ・ガイド付きセットアップ:Gluesync Controlがインストールされたサイトにおいて、コントロールプレーンから以下の手順を実行します。最初のサイトを起動し、ペアリングコードをコピーして、2つ目のサイトを参加させると、鍵の交換が自動的に行われます。Kubernetes、Docker Swarm、または管理している Compose ファイル上で、
GS_DR_*変数を設定します - ・単一の接続:Core Hub は、6つのデータベース(パイプラインと設定、通知、メトリクス、AIブレイン、データ比較結果、Chronosスケジューラ)をポート1718および1719経由でレプリケートします。オブジェクトストレージや共有ディスクは不要です
- ・条件に応じたフェイルオーバー:デフォルトは手動で、両サイトが正常な状態のときに計画的な切り替えが行われ、アクティブなサイトがダウンした場合は強制的な切り替えが行われます。ウィットネスを使用した自動フェイルオーバーはオプトイン方式です
- ・一度に1つのサイトのみがアクティブ:アクティブだったサイトは、引き継いだサイトのスタンバイとして再参加するため、2つのサイトが同じパイプラインを実行することは決してありません
- ・引き継ぎ後、旧サイトでの未配信の変更が失われたエンティティの処理方法は設定によって決まります。「手動」(デフォルト)ではユーザーが判断するまで保持され、「再同期」では自動的に再同期され、「ギャップの受け入れ再開」ではチェックポイントから処理が再開されます
これは依然としてGluesyncであり、現在は2つのサイトがどちらが主導権を握るかを合意しています。
Lakeファイルのクエリ実行:Parquet、CSV、JSON
Query StudioおよびQuery Forgeは、Core Hub内に組み込まれたDuckDBエンジンと、エージェントがすでに確立している接続を利用して、Gluesyncファイルエージェントが書き込んだファイルを読み取ります。
- ・AWS S3(S3互換エンドポイントを含む)および、WebDAV、WebDAVS、NFS経由のUniversal File Storeエージェント
- ・各エンティティは、
defaultスキーマのテーブルとして読み込まれます。parquet(『path』)、csv(『path』)、およびjson(『path』)はファイルを直接読み込み、files(『folder』)はフォルダの一覧を表示します - ・クエリは読み取り専用です:1つのクエリにつき
SELECTまたはWITHが1つ、最大10,000行または8 MiBの結果 - ・
GLUESYNC_LAKE_MEMORY_LIMIT(512MB)、GLUESYNC_LAKE_THREADS(2)、GLUESYNC_LAKE_MAX_TEMP_DIRECTORY_SIZE(4GB)、GLUESYNC_LAKE_MAX_CONCURRENT_QUERIES(2)、およびGLUESYNC_LAKE_SCRATCH_DIR
Azure Data Lake、Google Cloud Storage、FTP、FTPS、SFTP、SMB、およびCIFSは、現時点では読み込みに対応していません。
Podman、rootful および rootless
Gluesync は、Docker と同様に Gluesync Control によってインストールおよび運用される、Linux 上の Podman で実行されます。gluesync install --runtime podmanを、--rootlessまたは --rootfulを指定して実行してください。Core Hub 2.3.2.0 はコンテナ内で非rootユーザー(uid 1017)として実行されるため、rootless Podman、keep-idおよび runAsUserによるデプロイでは、root が所有するデータフォルダなしで起動されます。Chronos も 0.3.3 以降で同様の動作を行い、Conductor は 0.14.1 以降で Podman を認識します。Gluesync も同様で、root 権限の使用が少なくなります。
スナップショットの自動調整:速度テストにスレッド数の決定を任せる
「開始」ダイアログから「速度テストを開く」を選択すると、エンティティがターゲット側の一時テストテーブルに、同じ列とセカンダリインデックスを持ってコピーされ、2分、5分(デフォルト)、または10分の間に、読み取りおよび書き込み回数、バルクサイズ、ページサイズが試行されます。テスト終了時には、提案されるスナップショット設定と推定コピー時間が表示され、「Faster」ではそれらの設定でエンティティの処理が開始されます。
- ・1 つのエンティティずつ、単一テーブルの SQL ソースから SQL ターゲットへ:SQL Server、PostgreSQL、Greenplum、YugabyteDB、CockroachDB、Oracle、MySQL、MariaDB、SingleStore、Db2 LUW、SAP HANA、ClickHouse、および IBM i
- ・REST
/pipelines/{id}/autotuning、MCP ツールcheck_snapshot_autotuningおよびstart_snapshot_autotuning、ならびにENTITY_AUTOTUNING_FINISHED通知による自動化
YAML または ZIP ファイルからエンティティをインポートする
「新しいエンティティ」ページは、Automator のエクスポートデータを直接読み込みます。「エンティティのインポート」では、最大 100 MB の .yaml、.yml、または .zipファイルを受け付け、それを現在開いているパイプラインのエンティティに変換します。
- ・書き込みが行われる前にすべてのテーブルの検証が行われ、各行には「準備完了」から「未対応」までのステータスが表示されます。ダイアログで、ソーステーブルから完全なフィールドマッピングに至るまで、行を
- ・リレーショナルターゲットの場合、「欠落しているターゲットテーブルを作成する」はデフォルトでオンになっています
- ・ZIPファイルには、保存時にコンパイルされたUDFとカスタムフィールド関数が含まれます
- ・「確認して続行」を押すまで何も保存されず、エンティティは作成済みで停止状態となり、開始の準備が整います。インポート機能はスーパー管理者およびマネージャーが利用可能です
2.3.2 のその他の変更点
- ・Core Hubのアラート:ディスク容量不足のアラート(20 GB未満または空き容量10%未満で「警告」、5 GB未満で「重大」)が、通知、メール、Webhook、およびGluesync Connectに送信されます
- ・セキュリティ:ベースラインセキュリティヘッダー、TLS上のHSTS、CORSの厳格化、デフォルトで72時間後に失効するセッショントークン、およびスーパー管理者およびマネージャーのみが編集・コンパイルできるマッピング関数(GSSD-1185)
- ・サポート:[ログをサポートにアップロード]機能でサポートバウチャーを受け付け、アーカイブをチケットに直接アップロードできるようになりました(
upload_support_logs経由でも可能)MCPツール - ・Validator:Web UIから開始された前回の実行設定が、次回の実行に引き継がれます
- ・チェーン順序:Core Hubは、Web UI、REST、および
suggest_chain_orderを通じて、外部キーを尊重し、親を先にする順序を提案しますMCPツール - ・Spark:1つの
sync_commandMCPツールにより、入力トークンの約半分でエンティティの起動および停止が可能 - ・Query Forge:すべてのクロスエージェント結合戦略がデフォルトで有効
- ・エージェント:AWS S3、Couchbase、Databricks、MariaDB、MySQL、MongoDB、Oracle、PostgreSQL、SQL Server、Vertica、YugabyteDBなどにおける修正および改善
 RSSフィードを取得する