AIエージェントがMCP経由でIBM iデータにアクセスする方法:Mapepireを搭載したIBMのibmi-mcp-server、および読み取り専用のdb_ツールとジャーナルCDCを備えたGluesync 2.3 Core Hub MCP
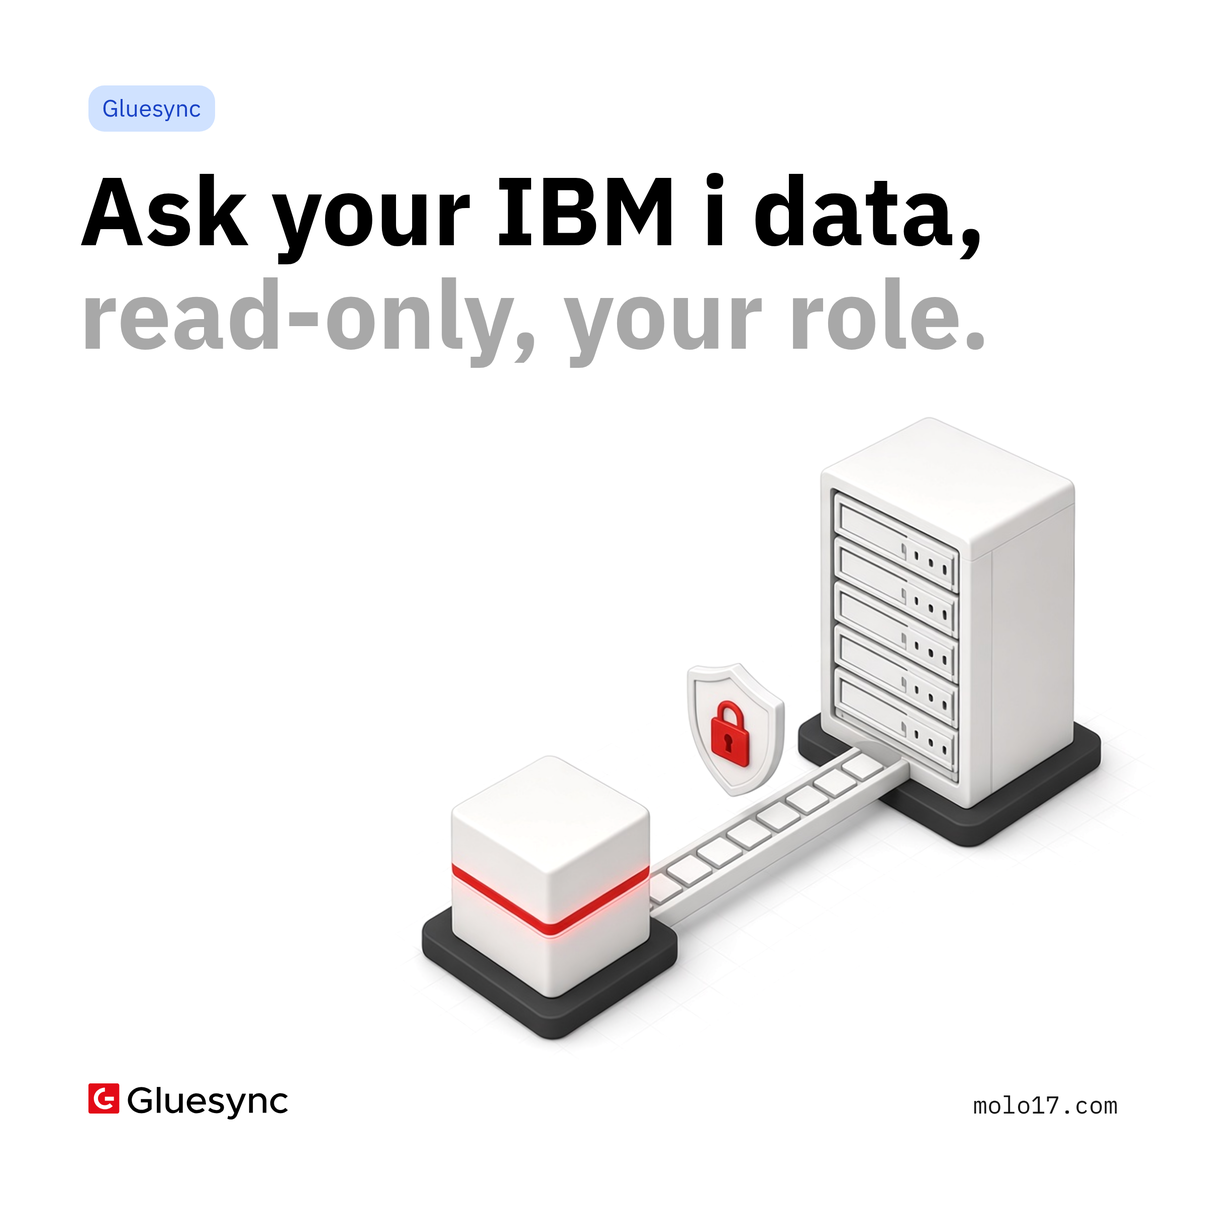
注文、在庫、および会計データは、依然としてIBM i上に保存されています。Model Context Protocol(MCP)は、Claude Desktop、Claude Code、あるいは独自のエージェントなどのAIクライアントがツールを呼び出し、データを読み取るための仕組みです。Gluesync 2.3では、Core Hub MCPサーバーが、接続されたすべてのIBM iエージェントに対し、呼び出し元の権限に基づいて、それぞれ専用の読み取り専用データベースツールを提供します。負荷の高い、あるいは継続的なAIワークロードの場合、GluesyncジャーナルCDCが、AI向けのコピーを常に最新の状態に保ちます。
ここでは、IBM iチームが現在利用できるオプションと、それぞれの使用タイミングについて解説します。
IBM i チーム向けの MCP 概要
MCP はオープンプロトコルです。MCP サーバーはツール(テーブルの一覧表示、クエリの実行、ジョブの開始など)を公開し、MCP クライアント(通常は AI アシスタント)が、それらをいつ呼び出すかを決定します。サーバーは、ツールがどのような処理を実行できるか、またどのユーザーの権限で実行されるかを決定します。IBM i の場合、重要な設計上の判断はサーバー側で行われます。具体的には、どのプロファイルが接続するか、どの SQL が許可されるか、そして本番パーティションにどの程度の負荷がかかるか、といった点です。
現在の状況:IBMのibmi-mcp-serverとMapepire
IBMは、オープンソースのIBM i MCP Serverを公開しています。これは、YAMLで定義したSQLツールを通じてDb2 for iへのアクセスを提供し、IBM i向けのIBM WebSocketデータベースサーバーであるMapepire(yum install mapepire-server、デフォルトポート8076)を介してそれらを実行します。このサーバーには、パフォーマンス監視、セキュリティおよび監査、ジョブ管理、ストレージおよびIFS、データベースオブジェクト向けのツールコレクションが標準で同梱されています。IBM iに関するほぼすべての情報はSQLサービスを通じてクエリ可能であるため、これはシステム管理(アクティブなジョブ、権限、サブシステム、ディスク使用状況など)に非常に適しています。
また、ODBC、jt400、またはMapepireドライバーを備えたコミュニティサーバー、mcp-server-db2iも存在します。
AIアシスタントにIBM iシステム自体の運用を支援させることを目標とする場合、IBMのサーバーが自然な出発点となります。Gluesyncはデータ側、すなわちビジネステーブル、それらを転送するパイプライン、および誰が何を読み取るかに関するガバナンスの面で機能します。
エージェントが本番環境にアクセスする前の3つの確認事項
- 負荷。 エージェントは多くの短いクエリを発行します。それらのクエリはどこで実行され、どの程度の規模になる可能性がありますか?
- 識別情報。 エージェントは共有サービスプロファイルとして接続するのか、それともクエリを実行したユーザーとして接続するのか?
- 最新性と範囲。 エージェントは、あるシステムからのリアルタイムな行データを必要とするのか、それともIBM iとOracle、SQL Server、あるいはクラウド・ウェアハウスを結合した最新のビューを必要とするのか?
Gluesyncは、これらに対して2つのパターンで回答します。ほとんどのチームは両方を活用しています。
パターンA:ジャーナルCDCをAI向けコピーに転送
一部のAIワークロードは、単発の処理ではありません。それらはストリームです。例えば、RAGストアの埋め込みデータの更新、1時間ごとにテーブル全体をスキャンするエージェント、多数のユーザーが同時にアクセスするダッシュボードなどが挙げられます。こうしたケースでは、コピーから読み込みを行います。
Gluesync IBM i CDC は、IBMのネイティブAPIを通じてジャーナルエントリを読み取り、コミットされた変更をPostgreSQL、Snowflake、Google BigQuery、Apache Kafka、MongoDB、Couchbase、Elasticsearch/OpenSearch、さらにはSQL Server、Oracle、Databricks、Microsoft Fabric Open Mirroring、Redis Streamsなどのターゲットに継続的に配信します。ジャーナリングの選択肢に関する背景情報は、システム・ジャーナリング対RPGトリガーおよびネイティブCDC APIによるリアルタイムレプリケーションに記載されています。
AI側は、ターゲットに対して処理を行います。ベクトルパイプラインをターゲットに向けるか、Core Hub MCPのdb_ツールに、同様のガバナンスでターゲットエージェントをクエリさせます。負荷の高い読み取り処理は、それに適した規模のインフラストラクチャで処理され、コピーはIBM iでのコミットされた変更ごとに最新の状態に保たれます。
パターン B:Core Hub MCP による直接管理型読み取り
Gluesync Core Hub は、SSE およびストリーム対応 HTTP を通じて、Core Hub プロセス内に MCP サーバー を組み込んでいます。Gluesync 2.3 では、142 の組み込みツールに加え、接続された各データベース用に生成されたツールが搭載されています。カタログについては、Core Hub MCP ページ をご覧ください。
IBM i のソースおよびターゲットエージェントは、Query Studio において SQL に対応しています。Gluesync 2.3 では、呼び出し元から認識される各 IBM i エージェントに対して、4 つの動的 MCP ツールが提供されます:
list_schemaslist_tablesdescribe_tableexecute_sql
これらの動的データベースツールは、2.3 ではデフォルトで有効になっています(GLUESYNC_MCP_DYNAMIC_DB_TOOLS=falseと設定すると無効になります)。
読み取りが IBM i に到達する仕組み:
- クエリごとに 1 つの専用オンデマンド接続で IBM jt400 JDBC を使用し、これは CDC 接続プールとは別個のものとなります。
- クエリが終了すると接続は閉じられ、IBM i 上にはアプリケーション名
Gluesyncとして表示されるため、オペレーターが確認できます。 - 読み取り専用は 2 段階で強制されます:まずステートメントバリデータによる検証、次に JDBC 読み取り専用接続による制限です。
- 各クエリは10,000行(
GLUESYNC_QUERY_STUDIO_MAX_ROWS)を上限とし、タイムアウトは5分です。 - MCPクライアントはCore HubセッショントークンまたはパーソナルAPIトークンを提示し、すべての呼び出しはその呼び出し元のロールおよびQuery Studioのデータアクセスルールに従って実行されます。読み取り専用トークンでは書き込みツールを呼び出すことはできません。
Db2 for i に関する注意点:Query Studio 経由の EXPLAINは Db2 for i ではサポートされていません。アクセスプランを確認するには、IBM i Access Client Solutions の Visual Explain を使用してください。
同じエージェントパスが Query Forge を支えており、これにより IBM i が JDBC スキーマとして公開されます。これにより、BI ツールや AI as SQL が、他のエージェントを介して IBM i テーブルと結合できるようになります。
直接読み取りは、次のようなアドホックな質問に適しています。「先週後半に遅れて出荷されたこの商品の未処理注文はどれか」、「このファイルの列を説明してください」、「マージンレポート用のSQLを作成し、サンプルを表示してください」。大文字表記により各質問の範囲が明確になり、回答はソースと同じくらい最新の状態になります。
両方のパスにおけるガバナンス
- 呼び出しは呼び出し元として実行され、Gluesync Web UI と同じ RBAC が適用されます。
- 読み取り専用展開では、1 つの設定ですべての書き込みツールを非表示にでき、ツールの利用を許可リストに限定することも可能です。
- パイプラインを変更するツールには確認手順が設けられています。最初の呼び出しにより保留中のアクションが生成され、明示的な確認が行われて初めて実行されます。
- AI Studio Sparkエージェントは、エージェントごとの許可リストが設定された同じCore Hub MCPツールを使用し、すべてのツール呼び出しにはトレースが残ります。
- IBM iテーブルは、その列とキーとともにEnterprise Brainにインデックス化されるため、エージェントは名前や列に基づいて適切なファイルを検索できます。スキーマグラフのリンクはソースカタログの外部キーから取得されますが、Db2 for iについてはソースカタログが読み込まれないため、IBM iテーブルは2.3では外部キー関係なしで表示されます。各チームは、IBM i テーブルに関するビジネスコンテキストを「Enterprise Brain」のメモリとして追加でき、フリーテキスト知識エージェントがこれを利用して質問に回答します。なお、メモリはスキーマグラフ内にリンクを作成することはありません。
 RSSフィードを取得する