CCBはネイティブストレージの不変性ではなく、ソフトウェアベースの不変性を採用しています。有効化手順:
- ストレージ設定で不変性を構成します。
- 関連データに保持ポリシーを適用します。
- 保持ポリシーなしでバックアップされたデータは不変ではありません。

CCBはネイティブストレージの不変性ではなく、ソフトウェアベースの不変性を採用しています。有効化手順:
いいえ。CCBは、ユーザー定義のカスタム暗号化パスワードをサポートしていません。
復元を開始するユーザーアカウントには、有効なCCBライセンスが必要です。
復元先のユーザーはテナント内に存在している必要があります。
システムは、削除されたユーザーから削除されたユーザーへの復元をサポートしていません。
はい。Microsoft 365 グループ/Google 組織単位はサポートされています。
M365 グループおよび Google OU のメンバーも自動的に検出され、バックアップジョブに追加されます。
CCBでは3種類の管理者ロールをサポートしています:
共有ドライブをバックアップ手順に含めるには、次の手順に従ってください:
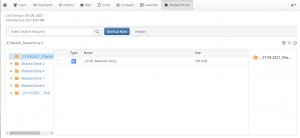
●ドメインに有効なSharePoint/Teams/共有ドライブのライセンスが割り当てられていることを確認してください。
●共有ドライブが表示されない場合は、十分なライセンスがあることと、バックアップアカウントがドライブにアクセスできることを確認してください。
必要な権限:
●読み取りアクセス権:バックアップを実行するには、共有ドライブへの読み取りアクセス権が必要です。
●書き込みアクセス権:復元操作を実行するには、書き込みアクセス権が必要です。使用するサービスアカウントは、バックアップまたは復元対象の各共有ドライブに対して明示的なアクセス権限を持っている必要があります。
このエラーメッセージは、Microsoft 365が使用しようとしているサービスを有効化またはライセンス化していないことを意味します。通常、影響を受けるサービスはOneDriveとSharePointですが、メール、連絡先、カレンダーなどの他のサービスでも発生する可能性があります。修正するには、Microsoft 365でユーザーにライセンスを割り当て、影響を受けたサービスにログインして有効化してください。
いいえ、システムはローカルエージェントなしで動作します。
Climb Cloud Backupは、すべての操作を実行するために、セキュアなOAuthおよびGraph/Google APIを介したクラウドネイティブでAPIベースのアクセスを利用しています。
はい。バックアップおよび復元操作のためのAPIレベルアクセスを有効にするには、初期設定時にClimb Cloud Backup for Google Workspaceバックアップアプリをインストールしてください。
●ライフサイクルポリシーでコスト削減:古いバックアップをAmazon S3 Glacierなどの低コストストレージに移行するライフサイクルポリシーを設定します。これによりストレージコストを大幅に削減できます。
●異なるリージョンやアカウントへのバックアップ:バックアップを異なるAWSリージョンやアカウントに複製することで、災害復旧計画を強化します。これにより、リージョン固有の問題やセキュリティ上の課題からデータを保護できます。
●RTO短縮のためのバックアップ自動化:AWS Backupを使用して頻繁なバックアップ間隔を設定します。1時間ごと、あるいは数分おきの自動バックアップにより、データを迅速に復旧でき、ダウンタイムを最小限に抑えられます。
●リソースにタグを付けて管理を容易に:タグにより関連するバックアップを迅速に識別・グループ化でき、管理やコスト監視が容易になります。これによりレポート作成やコンプライアンスチェックも簡素化されます。
●災害復旧計画を定期的にテスト:DRドリルを自動化し、バックアップと復旧プロセスを確認します。バックアップが機能し、データを迅速に復元できることを確認することで、潜在的な問題を発見・修正できます。
分散環境では、データレプリケーションは、可用性、スケーラビリティ、回復性を確保するための確立されたプラクティスです。ただし、最大のリスクの 1 つは、デスティネーションにレプリケートされたデータがソースの現在の状態を反映していないことです。
データの不整合として知られるこの不整合は、ビジネス上の意思決定のエラーから自動化されたプロセスの誤動作まで、深刻な結果をもたらす可能性があり、システム全体の信頼性を直接損ないます。
複数のノード、データセンター、または分散サービスで運用されている組織では、テクノロジーガバナンスの原則に従って堅牢でスケーラブルで一貫性のあるアーキテクチャを構築するには、レプリケートされたデータの整合性を最優先事項にする必要があります。
📌 このずれの原因は何ですか?
➡️ レプリケーション・モデルの設計が不十分
➡️ ノード間のレイテンシーが高い
➡️ 書き込み競合の処理におけるエラー
➡️ 検証と整合性監査の欠如
📌 このリスクを軽減するにはどうすればよいでしょうか?
➡️ 効率的なトポロジーの設計
➡️ 整合性とリカバリの明確なポリシー
➡️ 運用の継続的な監視とトレーサビリティ
➡️ 技術アーキテクチャとビジネス目標の整合性
今日、企業のデータは戦略的資産です。
このため、複製されるものが原点に忠実であることを保証することは、事業継続性、制度的セキュリティ、デジタルの持続可能性のための構造的条件です。
SC//HyperCoreは、コンテナのシームレスなプログラムによるデプロイを可能にします。SC//HyperCore上でコンテナを実行するには、コンテナ最適化OSと任意のコンテナランタイム(通常はDocker、またはKubernetes環境ではcontainerdやCRI-O)をデプロイするだけです。
●REST APIとcloud-initのサポートにより、ユーザーがコンテナ化されたワークロードを実行する方法が根本的に改善されます
●オペレーティングシステム、コンテナランタイム、ワークロードコンテナの自動インストールを実現
●標準化を通じて一貫した変更管理とより信頼性の高い更新を可能にします
●バックアップ自動化にマネージド ID を使用する: スクリプトに資格情報を埋め込む代わりに、Azure のマネージド ID を使用して、自動化されたエクスポート/インポート操作のためにストレージ アカウントへの安全なアクセスを許可します。
●バックアップと復元のパフォーマンスを監視する:Azure Monitorを使用してバックアップ/復元操作のパフォーマンスを追跡し、障害や異常な長時間動作に対するアラートを設定します。
●地理的に冗長化されたストレージを賢く活用する:RA-GRSは耐久性に優れていますが、一部の高度なセキュリティシナリオでは、パフォーマンスとコストを最適化するためにゾーン冗長ストレージ(ZRS)またはローカル冗長ストレージ(LRS)の使用が有益です。
●機密データベースのバックアップ暗号化を有効化: 透過的データ暗号化 (TDE) でデータベース バックアップを暗号化します。セキュリティ強化のため、Azure Key Vault に保存された顧客管理キー (CMK) を使用します。
●重要なバックアップに不変ストレージを組み込む: 誤削除やランサムウェアから保護する長期バックアップに適用します。これにより、保持期間中バックアップが改ざんされないことが保証されます。
●増分データアップロードによる最適化: 大規模なデータセットを繰り返しアップロードする代わりに、変更されたデータや新規データのみを転送する増分アップロード戦略を導入します。これにより帯域幅の使用量が削減され、アーカイブ処理が高速化されます。
●メタデータ管理にBlob Indexerを活用: アーカイブ済みデータの検索を簡素化するため、Azure Blob Indexerを統合し、アーカイブ前にファイルに検索可能なメタデータを付加します。これにより、ユーザーはデータセット全体をスキャンすることなく、関連データを迅速に特定・取得できます。
●アーカイブ前の圧縮:アーカイブ層へのアップロード前にGzipやParquet形式などの圧縮ツールを使用します。圧縮により、特にログやテキスト主体のデータセットにおいて、大容量ファイルのサイズを最小化し、ストレージコストを大幅に削減できます。
●災害耐性のあるアーカイブにはRA-GRSを採用:高い耐久性と災害復旧が必要な場合は、Read-Access Geo-Redundant Storage(RA-GRS)を選択します。これによりアーカイブデータが複数リージョンに複製され、リージョン障害時でもアクセスが可能になります。
●優先度の高いデータはCool層に事前配置:数週間以内に取得が必要となる可能性のあるアーカイブデータは、Archive層へ移動する前にCool層に事前配置してください。これにより高コストで遅延の多い優先取得料金を回避しつつ、可用性とコストのバランスを保てます。
●災害復旧テストを自動化し、現実的なシナリオをシミュレートする:理論上のDR計画だけに頼らず、現実的な障害シナリオをシミュレートする自動テストスクリプトを作成してください。インフラストラクチャレベルとアプリケーションレベルの両方の耐障害性を検証することを確認してください。
●異なるIAMロールを用いたクロスリージョンレプリケーションの導入:マルチリージョンDRは強力ですが、レプリケーションパイプライン(例:S3クロスリージョンレプリケーション)には最小限の権限を持つ専用IAMロールを設定し、侵害された認証情報の影響範囲を制限してください。
●不変バックアップとランサムウェア対策を活用:S3オブジェクトロック、AWS BackupのVault Lock、またはN2Wのような不変バックアップをサポートするサードパーティ製バックアップソリューションを使用し、改ざんや削除を防止する。
●アプリケーションレベルのチェックポイント機能を統合:ステートフルなアプリケーションの場合、Amazon DynamoDB StreamsやS3バージョン管理などを使用してアプリケーション状態をチェックポイントするDR手順を設計する。これによりデータ損失を低減(ヒント:N2Wはアプリケーション一貫性を保持)。
●DNSヘルスチェックによるネットワークフェイルオーバー設計:AWS Route 53ヘルスチェックと遅延ベースルーティングを組み合わせ、DRリージョンの健全なエンドポイントへトラフィックを自動リダイレクト。障害時の手動介入を最小化。
●S3 オブジェクトロックを使用して不変のバックアップを実装する:これにより、ランサムウェアが環境を侵害した場合でも、バックアップの改ざんを防止できます。
●認証情報のローテーションを自動化する:AWS Secrets Manager または IAM ポリシーを使用して、AWS アクセスキーとシークレットキーを頻繁にローテーションします。これにより、攻撃者にとっての機会を制限できます。
●機密性の高いワークロードを分離する:個別のアカウントまたは仮想プライベートクラウド (VPC) を使用して、ワークロードを分離するように AWS 環境を設計します。これにより、ランサムウェア攻撃が発生した場合の攻撃範囲を制限できます。
●バックアップの異常検出を設定する:AWS Backup Audit Manager を使用して異常検出を設定し、突然の削除や異常なバックアップパターンなどの予期しない変更が発生したときにチームメンバーに警告を送信します。
●AWS WAF を有効にして悪意のあるトラフィックをブロックする:AWS Web Application Firewall (WAF) を使用して、ウェブアプリケーションを保護します。SQL インジェクションや悪意のあるペイロードなどの一般的な攻撃ベクトルをブロックするルールを設定します。
●データベースクローンによる迅速な復旧シナリオ: 完全な復元ではなく、テストやトラブルシューティングにはデータベースクローンを検討してください。クローン機能により、ダウンタイムなしで既存のRDSインスタンスのコピーを作成でき、実験やデバッグを迅速に行えます。
●スナップショット整理にタグを活用:RDSスナップショットに「本番環境バックアップ」「コンプライアンスアーカイブ」「移行準備」など目的を明示する一貫したタグ付けを実施。タグ付けによりスナップショット管理が効率化され、適切なスナップショットの検索が容易になります。
●重要インスタンスの削除保護を有効化:重要データを含むRDSインスタンスには常に削除保護を有効化し、誤削除を防止。この簡単な手順で、スナップショットからの復旧作業時間を大幅に削減できます。
●読み取りレプリカとスナップショットを組み合わせたハイブリッド復旧戦略: 読み取りレプリカをスケーラビリティだけでなく、災害復旧の追加レイヤーとして活用します。緊急時には、読み取りレプリカをスタンドアロンデータベースに昇格させることが可能です。
●ライフサイクルポリシーによるスナップショットストレージの最適化: Amazon Data Lifecycle Manager (DLM) を使用して、RDSスナップショットの保持と削除を自動化します。これにより、不要なストレージコストを防止しつつ、復旧に必要なバックアップが確実に利用可能になります。
EspressReport は、Java EE (Enterprise Edition) の標準技術に基づいて構築されたレポートツールであるため、Java EE アプリケーションサーバー環境との連携は完全に可能です。EspressReport は Java エコシステムと密接に連携しているため、Java EE/Jakarta EE 環境での利用は設計上の前提となっています。
EspressReport を Java EE 環境で利用する際の主なポイントと連携方法は以下の通りです。
EspressReport のサーバーコンポーネントである EspressReport ES (Enterprise Server) は、標準的な Java EE の Web アプリケーションとして提供されます。
Java EE 環境で開発された独自のアプリケーションから EspressReport の機能を利用する方法はいくつかあります。
Climb Cloud Backup for Google Workspace (CCB4GWS) のようなGmail 自動バックアップツールを使用すると、選択した Gmail データまたはすべての Gmail データを、指定した保存場所に自動的にバックアップできます。
Climb Cloud Backup for Google Workspace
例えば、Climb CloudBackup for Google Workspace は、Gmail やその他の主要な Google Workspace サービスに保存されているデータの完全バックアップとデータ保護をサポートします。CCB4GWSは、メールとその関連メタデータ(添付ファイルを含む)だけでなく、Google ドライブのデータ、連絡先、カレンダーの予定も自動的にバックアップできます。
Gmail データ保護を柔軟かつきめ細かく制御できるように、Climb CloudBackup for Google Workspace には、増分バックアップ、バックアップ対象のフォルダやラベルを個別に選択する機能、きめ細かな復元オプションなどの機能が搭載されています。また、ロールベースのアクセス制御によるバックアップデータの保護、AES 暗号化、監査ログ、スケジュール設定も可能です。
Climb Cloud Backupのもう一つの利点は、Amazon S3、Wasabi、Azure Blob Storageなどを含む様々なクラウドストレージプラットフォームと連携し、バックアップデータの保存場所を幅広く選択できることです。この柔軟性により、大量のGmailデータをバックアップする企業にとって重要な、費用対効果の高いGmailバックアップオプションを見つけるのに役立ちます。また、このソリューションは、Gmailバックアップのストレージとプロセスに対する強力なセキュリティと正確な制御により、コンプライアンス要件の遵守にも役立ちます。
EspressReport機能から、エンタープライズ向けのWebアプリケーションにおける以下のような利用が想定されます。
| 業界 | 想定される利用シーン | 特徴的な要件 |
| 金融 | 顧客向けの取引明細書、残高報告書、契約書類、法定帳票などの生成。 | 高い信頼性とセキュリティ、膨大なデータを処理するパフォーマンス、複雑なレイアウトの再現。 |
| 製造 | 受注伝票、出荷伝票、品質管理レポート、サプライヤー向けの各種帳票の生成。 | 帳票のリアルタイム出力、外字やバーコードへの対応、PDFでの正確な印刷保証。 |
| 公共 | 住民や職員向けの申請書、証明書、統計レポート、通知書などの発行。 | 公文書としての正確なフォーマット、アクセシビリティへの配慮、長期的なメンテナンス性。 |
Wasabiは、学術情報ネットワークSINETに接続するためのサービスを提供しています。これにより、大学や研究機関は、SINETの高速かつセキュアな閉域網を通じて、Wasabiのクラウドストレージに安全かつ高速にアクセスできるようになります。
接続方法の概要
詳細な手順
より詳細な手順については、以下の資料をご参照ください。
このガイドには、接続に必要な情報や設定手順が詳しく解説されています。
留意事項
ご不明な点がありましたら、お問い合わせください。
StarWind VSANをKVMベースの環境にデプロイする際の基本的な流れは、Controller Virtual Machine (CVM) を利用することが鍵となります。
CVMは、StarWind VSANのソフトウェアが動作するLinuxベースの仮想アプライアンスであり、これをKVMホスト(物理サーバー)上にデプロイすることで、ホストのローカルストレージを共有ストレージプールとしてまとめ、iSCSIターゲットとしてホスト側へ提供します。
以下に、一般的なKVM環境(例:Proxmox VE、oVirt/OLVMなど)でのデプロイ手順の概要を、ステップごとに説明します。
このCVMアプローチにより、StarWind VSANはKVM環境でハイパーコンバージドインフラストラクチャ (HCI) を実現し、ローカルストレージのみで高可用性を提供します。
StarWind VSANは、KVMをベースとした様々なハイパーバイザーソリューションをサポートしています。
これは、StarWind VSANが、Controller Virtual Machine (CVM) と呼ばれるLinuxベースの仮想マシンとしてデプロイされ、iSCSIストレージとしてKVMホストに高可用性ストレージを提供する方式を採用しているためです。
具体的なKVMベースのソリューションとしては、以下のようなものが挙げられます: