投稿者「climb」のアーカイブ

SalesforceとJakarta EE(Tomcatを含む)との連携手法について

Tomcatを含むJakarta EE(旧Java EE)とSalesforceとの連携手法はいくつかあります。

Jakarta EEはJavaベースのエンタープライズアプリケーションプラットフォームであり、JavaのプログラムからSalesforceのAPIを利用することで連携が可能です。Jakarta EEにはTomcat以外の製品ではRed HatのJBoss, Oracle WebLogic, IBM WebSphereなどがあります。

連携の主要な手法 🤝


主な連携手法として、Salesforceが提供するAPIを利用するのが一般的です。Jakarta EE環境で動作するJavaアプリケーションから、これらのAPIを呼び出します。

  • REST API (推奨) 🌐
    • Salesforceのデータに対してCRUD(作成、読み取り、更新、削除)操作をHTTPリクエストを通じて実行する、現代的な連携方法です。
    • Jakarta EEアプリケーションでは、標準のHTTPクライアントライブラリ(例えばjava.net.http.HttpClientやサードパーティのライブラリ)を使用してRESTfulなリクエストを構築・送信します。
    • OAuth 2.0などの認証設定を行い、Salesforceへのアクセス権限を取得する必要があります。
  • SOAP API 📜
    • WSDL(Web Services Description Language)ファイルを使用してSOAPメッセージを交換する方式です。
    • SalesforceからWSDLをダウンロードし、Javaのツール(例:Apache CXF、JAX-WS)を使ってSOAPクライアントのスタブコードを生成して利用します。
    • Jakarta EE環境では、JAX-WSなどの技術を利用してSOAP通信を行います。


認証とライブラリ 🔑


連携を実現するためには、適切な認証設定とライブラリの利用が重要です。


認証


SalesforceとのAPI連携では、セキュリティ確保のために接続アプリケーションを作成し、OAuth 2.0フロー(例:認証コードグラント、クライアントクレデンシャルなど)を利用してアクセストークンを取得するのが標準的な手順です。


Java/Jakarta EEでの利用


  • REST APIの場合:
    • JSONデータの処理のためにJacksonGsonなどのライブラリを組み合わせて利用することが多いです。
    • 認証情報の管理やトークンの自動更新を行うユーティリティを自前で実装するか、それらをサポートするJava用のSalesforce向けSDK(Salesforce公式またはコミュニティ提供のもの)があれば利用を検討します。
  • SOAP APIの場合:
    • 前述の通り、WSDLから生成されたJavaコード(スタブ)を利用して、SOAPリクエストを抽象化されたメソッド呼び出しとして実行します。

連携したい具体的なSalesforceの機能や、Jakarta EE環境のバージョン、利用したいフレームワーク(例: Spring Boot, MicroProfileなど)によって、最適な実装アプローチは変わってきます。

SalesforceとJakarta EEを連携させる上で、主要なAPIであるREST APISOAP APIには以下のような違いがあります。

結論として、特別な理由がない限り、新規の連携にはよりシンプルで柔軟なREST APIが推奨されます。


🆚 REST API と SOAP API の比較


項目 REST API (Representational State Transfer) SOAP API (Simple Object Access Protocol)
通信方式 HTTPの標準的なメソッド (GET, POST, PUT, DELETEなど) を利用。 SOAPプロトコルを使用し、通常はHTTP/HTTPS経由で通信。
データ形式 主に JSON (JavaScript Object Notation) を使用。XMLも利用可能。 XML (Extensible Markup Language) のみを使用。
構造 リソース指向 (URLでリソースを識別)。軽量でシンプル。 メッセージ/サービス指向。厳格で複雑なメッセージ構造を持つ。
処理速度 メッセージが小さく、オーバーヘッドが少ないため、高速 XMLパース処理などにより、RESTよりも遅い傾向がある。
セキュリティ HTTPS (SSL/TLS) を使用。OAuth 2.0認証が主流。 HTTPS (SSL/TLS) を使用。WS-Securityなどの標準的なセキュリティ仕様も利用可能。
連携難易度 シンプルで、容易に実装できる。 WSDLからのスタブ生成が必要で、複雑になることがある。
利用ケース Webやモバイルアプリ連携、リアルタイム性の高いデータ操作など、ほとんどの新規連携 厳格な仕様が求められるエンタープライズ統合、旧来のシステムとの連携。

💡 Jakarta EE 環境での適用


Jakarta EEアプリケーションからSalesforceを操作する場合、それぞれのAPIは以下のように利用されます。


1. REST API の場合 (推奨)


  • HTTPクライアント: Jakarta EE環境では、標準のJava HTTPクライアント(java.net.http.HttpClient)や、MicroProfile Rest Clientなどのライブラリを利用し、JSON形式のデータを送受信します。
  • データ処理: Jakarta JSON Processing (JSON-P)Jakarta JSON Binding (JSON-B) などの標準仕様、またはJackson/Gsonなどのライブラリを使って、JSONデータをJavaオブジェクトにマッピング(シリアライズ/デシリアライズ)します。
  • 認証: OAuth 2.0フローを実装し、取得したアクセストークンをHTTPリクエストのヘッダーに含めて送信します。


2. SOAP API の場合


  • WSDLとスタブ: SalesforceからダウンロードしたWSDL(Web Service Description Language)ファイルに基づき、Javaのツール(例:JAX-WS RI、Apache CXF)でクライアント側のスタブコード(Javaクラス)を生成します。
  • SOAP通信: Jakarta EEのJakarta XML Web Services (JAX-WS) などの技術を利用し、生成されたスタブクラスのメソッドを呼び出すことでSOAP通信を実行します。
  • 複雑性: 厳格なXMLスキーマに従うため、RESTに比べて設定やコーディングが煩雑になる傾向があります。
選択 特徴と理由
REST API ほとんどの新規連携に最適です。軽量で高速、実装もシンプルで、JSON形式はJakarta EEアプリケーションでのデータ処理に適しています。
SOAP API 厳格なトランザクション管理や、WSDLベースの厳密な契約(インターフェース定義) が必要な場合に限られます。特に理由がなければRESTを選択すべきです。


最終的な確認はそれぞれのJakarta EE対応製品メーカにお尋ねください。
EspressReport とSalesforceの連携による機能拡張の可能性について

EspressReportはJavaベースのBI・レポーティングツールであり、これをSalesforceと連携させることで、Salesforceの標準機能では実現が難しい高度なデータ分析、複雑なレポーティング、および他システムとのデータ統合が可能になります。

この連携で実現できる主な機能と価値は以下の通りです。


📈 1. Salesforceデータの高度なレポーティングと可視化


EspressReportの持つ柔軟なレポートデザイン機能を利用し、Salesforceデータに対して、標準レポート機能の限界を超えた詳細な分析と表現を提供します。

    • 複雑なレイアウトとフォーマットの実現:
      • Salesforceのオブジェクトデータ(商談、アカウント、ケースなど)を基に、請求書、納品書、契約書などの定型業務文書や、企業固有のブランドガイドラインに沿ったピクセルパーフェクトなレポートを作成できます。
      • 複数レベルのグルーピング、サマリー、カスタム計算フィールドを柔軟に配置できます。
    • 高度なグラフ・可視化:
      • Salesforceの標準ダッシュボードよりも多様なグラフタイプや対話性(ドリルダウンなど)を持つBIダッシュボードを構築し、営業実績やサービス状況の可視化を強化します。
    • 多様な出力形式への対応:
      • レポートをPDF、Excel、HTML、CSVなど、Salesforceの標準機能以上に多様なフォーマットで出力できます。特に、オフラインでの利用や、他システムへのデータ受け渡しが容易になります。


🤝 2. 他システムとのデータ統合分析(真のBI)


Salesforceデータと社内の他システムデータをEspressReport上で結合し、ビジネス全体を俯瞰する複合的な分析を実現します。

  • CRMとERP/会計データの統合:
    • Salesforceの商談データと、外部ERPシステムの実際の売上・在庫データを統合し、「商談の予測精度リードから受注までの正確なROI」などを分析するレポートを作成できます。
  • クロスプラットフォームなレポートハブ:
    • EspressReportを「データソース横断的なレポートポータル」として機能させ、利用者はSalesforce、データベース、ファイルなど、複数のソースにまたがる情報を一元的に閲覧できます。


⚙️ 3. レポート生成と配信の自動化


Salesforceのデータを定期的に取得し、業務に必要なレポートの生成・配信プロセスを自動化します。

  • 定期レポートの自動配信:
    • 「毎週月曜日の朝9時に、全営業担当者の最新パイプラインレポートをPDFで生成し、マネージャー陣にメールで自動送信する」といった高度なスケジューリングと配信設定が可能です。
  • リアルタイムまたはバッチ処理の選択:
    • 必要に応じてSalesforceの最新データをリアルタイムで取得したレポート、または大量データを夜間にバッチ処理で取得・集計したレポートを作成し、SalesforceのAPI負荷管理にも役立てることができます。
  • ドリルスルー分析:
    • サマリーレポートから、Salesforceの具体的なレコード(例:アカウント詳細)へ直接ドリルスルーできる機能を提供することで、分析からアクションへの移行を迅速化できます。


まとめ


EspressReport+Salesforceの連携は、【高度なカスタマイズ性、データ統合、および配信自動化】という点で、Salesforceのネイティブなレポート機能に対する強力なBIバディ(相棒)として機能します。

特に、企業固有の複雑なレポート要件複数の基幹システムデータを含む統合ダッシュボードが必要な場合に、この連携が有効となります。

参考サイト:

SOQLを使ったSalesforceデータのレポート作成


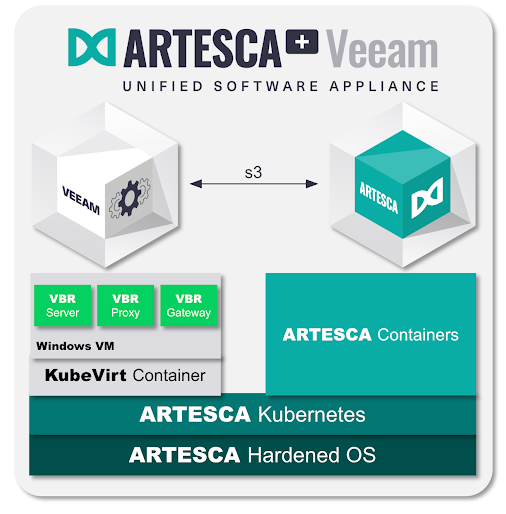
ScalityのARTESCA+Veeam ソリューション vs. Rubrik

ScalityARTESCA+VeeamソリューションRubrikキラーとされる主な理由は、バックアップデータの保護とランサムウェア対策における強固なアーキテクチャコスト効率にあります。特に、イミュータビリティ(不変性)の実現方法シンプルな運用Rubrikとの差別化要因として強調されることが多いです。


🛡️ Rubrikキラーとされる主要なポイント


Scality ARTESCAとVeeamの連携ソリューションは、以下の点でRubrikの提供する統合型バックアップ・リカバリソリューションと競合し、優位性を示すとされています。


  • 真のデータ不変性とランサムウェア対策の強化:
    • ARTESCAは、オブジェクトストレージのイミュータビリティ機能(S3 Object Lock)を利用して、バックアップデータに対する変更や削除を不可能にします。これは、単なるファイルシステムのロックよりも、ストレージレベルでデータ保護を確実にする手段です。
    • Rubrikも不変性を提供しますが、ARTESCA+Veeamの構成は、ストレージ層とバックアップアプリケーション層が独立しているため、多層防御の観点からより堅牢であると見なされることがあります。
  • 柔軟な導入とコスト効率:
    • ARTESCAはSoftware-Defined Storage (SDS)として提供されるため、標準的なx86サーバー上で動作します。これにより、特定のアプライアンスへの依存を避け、ハードウェア選択の自由度が高まります。
    • 一般的に、Rubrikのような統合アプライアンスと比較して、コスト効率の高いスケールアウト構成を実現しやすいとされます。ストレージの増設も柔軟に行えます。
  • Veeamとの緊密な統合と運用の一貫性:
    • Veeamはバックアップ市場で広く利用されており、ARTESCAはVeeamのオブジェクトストレージリポジトリとして緊密に統合されます。
    • 既にVeeamを利用しているユーザーにとっては、バックアップ戦略を変えることなく、セキュアなストレージ層を追加するだけで済み、運用の複雑さを最小限に抑えられます


🆚 競合としてのポジショニング


ARTESCA+Veeamの構成は、『ベスト・オブ・ブリード』戦略(各分野で最適な製品を選択して組み合わせる)を採用したい企業にとって魅力的な選択肢となります。

特徴 Scality ARTESCA + Veeam Rubrik
アーキテクチャ Software-Defined Storage (SDS) + バックアップソフトウェア 統合アプライアンス (ソフトウェアとハードウェアの統合)
ハードウェア 標準的なx86サーバー、柔軟な選択肢 特定の認定済みアプライアンス
不変性 (Immutability) オブジェクトストレージのS3 Object Lockによる強固なストレージ層の保護 ソフトウェアおよびファイルシステムレベルの保護 (独自の機能)
コスト構造 ハードウェアとソフトウェアを分離でき、コスト効率の高いスケールアウトが可能 アプライアンスベースの初期投資とスケーリングコスト
既存環境 Veeamユーザーにとって導入が容易 独自の管理インターフェースとエコシステム

これらのポイントから、Scality ARTESCA+Veeamソリューションは、既存のVeeamインフラストラクチャを最大限に活用しつつ、ランサムウェアからデータを保護するための堅牢でコスト効率の高いオブジェクトストレージ層を求める企業にとって、Rubrikに対する強力な代替案として位置づけられています。

AWSの停止後、バックアップとDRプロセス全体を再構築するにはどうすればよいか!?

先日は、BDRチームだけでなく、怒りの顧客メールや受信トレイの混乱に目を覚ました幹部からも、この質問を何十回も聞いたに違いありません。

それを理解しています。AWSがこのようにダウンすると、本能的にすべてに疑問を抱く。数字を見てください:Amazon自体は1時間あたり~$73Mを失ったと伝えられています。初期のレポートによると、Snapchat、Fortnite、Zoom などの企業は、時給 500 ドル前後のヒットを記録しました。これは、保険や訴訟費用が発生する前に、ダウンタイムとして 7 桁、場合によっては 8 桁のダウンタイムになります。

そうです、パニックは理解できます。しかし、人々に言い続けたことは次のとおりです。
ゼロから再構築する必要はありません。ただ、より良く実行する必要があります。

実際のところ、ほとんどのチームは、リージョン全体の停止を計画していませんでした。不注意だったからではなく、そのような出来事がほとんど理論的に感じられたからです。

復元の約 80% は単純で、いくつかのファイルが削除され、場合によっては重要なインスタンスが 1 つか 2 つあります。ほとんどのクラウドチームは、これらを手動で処理します(N2WSなどのツールを使用して次に進むチームもあります)。

しかし、今回は違った。すべてが一度にダウンした場合、「手動回復」が実際にいかに脆弱であるかが明らかになりました。

何を復元すればよいか推測する必要はありません。その場で優先順位を把握する必要はありません。手順書が重要です。

また、データを回復するだけでなく、サブネット、ルーティングテーブル、セキュリティグループなど、ネットワークスタック全体を回復しました。すでにクローンが作成されており、起動する準備もです。

N2WSでこれらのシナリオを簡単に構築してテストできるようになり、回復が筋肉の記憶になりました。

あるグローバルなSaaSのユーザは、その後次のように語っています。

「幸いなことに、US-East-1がダウンしたときに、地域を越えた回復シナリオはすでに整っていました。私たちは計画をトリガーしただけで、約15分で完全な環境を別の地域に稼働させました。」

それがレジリエンスとはそういうものです。

先週教えてくれたことが 1 つあるとすれば、最高の DR 計画は最も複雑ではなく、考えすぎずにプレッシャーの下で実際に実行できる計画であるということです。

Climb Cloud Backup Ver8.4

Climb Cloud Backup 8.4 リリースを発表できることを嬉しく思います。本リリースでは、バックアップ計画管理のための強化された API 機能、監査ログの改善、ライセンス管理のアップグレード、およびウェブコンソールのナビゲーションの効率化を実現しています。

バックアップ計画管理の強化されたAPI

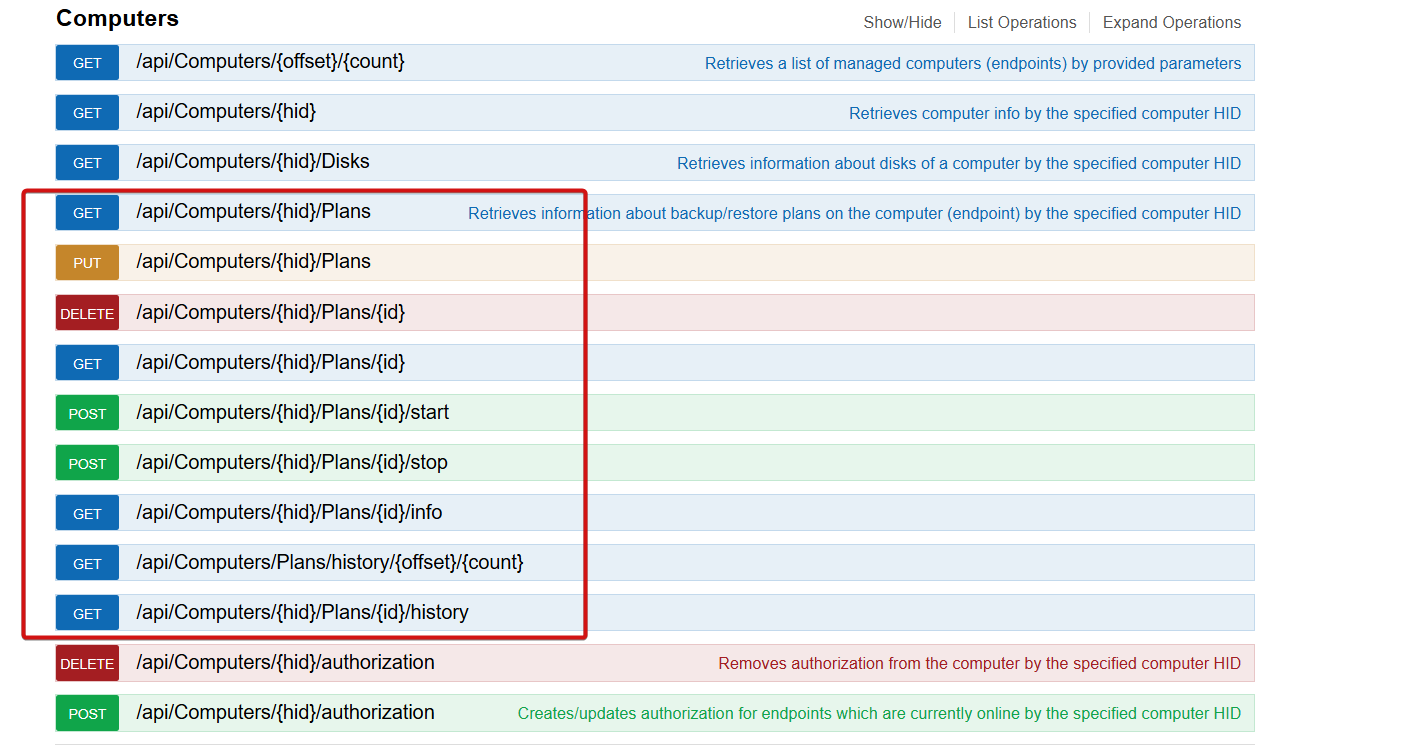
本リリースでは、自動化の簡素化、スケーラビリティの向上、他システムとの連携強化を実現します。バックアップ計画へのAPIアクセス導入により、MSPやIT管理者はバックアップ計画の作成、読み取り、変更、削除、開始、停止が可能となり、時間の節約と人的ミスのリスク低減につながります。

API enhancements

監査ログの更新によるセキュリティ強化

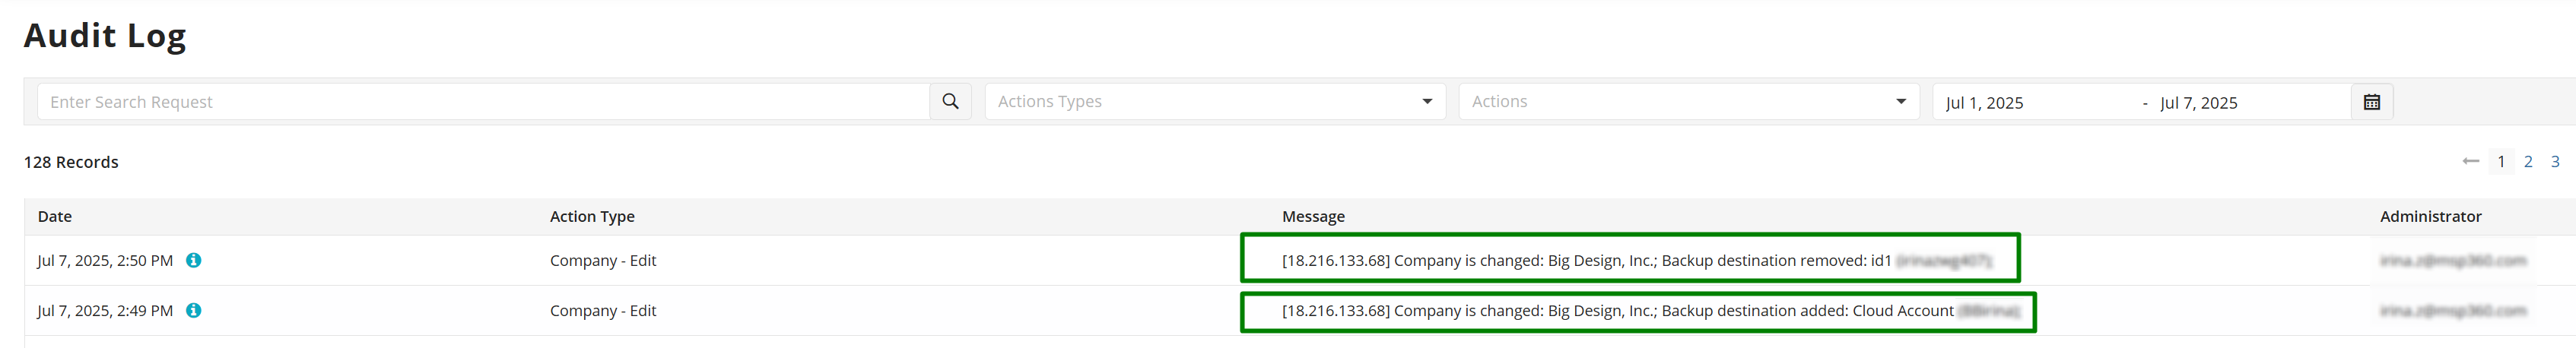
今回のリリースでは、監査ログの更新を導入します。これにより、ユーザーはバックアップ先の変更を追跡できるようになりました。この更新は、バックアップ戦略における透明性、セキュリティ、説明責任を維持するために重要です。実施された変更内容と変更を行ったユーザーを追跡するのに役立ちます。これは監査と規制順守の確保において極めて重要です。

Enhanced Security with Audit Log Updates

右クリックで表示される新メニュ

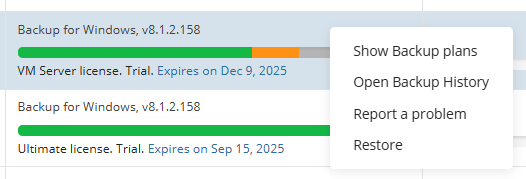
コンピューターページで対象エンドポイントを右クリックすると表示される新メニューから、バックアップと復元プランへのアクセス、および特定エンドポイントのバックアップ履歴への直接移動が可能になりました。この更新により、ウェブコンソールの重要セクションへ迅速にアクセスでき、時間の節約につながります。最近追加されたエンドポイントの場合、このメニューにはエンドポイントの認証オプションも含まれます。

Right-click menu


Climb Cloud Backupにおける会社レベルでの宛先ごとのストレージ制限の設定

CCBでは会社単位で保存先(バケットまたはローカル)ごとにストレージ制限を設定できる新機能をリリースいたします。

本リリースにより、ローカルストレージとクラウドストレージに対して会社ごとに異なる制限を個別に適用可能となります。これにより、クラウドストレージにはより厳格な制限を設定しつつローカルストレージの柔軟性を維持することで、より精密かつ細分化されたストレージコスト管理を実現します。

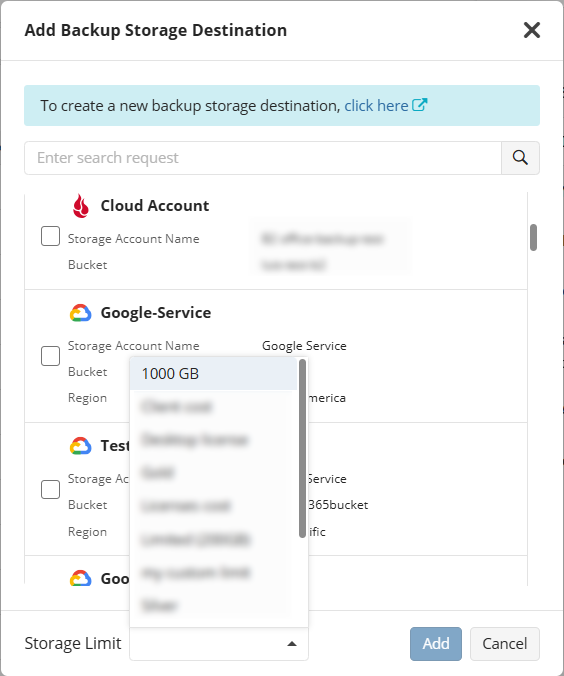
ストレージ制限付きの新規バックアップ先を追加、または既存のバックアップ先を編集するには、組織タブに移動し、会社セクションを開きます。左側のプラスアイコンをクリックして新規バックアップ先を追加するか、編集ボタンをクリックして既存のバックアップ先を変更します。表示されるスライドインパネルでバックアップ先を選択してください。

Storage Limits

Starwind Virtual SANとHyper-Vの連携について

StarWind Virtual SAN (VSAN) は、Microsoft Hyper-V 環境と連携し、ハイパーコンバージドインフラストラクチャ (HCI) の実現を可能にするソフトウェア定義ストレージ (SDS) ソリューションです。

これは、従来の共有ストレージ(SAN/NAS)を使用せずに、Hyper-Vホストサーバーの内蔵ストレージを論理的にプールし、高可用性(HA)と共有ストレージ機能を提供します。


StarWind Virtual SANとHyper-V連携の概要


StarWind VSANは、Hyper-Vクラスターに必要な共有ストレージを、サーバーローカルディスクを使って提供します。

  1. 内蔵ディスクのミラーリング: 複数のHyper-Vホストのローカルストレージ間でデータを同期的にミラーリングし、仮想的な共有ストレージを作成します。
  2. iSCSI/SMBの利用: この仮想的な共有ストレージを、iSCSIまたはSMB経由でHyper-Vクラスターに提示します。Hyper-Vクラスターは、これをクラスター共有ボリューム (CSV) として認識し、クラスター内のすべてのVMがアクセスできるようになります。
  3. 高可用性: データのリアルタイムなミラーリングにより、いずれかのホストやディスクに障害が発生しても、仮想マシン (VM) は別のホスト上で継続して動作できる耐障害性を実現します。これにより、Hyper-Vフェールオーバークラスターの構築が可能になります。


主な特徴とメリット

特徴 説明 メリット
共有ストレージの不要化 高価な専用のSAN/NAS装置が不要。 CAPEX/OPEXの削減と、導入・運用管理の簡素化。
ハイパーコンバージドの実現 仮想マシン (VM) とストレージを同じサーバーで実行。 フットプリントの削減と、効率的なリソース利用。
高可用性 (HA) 2ノードまたは3ノード構成での同期ミラーリング 99.9999% の高い可用性と、データ損失からの保護。
標準ハードウェアの活用 既存または安価な汎用 (コモディティ) ハードウェアを利用可能。 特定ベンダーに縛られないベンダーロックインの回避と柔軟な拡張性。
パフォーマンス向上 ローカルディスク、特にSSDやNVMeの性能を活かし、データ読み書きを高速化。 仮想環境のI/O性能の向上

連携のステップ(概要)


Hyper-V環境にStarWind VSANを導入し、クラスターを構築する基本的な手順は以下の通りです。

  1. StarWind VSANのインストール: Hyper-Vホストとなるサーバー(通常2台以上)にStarWind VSANソフトウェアをインストールします。
  2. 高可用性ストレージの作成: StarWind管理コンソールを使用して、各サーバーの内蔵ディスクを元に、同期ミラーリングされた高可用性 (HA) デバイス(仮想共有ストレージ)を作成します。
  3. iSCSI/SMBターゲットの提示: 作成したHAデバイスを、iSCSIまたはSMBターゲットとしてHyper-Vホストに提示します。
  4. Hyper-Vフェールオーバークラスターの構築: Windows Serverのフェールオーバークラスターマネージャーを使用し、Hyper-Vクラスターを構築します。
  5. クラスター共有ボリューム (CSV) の設定: iSCSI/SMB経由で接続された共有ストレージをCSVとして構成し、VMの保存先として利用可能にします。
  6. 仮想マシンのデプロイ: CSV上にVMをデプロイし、HA環境下で運用を開始します。

この連携により、最小構成の2ノードでも、VMのライブマイグレーションやホスト障害からの自動復旧が可能な、コスト効率の高いHyper-Vクラスターを構築できます。

N2WSによるランサムウェア対策レベルについて

1. クロスアカウント災害復旧(DR)のための分離リテンション

N2WSは、災害復旧専用に指定された別々のAWSアカウントにバックアップを保存できるようにすることで、ランサムウェアに対する堅牢な第一防衛ラインを提供します。クロスアカウントDRを利用することで、バックアップデータを本番環境から隔離でき、ランサムウェアがバックアップに拡散するリスクを大幅に低減できます。

N2Wの分離リテンション機能では、DRバックアップごとに異なる保持ポリシーを設定可能です。この柔軟性により、最重要データは安全に保管され、必要な時に即座に利用可能となり、データ損失に対する追加の保護層を提供します。

2. 最終バックアップの不変性

N2WSは、最終バックアップを不変化(作成後の改変・削除不可)する機能を提供することで、企業向けランサムウェア保護を強化します。この機能は、ランサムウェアが最新のバックアップを改ざんするのを防ぎ、復旧用に常にクリーンなデータバージョンを確保する上で極めて重要です。

最終バックアップの不変性により、データが暗号化や破損から保護されていることを確信でき、復旧ポイントが常に安全であるという安心感を得られます。この不変のバックアップは信頼性の高い代替手段として機能し、再感染やさらなる損傷の恐れなく、迅速に業務を復旧させることが可能です。

3. クロスクラウドポータビリティと不変性

N2WSはクロスクラウドポータビリティと不変性を提供し、AWSやAzureなど異なるクラウド環境間でバックアップの複製・保存を可能にします。この機能はランサムウェア攻撃からデータを保護するだけでなく、単一のクラウドプロバイダーが障害やセキュリティ侵害に見舞われた場合でもデータへのアクセスを確保することで、災害復旧戦略を強化します。

クロスクラウドポータビリティ機能により、バックアップが単一クラウド環境に拘束されることはなく、柔軟性と回復力が向上します。不変性と組み合わせることで、異なるクラウドプラットフォーム間でデータが改変されず安全に保たれることが保証され、ランサムウェアに対する包括的な防御を実現します。

N2WSがAWS Data Lifecycle Managerを自動化・強化する方法

AWS Data Lifecycle Manager(DLM)は堅実な出発点と捉えてください。スナップショット自動化の補助輪のような存在です。しかし環境が拡大すると、補助輪では不十分になります。そこでN2WSが真価を発揮し、企業が実際に必要とするスピード、柔軟性、コスト削減を実現します。

N2WSがAWS DLMを基盤としつつ(それを超える)機能は以下の通りです:

  • 驚異的な精度でのスケジュール設定:DLMは1時間以内のスナップショットを保証するのみです。コンプライアンスやRPO目標が厳格な場合には不十分です。N2WSでは、60秒単位の精度でバックアップを分単位まで正確にスケジュール設定できます。バックアップは「AWSが対応できる時」ではなく、必要なまさにその瞬間に実行されます。
  • クロスアカウント・クロスクラウド耐障害性: リージョン間バックアップだけでなく、別アカウントやAzure、Wasabiへの復元も不変性を組み込んで実現。まるで誰も触れない秘密の金庫にデータを保管するようなものです。
  • 迅速な復旧、待ち時間ゼロ:DLMのスナップショット作成には最大1時間かかる場合があります。N2WSなら、フルサーバーやVPC、単一ファイルさえも数秒で起動可能。完全なフェイルオーバーや粒度の細かい復元を、わずか数クリックで実現します。
  • エアギャップ+不変性保護:ランサムウェアも人的ミスもバックアップを削除できない、真の「完全自動化」災害復旧アカウントを構築。MFA、暗号化、自動アラートを追加すれば、夜も安心して眠れます。
  • 組み込まれた大幅なコスト削減:AnySnap Archiverにより、既存のスナップショットをN2WSが即座にインジェスト・アーカイブ。ストレージ費用を最大98%削減。夜間や週末に未使用リソースの電源をオフにするスケジュール設定で、さらに50%の節約も可能

要するに、DLMは基本機能を提供します。N2WSはエンタープライズレベルの保護、自動化、コスト最適化をすべて1つのコンソールで実現します。

👉 AWSバックアップコストを削減しつつ、より高速で安全な復旧を実現しませんか?

Entrust DataControl はランサムウェア対策に活用できますか?

Entrust DataControlランサムウェア対策に活用できます。🛡️

Entrust DataControl(現在はEntrust KeyControlの一部として提供されることが多い)は、主にデータの暗号化と鍵管理を通じてランサムウェアの被害を軽減します。


ランサムウェア対策への活用点

機能 ランサムウェア対策における役割
データの透過的な暗号化 データが暗号化されているため、ランサムウェアによってファイルが不正に暗号化された場合でも、その元データ自体はすでにEntrustによって強力に保護されています。また、ランサムウェアによる侵害が成功した場合でも、復号鍵がなければ機密データは読み取れません。🔑
厳格なアクセス制御 仮想環境(VM)やクラウドインスタンスへのアクセスを制御し、ルートユーザーやシステム管理者であっても機密データへのアクセスを制限することで、不正な操作やランサムウェアによるデータの窃取や改ざんのリスクを低減します。
統合キー管理 暗号化に用いる鍵を一元的に安全に管理し、鍵のライフサイクルを制御します。これにより、鍵の漏洩リスクを減らし、鍵がない状態でのデータの不正利用を防ぎます

Entrust DataControlは、ランサムウェアによる侵害が成功した場合の被害の最小化(事後対策)、特に機密データの保護に非常に有効なソリューションです。

エンタープライズクラウドバックアップサービスへの5ヒント

  • きめ細かいアクセス制御の統合: ロールベースのアクセス制御とID管理を活用し、特定のバックアップ機能やデータへのアクセスを許可されたユーザーのみに制限します。これにより、侵害発生時の影響範囲を最小限に抑えられます。


  • ハイブリッドバックアップ戦略の採用: 重要なファイルについては、クラウドバックアップとオンプレミスバックアップを併用します。ハイブリッド戦略により、頻繁に使用されるデータの復旧時間を短縮しつつ、災害に対する長期的なオフサイト保護を確保できます。


  • ランサムウェア対策に不変ストレージを活用:高度なバックアップソリューションが提供する不変ストレージ機能を活用します。書き込み後のデータ削除や改変を防止し、バックアップに対するランサムウェア攻撃から保護します。


  • マルチクラウドストレージ冗長化を実施:重要データについては、複数のクラウドプロバイダーを利用しリスクを分散することを検討します。マルチクラウド冗長化はプロバイダー固有の障害から保護し、災害復旧のための地理的冗長性を高めます。


  • 古いデータを圧縮・アーカイブしコールドストレージへ移行:重要度の低い古いデータについては、コールドストレージやアクセス頻度の低いストレージオプションを活用しコスト削減を図ります。これにより定期バックアップの帯域幅負荷も軽減されます。


参考資料:クラウドバックアップソリューションとは何か?

Google Driveのバックアップ方法が重要な理由

Google Drive(Google Workspace の一部)は世界クラスのプラットフォームであり、サービス停止は稀ですが、個人や企業がこのソリューションに保存するデータの安全性とセキュリティに影響を与える可能性のある様々な問題が存在します。

Google Driveのデータ保護における一般的なリスク


  • 人為的ミスによる誤削除や上書き。
  • 組織に損害を与える目的でファイルを削除する悪意のある内部関係者。
  • 脅威アクターがGoogle Driveに保存されたデータにアクセスし、身代金を要求するためにデータを拘束するランサムウェアやゼロデイ攻撃。
  • 過剰な権限を持つ未検証のOAuthアプリ。これらはGoogle Driveに保存されたデータを破壊する別の攻撃経路となります。未検証のアプリは信頼する前に慎重に審査すべきです。
  • 共有ファイルの所有者がアクセス権を撤回した際のアクセス喪失。


これらの事象はいずれも、Google Driveに保存されたデータへのアクセス不能を招く可能性があります。そしてGoogle自体もこの問題を解決できません。共有責任モデルの条件に基づき、Googleが管理を約束するのはGoogle Driveの基盤インフラとサービスのみです。プラットフォームに保存するデータの管理と保護は、Driveユーザー自身の責任です。(この事実を知らなかったとしても気にする必要はありません。IT専門家の79%が、SaaSプラットフォームにはデータバックアップと復旧機能が組み込まれていると誤って信じていますが、実際にはほとんどの場合そうではありません。)

さらに、これらのリスクは単なる理論上の問題ではありません。Google Driveのデータ損失に関する実例は数多く存在します。例えば、製薬会社が人事情報を失った事例(フォルダーが正しく同期されなかったため)や、脅威アクターが脆弱性を発見し、検知されずにGoogle Drive環境にアクセスできた事例などが挙げられます。


Googleのネイティブバックアップツールの制限事項

Googleドライブやその他の製品向けのGoogleネイティブバックアップツールは小規模なバックアップニーズには有用ですが、自動化された大規模バックアップには不向きな複数の制限があります:

  • 同期はバックアップではない: 上記の通り、デバイスとクラウド間のファイル同期は、誤削除やランサムウェアから保護しません。このため、同期はバックアップではないのです。
  • Google Vault: これはデータアーカイブツールであり、真のバックアップソリューションではありません。1回に1アイテムのみ復元可能です
  • Google Takeout: 自動化機能が不足しており、大量データの移動時に失敗しやすく、共有データのコピーを完全にはサポートしていません。
  • バージョン管理: ほとんどの場合、ドライブはデフォルトでファイルのバージョンを最大30日間または100バージョンまで保持します。したがって、これらの期間を超えるデータの復元にはドライブのバージョン履歴は使用できません。
  • ごみ箱: Googleドライブのごみ箱機能は「ソフト削除」機能であり、データを30日間保持します。しかし、その後ごみ箱内のデータは完全に削除され、Googleドライブ経由での復元は不可能になります。
  • アクセス権の喪失: ファイルまたはフォルダの所有者がデータを削除または共有権限を解除した場合、そのデータにはアクセスできなくなります。


要するに、Drive自体や関連製品の手動バックアップ機能による保護は限定的です。また拡張性に乏しいため、数十~数百人のユーザーが数千ものファイルやフォルダを複数のDriveアカウントに分散して管理する組織では、Driveのバックアップが困難になります。


自動化されたドライブバックアップ手法

Google ドライブのバックアップを大規模に自動化する最善の方法は、Climb Cloud Backup  for Microsoft 365/Google Workspace などのサードパーティ製ソリューションを利用することです。Climb Cloud Backup は、Google ドライブのバックアップをはじめ、その他の Google プラットフォームに対する堅牢なサポートを提供します。

Climb Cloud Backup は高度なバックアップ機能による自動化を実現するだけでなく、暗号化バックアップデータや不変バックアップなどの機能でセキュリティを最大化します。さらに、メタデータ、共有ドライブデータ、古いファイルバージョンも保護。ドライブのバックアップ時に重要な情報が漏れるのを確実に防止します。

how-to-backup-google-drive-msp360

さらに、Climb Cloud Backup for Google Workspaceでは、Google Driveのバックアップデータを任意のプラットフォーム(ローカルストレージやWasabi、AWS、Azureなどのクラウドベースのオプションを含む)に保存できます。これにより、バックアップを複数の場所に分散させてデータ保護を最大化すると同時に、ユーザーがバックアップに最適なコスト効率の高いストレージオプションを選択できるようにすることで、データストレージコストを最小限に抑えることが容易になります。

Gmail自動バックアップツール

自動化されたGmailバックアップツールを使用すると、選択したGmailデータまたはすべてのGmailデータを、お好みの保存場所に自動的にバックアップできます。


Climb Cloud Backup for Google Workspace

例として、Climb Cloud Backup for Google Workspace を挙げます。これは、Gmail およびその他の主要な Google Workspace サービスに保存されたデータに対して、完全なバックアップとデータ保護のサポートを提供します。MSP360 は、メールとその関連メタデータ(添付ファイルを含む)だけでなく、Google ドライブのバックアップデータ、連絡先、カレンダーイベントも自動的にバックアップできます。

Gmailデータ保護の柔軟性と細かな制御を実現するため、Climb Cloud Backup (CCB)for Google Workspaceには増分バックアップ、バックアップ対象フォルダやラベルの個別選択、詳細な復元オプションなどの機能が搭載されています。さらに、バックアップデータの保護を目的としたロールベースのアクセス制御、AES暗号化、監査ログ記録、スケジュール設定も可能です。


さらにCCBはAmazon S3、Wasabi、Azure Blob Storage、Backblazeなど多様なクラウドストレージプラットフォームと連携。バックアップデータの保存先をユーザーが選択できるため、大量のGmailデータを扱う企業にとって重要なコスト効率の高いバックアップオプションを実現します。強力なセキュリティとGmailバックアップの保存先・プロセスに対する精密な制御により、コンプライアンス要件の達成も支援します。

バックアップからGmailを復元する方法

バックアップからGmailデータを復元する手順は、バックアップの作成方法によって異なります。

手動バックアップを使用した場合、データの復元には以下のいずれかの方法が利用できます:

  • .mbox ファイル(メールおよび関連データの保存に使用)を含むバックアップは、Thunderbird やその他の主要なメールクライアントで開くことができます。
  • .pst ファイル(Microsoft 製品で使用)のバックアップは Outlook で開くことができます。
  • サードパーティ製メールサービス と同期された Gmail データは、そのサービスを通じてアクセスできます。
  • 作成したバックアップデータのタイプによっては、gmvaultのようなCLIベースのツールを使用してメールをGmailアカウントに復元できる場合もあります。

Climb Cloud Backup for Google Workspaceのような自動化されたGmailバックアップツールでは、単にアカウントを選択するだけでバックアップデータを直接Gmailアカウントに復元できます。これはGmailデータを復元する最も迅速かつ柔軟な方法です。

どの復元方法を選択する場合でも、復元後にメタデータ、メールのスレッド表示、添付ファイルを必ず検証してください。サードパーティ製メールクライアントがGmailのメタデータを正しく解釈できないなどの問題により、これらが欠落または不完全になる可能性があります。このような問題が発生した場合は、別の復元方法や代替メールクライアントの使用を検討してください。


Gmailのバックアップ方法に関する最終的な考察

多くの個人や企業にとって、Gmailには重要なデータが含まれています。そのため、Gmailのバックアップ計画を策定することが不可欠です。Gmailのバックアップは、予期せぬデータ損失や利用不能から保護すると同時に、データ移行やコンプライアンス要件の簡素化にも役立ちます。

幸いなことに、Gmailをバックアップする方法は数多く存在します。手動での方法は最もシンプルですが、拡張が難しく、時間もかかります。効率的な大規模バックアップには、Climb Cloud Backup(CCB)のような自動化ソリューションの採用を検討してください。

ただし、どの方法を選択する場合でも、最も重要なのは適切なGmailバックアップソリューションを導入することです。多くの個人ユーザーや企業と同様に、メールを失うリスクは許容できません。バックアップソリューションは小さな投資ですが、Gmail自体に問題が発生した場合に大きな利益をもたらす可能性があります。

Java/Jakarta EE仕様に準拠した企業向けアプリケーションサーバにはどのような製品がありますか?

Java/Jakarta EE仕様に準拠した企業向けアプリケーションサーバーは多数存在します。これらの製品は、それぞれ異なる出自や特徴を持ち、企業の多様なニーズ(コスト、サポート体制、クラウド親和性など)に対応しています。


これらのアプリケーション・サーバは、Webコンテナ機能(サーブレット、JSPなど)を提供し、クライアント(Webブラウザ)からのリクエストに応じてEspressChart/Reportの機能(データベース接続、グラフ生成、Webへの配信)を実行します。


製品名 提供元 特徴
JBoss Enterprise Application Platform (JBoss EAP) Red Hat (IBM傘下)
オープンソースのWildFlyをベースにした商用版。長期サポートとサブスクリプションが提供され、エンタープライズLinux環境との親和性が高い。
Oracle WebLogic Server Oracle
非常に長い歴史を持つ、世界をリードする商用Java EEサーバーの一つ。特にOracle製品群(データベースなど)との連携が強力で、大規模金融システムなどに採用例が多い。
IBM WebSphere Application Server (WAS) IBM
伝統的な企業システムで広く使われる商用サーバー。近年は軽量なクラウドネイティブ版のWebSphere Libertyに力を入れており、PayaraやOpen Libertyの競合となっています。
FUJITSU Software Interstage Application Server 富士通
国内で多くの実績を持つ、日本の企業システムに特化したアプリケーションサーバー。近年はFUJITSU Software Enterprise Application PlatformとしてJakarta EE対応を進めている。
WebOTX Application Server NEC
NECが提供する、日本の商習慣やミッションクリティカルな要件に対応したアプリケーションサーバー。

バックアップについての結論

これらの簡潔な回答により、バックアップ関連の用語を区別し、容易に採用できるバックアップのベストプラクティスを理解するのに役立ちます。バックアップ作業をさらに便利かつシンプルにするには、主要なクラウドストレージプロバイダーを活用し、すべてのバックアップ操作を一元管理し、堅牢なデータ保護を実現するために設計されたクライムのバックアップ・ソリューション群をお試しください。

3-2-1バックアップ戦略とは?

3-2-1バックアップ戦略は、バックアップコピーを異なる保存場所に分散させることで、潜在的なデータ損失の抜け穴を塞ごうとするものです。つまり、複数のバックアップ場所からシステムを復旧できるということです。

本質的には、データの3つのコピーを少なくとも持つべきです:2つは異なるデバイスにローカルでバックアップされ、1つはクラウドなどのオフサイトバックアップ場所に保存されます。


データバックアップのベストプラクティスとは?

最善の結果を得るためには、以下の手順を踏むべきです:

  • まず、システム内のデータの種類を定義することから始めます。ここで、ホットデータ、コールドデータ、アーカイブデータ、システムデータ、アプリケーション設定データ、運用データを特定します。
  • その定義が完了したら、各データクラスに最適なバックアップの種類を選択できます。
  • その際、理想的なバックアップ先も選択すべきです。ここでローカル、クラウド、ハイブリッドバックアップストレージの中から選択します。
  • その後、包括的なバックアップ計画を作成し、対応するバックアップスケジュールを策定できます。
  • 長期的な事業継続を確保するため、全体的な復旧時間目標(RTO)復旧時点目標(RPO)の算出と設定を検討してください。
  • 災害発生時のダウンタイムの実際のコストをさらに評価し理解することを忘れないでください。
  • そして最も重要なのは、標準的な3-2-1データバックアップ戦略に従うことです。

バックアップすべきデータとその頻度は?

実際のところ、システム内のあらゆるデータを例外なくバックアップすべきです。

ただし、その際にはデータの種類ごとに異なる扱いが必要であることを覚えておいてください。

例えば、バックアップの頻度自体がすべてのファイルで同じというわけではありません。データの「重要度」によって異なります。その点に関して、バックアップ対象データは主に3つの分類に分けられます:


  • ホットデータは最も重要です。日常的に復元が必要となる可能性のある本番データベースが含まれます。そのため、定期的にバックアップし、その後の変更はリアルタイムで更新されるべきです。
  • コールドデータは重要度が低く、データ損失後にのみ復元されます。つまり、バックアップデータの更新は週次程度で十分です。
  • アーカイブデータはコンプライアンスや監査目的のみに保存されます。通常は数年単位でバックアップされ、更新はごく稀に行われます。

別の見方としては:


  • オペレーティングシステムファイルは、初回にフルバックアップを実施し、その後はシステムファイルに変更が検出されるたびに(頻度は低いものの)フルバックアップで更新すべきです。
  • アプリケーション設定データも同様にフルバックアップを実施し、ソースマシンでアプリケーションデータが変更された場合にのみ更新すべきです。
  • 一方、運用ファイルは、絶えず変化するミッションクリティカルなデータを保持しているため、定期的にバックアップと更新を行う必要があります。

どの種類のバックアップを使用すべきか?

どの種類のバックアップを使用すべきか?

各状況に適したバックアップを選択する際、以下のポイントに留意してください:

  • 常にフルバックアップから始めるべきです。これは後続のバックアップの基盤となります。ただし、それだけで終わらせてはいけません。データの整合性とバックアップの信頼性を確保するため、他の種類のバックアップを実行している場合でも、定期的にフルバックアップを実行することが推奨されます。
  • 毎回フルバックアップを行う代わりに、増分バックアップをより頻繁に実行しつつ、フルバックアップは時折のみ実施することを検討してください。これは、データセット全体を再アップロードする負担なくフルバックアップを更新する便利な方法です。唯一の問題は、データ変更の一部を喪失するとバックアップ全体が損なわれる点です。
  • データ復旧能力の高速化を目指すなら、差分バックアップを優先することをお勧めします。特にMicrosoft SQLサーバーのバックアップと復元において効果的です。
  • システムレベルのバックアップを迅速化するには、合成フルバックアップの仕組みを構築すべきです。

VMバックアップとは?

VMバックアップは、仮想マシンからデータのコピーを転送し、バックアップストレージに保存することを目的としています。このアーキテクチャは、もちろんローカルマシンとは異なり、ブロック追跡をサポートするように設計されています。

アプリケーション対応バックアップとは?

アプリケーション対応バックアップは、特定のアプリケーションの完全な状態をバックアップすることを目的としています。特定の時点において、アプリケーションデータとその関連設定をコピーして保存します。これにより、アプリケーションを完全な状態で完全に復元することが容易になります。

イメージベースのバックアップとは?

イメージベースのバックアップとは、ソースマシンのハードドライブデータと関連するすべての設定をコピーし、バックアップストレージに保存する特殊な技術です。これにより、ハードドライブイメージからの復元が可能になります。

システム状態のバックアップとは?

ファイルレベルのバックアップとは異なり、システム状態のバックアップはソースマシンの重要なシステムファイルのコピーを保存しようとします。これは、オペレーティングシステムとそれに付随するすべてのシステム構成をバックアップするものです。

ファイルレベルバックアップとは?

ファイルレベルバックアップとは、データを個別のファイルに整理する手法です。これにより、ソースマシンからバックアップストレージへ、異なるデータファイルを便利に

バックアップ手法とは?

バックアップ手法とバックアップの種類を混同しないように注意してください。後者が様々なバックアップ手法に焦点を当てるのに対し、前者はデータをバックアップするための異なるアプローチそのものを指します。バックアップ技術と考えることもできます。


主なデータバックアップ方法は以下の3つです:ファイルレベルバックアップ、システム状態バックアップ、イメージベースのバックアップ、アプリケーション対応バックアップ、VMバックアップ。