投稿者「climb」のアーカイブ

N2WSバックアップサーバーを保護するための必須セキュリティ対策

●重要なバックアップインフラを分離する: N2WSを、厳格に制御されたインバウンド/アウトバウンドルールを持つ専用VPCにデプロイすることを検討してください。これにより、バックアップ環境を本番環境のトラフィックから分離し、脅威や不正アクセスへの曝露を低減します。

●スナップショット管理にライフサイクルポリシーを活用する: EBSスナップショットとS3オブジェクト向けに自動化されたライフサイクルポリシーを実装し、データをコールドストレージ層に移行したり古いスナップショットを削除したりします。これにより、コンプライアンスを維持しながらストレージコストを効果的に管理できます。

●IAMロールをリージョン別に分割:N2WS用にリージョン固有のIAMロールを作成し、セキュリティ侵害が発生した場合の影響範囲を最小限に抑えます。この分割により特定リージョン内での影響を封じ込め、全体的なセキュリティを強化します。

●委任ユーザーに最小権限の原則を適用:委任ユーザーを作成する際は、最小限の必要な権限のみを付与する最小権限の原則を適用します。これにより、委任アカウントが侵害された場合のリスクを低減します。

●ボリューム暗号化の実装:ボリュームは常に暗号化することがベストプラクティスです。災害復旧(DR)時の制約が少ないため、AWS管理型KMSではなく顧客管理型KMSの使用が推奨されます。


追加のヒント:定期的な更新を忘れずに

各新バージョンでは、コンプライアンスロックなどの新機能を継続的に追加し、基盤となるOS、Apache、データベースを最新のセキュリティパッチで更新しています。これらの更新は、システムのセキュリティと機能性を高めるために不可欠です。

さらに、コンプライアンスロックのような新機能は保護とコンプライアンス能力を強化し、データの安全性と規制要件への適合を確保します。製品アップデートを最新状態に保つことは、セキュリティ向上だけでなく、システムのパフォーマンスと信頼性を最適化する最新ツールや機能へのアクセスを保証します。

N2WSは初めてですか? インタラクティブなデモを体験して、その仕組みをご覧ください。
Wasabi / Amazon S3インテグレーション

アプリケーションをWasabiで使用するように設定する

S3ベースのストレージと連携するほとんどのアプリケーションは、エンドポイントURLとアクセス認証情報を変更することで、任意のS3互換サービスに対応させることができます。これには通常、アプリケーション内のストレージ設定を更新して新しいサービスのリージョン固有エンドポイントを使用するようにし、適切なアクセスキーとシークレットキーを提供することが含まれます。


まず、Wasabi管理コンソールでアクセスキーとシークレットキーを作成します。次に、アプリケーションをWasabiのリージョン別エンドポイント(例:米国西部リージョンの場合はs3.us-west-1.wasabisys.com)を使用するように設定します。ハードコードされたAWS S3エンドポイントやリージョン識別子を、適切なWasabiの値に置き換えてください。


Terraformなどのインフラストラクチャ・アズ・コードツールや、Boto3やAWS SDKなどのSDKについては、プロバイダーまたはクライアント設定内のエンドポイントURLを更新してください。多くのサードパーティ製アプリケーション(例:Veeamなど)もカスタムS3エンドポイントをサポートしており、カスタムエンドポイントと認証情報を指定することでWasabiとの直接連携が可能です。


●小ファイルのストレージ最適化: アップロード前に小ファイルを大きなアーカイブファイル(例: TARやZIPを使用)にまとめ、APIのオーバーヘッドを削減し、取得パフォーマンスを向上させます。


●マルチスレッドアップロードの活用: Wasabiは高速性を重視して設計されていますが、マルチスレッドアップロード(`aws s3 cp –multipart-chunksize` または SDK ベースの並列アップロード)を使用することで、アップロード時間を大幅に短縮できます。


●Wasabi Direct Connectの利用: 大量のデータを頻繁に移動する場合は、専用ネットワークリンクにより高帯域幅と低遅延を実現するWasabi Direct Connectをご利用ください。


●使用量計測によるストレージ増加の監視: Wasabiはストレージ使用量をリアルタイムで追跡するAPIを提供します。請求書待ちではなく、これを利用してストレージ需要を積極的に管理しましょう。


●バケットライフサイクルポリシーの戦略的実装: AWS S3とは異なり、Wasabiはデータエクレスに課金しませんが、ライフサイクルポリシーは不要なオブジェクトを自動削除し、不要な散乱を防ぎ、取得効率を向上させることで、ストレージコストの最適化に依然として役立ちます。


AWSとWasabiのクロスクラウドバックアップ管理をN2WSで実現

AWSからWasabiへのデータ移行やアーカイブが、N2WSならもっと簡単!AWSデータをWasabi S3へ、またはその逆方向にバックアップ可能。リージョン間、アカウント間、さらにはクラウド間での復元も実現します。Wasabiの手頃なストレージ階層と、N2WSのAWS向け統合型災害復旧ソリューションを組み合わせることで、エンタープライズレベルの耐障害性を、高額なエンタープライズ価格帯なしで提供します。

Amazon RDSスナップショットの活用

  • 自動化のためのスナップショットタグ付け: 手動でスナップショットを作成する際、一貫したタグ(例: Environment=Prod, Retention=90d)を適用します。AWS Lambda または AWS Backup ライフサイクルポリシーと組み合わせて、古いスナップショットを自動的に削除し、不要なストレージコストを防止します。


  • 復元済みインスタンスの事前ウォームアップによる迅速な稼働準備: スナップショットからの復元では、遅延読み込みによるI/Oの遅延が発生する可能性のあるコールドインスタンスが作成されます。復元後に読み取り集中型クエリを実行(またはPostgreSQLでpg_prewarmを使用)し、ホットデータをキャッシュにロードしてパフォーマンスを向上させます。


  • リージョン間コピー前にスナップショットを暗号化:既存のスナップショットが暗号化されていない場合、別のリージョンに転送する前に暗号化を有効にしてコピーします。これによりコンプライアンスを確保し、元のインスタンスを再作成せずに転送中のデータを保護します。


  • スナップショットストレージの断片化を監視: スナップショットの頻繁な削除と再作成はストレージの断片化を引き起こす可能性があります。定期的にスナップショットを統合し、新しいインスタンスに復元して新しいスナップショットを取得することで、S3ストレージの割り当てを最適化し、コストを削減します。


  • ガードレールを用いたアカウント間共有の自動化:AWSアカウント間でスナップショットを共有する場合(例:DRやテスト用)、AWS Resource Access Managerを使用してプロセスを自動化し、アクセスポリシーを検証します。厳格なIAM条件とKMSポリシーを適用します。


N2WSによるRDSバックアップの最適化

RDSスナップショットポリシーの手動管理は煩雑でリスクも伴います。N2WSなら、スナップショットの作成・保持・アーカイブ、AWSアカウント間でのクロスリージョン災害復旧を驚くほど簡単に自動化できます。

  • インテリジェントなポリシーでスナップショットをスケジュール(最大精度と最小RPOを実現するため、60秒間隔での作成も可能です)
  • スナップショットをS3/Glacierストレージ階層やWasabiに即時アーカイブし、長期保存と大幅なコスト削減を実現。
  • アカウント、VPC、さらにはリージョンを跨いでRDSインスタンスまたは特定のDBスナップショットを復元。
  • スナップショットの不変性を強制し、エアギャップアカウントを活用して次元の異なる保護を実現。

N2WSなら常に制御を保持——スクリプト不要、推測不要、自動化されたコスト効率の高いRDSバックアップと復旧を実現します。

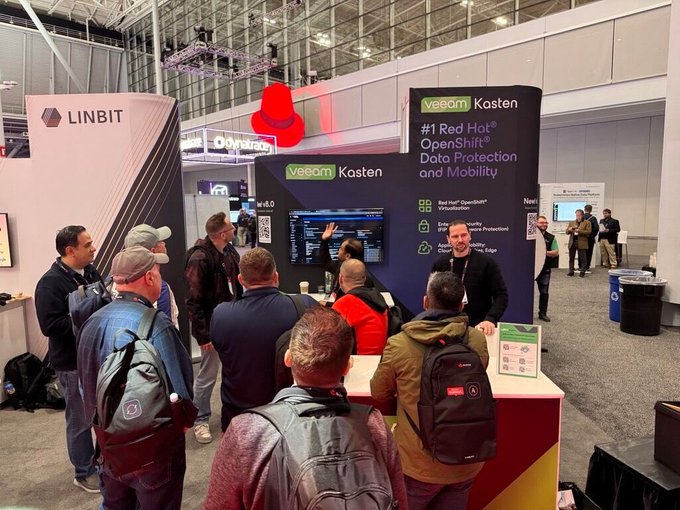
Veeam Kasten v8 の新機能 @ RHSummit 2025

• Deeeprr 統合保護機能(VM とコンテナ対応)
• KubeVirt 仮想マシンとコンテナ化ワークロードのネイティブサポート
• VM 向けのファイルレベル復元(FLR)により、VM の完全クローン作成なしで高速かつ詳細な復元が可能
Red Hat OpenShift Virtualization 向けに最適化
• 新しい VM ダッシュボードにより、クラスターネームスペース全体でのバックアップ可視化をシームレスに実現
• Kasten for Modern Virtualizationの専用価格設定(Red Hat OpenShiftのモダン化戦略と整合)
• セキュリティを最優先にした設計 • ISO 27001認証取得
• 最小権限のKasten Podと簡素化された暗号化キーのローテーション
• セキュアなセルフサービス型クラスター間移行
• 大規模環境での運用を簡素化
• 高度な復元ポイントカタログとポリシー管理の簡素化を特徴とする刷新されたUI
• ポリシーごとの保護ステータスで可視性を向上し、問題解決を加速
• 顧客の選択の自由
• 広範な CPU アーキテクチャ対応(x86、ARM、IBM Power)
• ストレージサポートの拡張(NetApp ONTAP NAS Economy Volumes を含む)
Veeam Vault と統合し、完全に管理されたコスト予測可能なオフサイトバックアップを提供
画像
なぜ重要か?:
OpenShift仮想化を採用する企業は、成長に合わせて進化するデータ保護戦略が必要です。Veeam Kasten v8は、クラウドネイティブアーキテクチャへのスケールアウトを自信を持って実現するための、運用簡素化、データ耐障害性、セキュリティ態勢を提供します。 パートナーシップで成功を加速: このリリースは、VeeamとRed Hatの強力な協業を基盤に、レガシーVMをOpenShiftへ移行しつつコンテナネイティブの未来に備える顧客向けに統合ソリューションを提供します。
現在利用可能: Veeam Kasten for Kubernetes v8 + Kasten for Modern Virtualization

Veeam Backup & Replication がRed Hat OpenShift に対してどれだけ有益なのか?

Veeam Backup & Replication は、Red Hat OpenShift 環境において、主にデータの保護とリカバリ、アプリケーションのモビリティ、および運用の効率化の点で非常に有益です。


Veeam Backup & ReplicationがRed Hat OpenShiftに有益な点


Veeam Backup & Replication(VBR)は、OpenShiftのコンテナ化されたアプリケーションと永続的なデータを保護するための機能を提供し、データレジリエンス(耐障害性)の強化に貢献します。


1. データのバックアップとリカバリ


  • OpenShiftアプリケーション全体の保護: アプリケーションとその設定、関連する永続ボリューム(PV)、永続ボリューム要求(PVC)をまとめてバックアップできます。これにより、個別のファイルやデータベースだけでなく、OpenShift上のサービス全体を迅速に復元できます。
  • ディザスタリカバリ(DR): ランサムウェア攻撃や大規模な障害が発生した場合でも、バックアップデータを使用してシステム全体を別の安全な環境に退避(移行・復旧)させるシナリオに活用できます。
  • 柔軟なリカバリオプション: アプリケーション全体、または特定のKubernetesリソース(PV、PVCなど)のみを柔軟にリストアできます。


2. アプリケーションのモビリティと移行


  • クラスター間移行: あるOpenShiftクラスターで取得したバックアップを、別のOpenShiftクラスターに安全かつ容易にリストア・移行できます。これは、開発環境からステージング、そして本番環境への移行や、クラウド間・オンプレミス間の移行(マルチクラウド/ハイブリッドクラウド戦略)にも役立ちます。


3. 運用効率の向上とリスク低減


  • パフォーマンス向上: バックアップとリストアの性能が向上することで、バックアップ/リカバリにかかる時間を短縮できます。
  • セキュリティリスクの低減: バックアップデータの転送経路を最適化することで、クラスター内部のデータ移動に伴うセキュリティリスクを低減し、同時にネットワーク負荷も軽減します。
  • 一元管理: Veeamのプラットフォームを通じて、仮想マシン(VM)や物理サーバーのデータ保護に加え、OpenShift上のコンテナワークロードも一元的に管理できるため、運用の一貫性を保てます。

これらの機能により、Veeam Backup & Replicationは、OpenShift上でミッションクリティカルなアプリケーションを運用する際のビジネス継続性データ保護戦略の要となります。


🌟 また Red Hat OpenShift Virtualization + Veeam Software Kasten が連携して、最新インフラストラクチャに統合された回復力を提供します。

Veeam Software Kasten は、コンテナと KubeVirt VM の両方に対して、アプリケーション整合性のあるバックアップと復元、ランサムウェア保護、DR ワークフロー、ワークロード モビリティなど、Kubernetes ネイティブのデータ保護を提供します。


📦 以下を提供します。

✅ 妥協のない回復力 – ワークロード全体で統合されたバックアップ、DR、サイバー回復力。
✅ モダナイゼーションの迅速化 – SAN に支えられたパフォーマンスで、ミッション クリティカルな VM およびコンテナ ワークロードを OpenShift で移行して実行します。
✅ エンタープライズ対応のスケールとセキュリティ – 規制された業界や大規模環境向けに設計されています。


このコラボレーションにより、ユーザは、プラットフォーム、ストレージ、保護のあらゆるレイヤーで選択できる自由を得て、一貫した回復力を確保しながら、自分の条件に合わせて自由にモダナイズすることができます。

AWSコストの最適化へ

  • 柔軟な終了処理を備えたEC2スポットインスタンスの検討: ワークロードが中断を許容できる場合、スポットインスタンスは費用対効果に優れています。状態を頻繁に保存する終了対応アプリケーションを開発し、データ損失や大幅なダウンタイムなしに終了を適切に処理できるようにします。
  • リザーブドインスタンスマーケットプレイスの活用: AWSでは、未使用のリザーブドインスタンスをマーケットプレイスで売買できます。リソース需要が変化した場合、不要なリザーブドインスタンスを売却し、新しい使用パターンに合ったより安価なインスタンスを購入できます。
  • ストレージ階層の統合と最適化: アクセス頻度に基づいてデータを分類し、ストレージ戦略を定期的に監査します。アクセス頻度の低いデータはS3 GlacierやDeep Archiveなどの低コストストレージクラスに移動しますが、迅速な検索のために適切なタグ付けを確実に行います。
  • 正確なコスト配分のためのリソースタグ付け:すべてのAWSリソースに詳細なタグ付け戦略を適用し、どの部門やプロジェクトがコストを発生させているかを完全に可視化します。タグ付けにより、AWS Cost ExplorerやAWS Budgetsでリソース使用状況を正確に分析できます。
  • クロスアカウント課金とリソースプール化:AWS Organizationsを使用して複数のAWSアカウントの課金を統合します。リソースをプール化することで、ボリュームディスカウントやその他の課金効率化を活用でき、適用可能なコスト削減をどのアカウントも見逃すことがなくなります。

✅ プロの秘訣: N2WSはストレージクラス間でバックアップ階層化を自動化し、古いデータをGlacierやGlacier Deep Archiveのようなコスト効率の高いストレージへシームレスに移動します。この戦略により、高アクセス階層への過剰な支出を避けつつ、長期保存のニーズを満たせます。

AWS Backupでコールドストレージ利用

  • 復元を高速化する事前ステージングメタデータ: GlacierまたはDeep Archiveを使用する際、バックアップメタデータ(ファイルリスト、タイムスタンプ、タグなど)の軽量インデックスをDynamoDBやS3 Standardのようなウォームストレージ層に維持します。
  • 緊急復元のための並列取得パイプラインを構築:Glacierの「重要サブセット」データ向け緊急取得オプションと組み合わせることで、バックグラウンドで一括復元を継続しながらサービスを迅速に復旧させます。
  • アーカイブ前の重複排除を実施:バックアップをコールドストレージに格納する前に実施します。これにより長期アーカイブ内の冗長データが減少し、ストレージコストと復元時の取得時間の両方を削減します。
  • コンプライアンス対応のためのクロスリージョンレプリケーションを実装: 厳格な規制対象ワークロードでは、コールドストレージバックアップを別のAWSリージョン、あるいは異なるクラウドプロバイダーへレプリケートします。これにより、リージョン全体のAWS障害やGlacierサービス低下によるリスクを軽減できます。
  • 保存期間だけでなく実際の使用パターンに基づく自動アーカイブ:静的なライフサイクルポリシーではなく、LambdaやStep Functionsを活用し、ビジネスイベント(例:プロジェクト終了、顧客オフボーディング)に基づいてGlacier階層へのデータ移動タイミングを動的に決定します。

AWS障害の回避について

  • AZレベルの冗長性だけでなく、リージョン単位の分離を設計に組み込む: us-east-1での障害がグローバルに波及しないようワークロードを設計する。Route 53のレイテンシベースルーティングやマルチリージョンでのアクティブ/アクティブ構成を活用する。さらに良いのは、ネットワーク設定を完全に維持したままワークロード全体を別のクラウドにフェイルオーバーできるN2W(ネットワーク間移行)を利用することだ。
  • クロスクラウドDNSフェイルオーバーの実装: Route 53障害(実際に発生した事例あり)はフェイルオーバー戦略全体を阻害する。サードパーティDNSプロバイダー(CloudflareやNS1など)を活用し、ヘルスチェック機能でトラフィックを別のクラウド環境やオンプレミス環境へルーティング可能に。
  • 代替環境でのコールドワークロード事前準備: 別のクラウド(例:AzureやGCP)に「ウォームスタンバイ」または「コールドスタンバイ」インフラを事前構成し、必要時に自動スケーリングを実行します。
  • 重要サービスをAWSネイティブAPIから分離: コアビジネスロジックにおけるAWS API(STS、KMS、IAMなど)へのハード依存を最小化します。これらのAPIはボトルネックとなる可能性があります。N2WSはデータと設定を完全に別のクラウドにバックアップし、依存関係を完全に回避します。
  • 全ての統合に冪等性のある再試行ロジックを実装する: AWSサービスが劣化(例:S3のレイテンシ急増)した場合、単純な再試行ループはAPIへの過剰なリクエストで障害を悪化させます。失敗を増幅させないよう、指数関数的バックオフとサーキットブレーカーを備えた再試行メカニズムを設計してください。

Azure 障害ガイド:その対処法生存術

  • ワークロードに応じたフェイルオーバー優先度の設定: すべてのワークロードが即時復旧を必要とするわけではありません。重要度に応じて分類し、階層化されたフェイルオーバー計画を設計します。ミッションクリティカルなシステムにはホットスタンバイ環境を有効化し、重要度の低いシステムにはコスト削減のためウォームまたはコールドリカバリを計画します。
  • DNSフェイルオーバー自動化の事前準備: 停止はDNSレイヤーでアプリケーション可用性を損なうことが多い。Azureエンドポイント障害を自動検知し、最小限の遅延で代替リージョンやクラウドへトラフィックをリダイレクトするグローバルDNSフェイルオーバーソリューションを導入する。
  • 迅速な復旧のための不変インフラストラクチャの展開: インフラストラクチャ・アズ・コード(IaC)を活用し、環境定義をGitリポジトリに保存します。これにより、Azureのコントロールプレーン可用性に依存せず、他の地域やクラウドへの重要サービスの迅速かつクリーンなデプロイが可能になります。
  • プロアクティブな対策のためのAzureサービスヘルスAPIの監視: これを監視スタックに統合し、サービス問題のプログラム通知を受信します。顧客に影響が出る前にワークロードを先制的にリダイレクトする自動スケーリングやフェイルオーバースクリプトと組み合わせます。
  • 分割脳シナリオに対する地域間レプリケーションの強化: 地域を跨ぐアクティブ-アクティブアーキテクチャを使用する場合、部分的な障害時の分割脳を防止するため、データ層に競合解決ロジックを設計します。重要なデータパスにはクォーラムベースの書き込みや強一貫性モデルを活用します。


N2WSディザスタリカバリによるAzure障害への備え

Azure障害が発生すると、仮想マシンが停止するだけでなく、DNSレコード、セキュリティグループ、IAMロール、そして環境全体を結びつけるネットワーク基盤も機能停止に陥ります。だからこそ、復旧は「単にバックアップを起動する」以上の意味を持たねばなりません。


N2WSはAzure障害時でも事業を継続する力を提供します:

  • AWSまたはWasabiへの復旧を数分で実現—事業継続を保証。単一リージョンの障害なら、別のAzureリージョンへ数秒で復旧可能。
  • DR訓練の自動化で復旧計画の実効性を事前に確認。
  • すべてを復元:サーバ全体から個々のファイルまで、ネットワーク構成や暗号化を含めて完全復元。
  • 不変バックアップ:データはあなた自身も変更不可。ランサムウェアや誤削除による復旧妨害を防ぎます。
  • コスト効率の高い保護:バックアップ費用の二重支払いを回避。保持する世代数を自由に設定し、残りはアーカイブ化で即時コスト削減を実現。Azure Backupとは異なり、VMのサイズに関わらず定額料金です。

AWSの大規模障害を乗り切る対策は!

  • AZレベルの冗長性だけでなく、リージョン単位の分離を設計に組み込む: us-east-1での障害がグローバルに波及しないようワークロードを設計する。Route 53のレイテンシベースルーティングやマルチリージョンでのアクティブ/アクティブ構成を活用する。さらに良いのは、ネットワーク設定を完全に維持したままワークロード全体を別のクラウドにフェイルオーバーできるN2W(ネットワーク間移行)を利用することだ。
  • クロスクラウドDNSフェイルオーバーの実装: Route 53障害(実際に発生した事例あり)はフェイルオーバー戦略全体を阻害する。サードパーティDNSプロバイダー(CloudflareやNS1など)を活用し、ヘルスチェック機能でトラフィックを別のクラウド環境やオンプレミス環境へルーティング可能に。
  • 代替環境でのコールドワークロード事前準備: 別のクラウド(例:AzureやGCP)に「ウォームスタンバイ」または「コールドスタンバイ」インフラを事前構成し、必要時に自動スケーリングを実行します。
  • 重要サービスをAWSネイティブAPIから分離: コアビジネスロジックにおけるAWS API(STS、KMS、IAMなど)へのハード依存を最小化します。これらのAPIはボトルネックとなる可能性があります。N2WSはデータと設定を完全に別のクラウドにバックアップし、依存関係を完全に回避します。
  • 全ての統合に冪等性のある再試行ロジックを実装する: AWSサービスが劣化(例:S3のレイテンシ急増)した場合、単純な再試行ループはAPIへの過剰なリクエストで障害を悪化させます。失敗を増幅させないよう、指数関数的バックオフとサーキットブレーカーを備えた再試行メカニズムを設計してください。

ARTESCA+ Veeam アプライアンスにおけるソースデータと使用可能容量の違いは何ですか?(ARTESCA+ Veeam)

ソースデータとは、バックアップ対象の元のデータ量(例:仮想マシン、ファイル、アプリケーション)を指します。使用可能容量とは、Veeamの重複排除および圧縮処理後にアプライアンス内で利用可能なストレージ領域です。ARTESCA+ Veeamアプライアンスはソースデータ量(例:10~120TB)に基づいてサイズ設定され、標準的なVeeamバックアップ効率、保持期間、不変性をサポートするための内蔵容量余裕を備えています。サイズ設定の推測作業は不要です。

これは小さな規模の環境だけを対象としているのですか?(ARTESCA+ Veeam)

ARTESCA+ Veeamは、中規模企業環境やエッジ展開に最適です。10~120TBのソースデータを保護し、20~200台の仮想マシンをサポートします。小規模な構成はコンパクトサーバーで稼働可能、大規模な構成はフルラックマウントシステムまで拡張できます。

本番環境に触れない状態でバックアップを検証できますか?(ARTESCA+ Veeam)

はい。Veeam SureBackup Liteの組み込みサポートにより、本番環境に影響を与えることなく、バックアップの整合性チェックやテスト復元を実行できます。

この解決策は本当に安全ですか?説明してください。(ARTESCA+ Veeam)

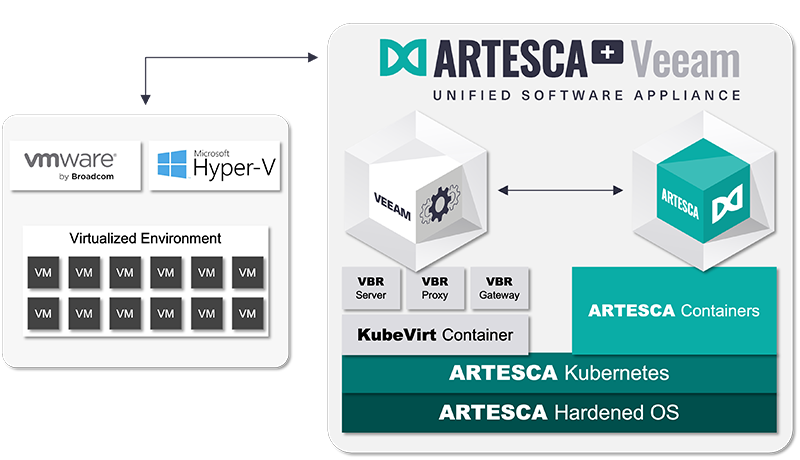
ScalityのCORE5ゼロトラストセキュリティフレームワークを基盤とするARTESCA+ Veeam統合ソフトウェアアプライアンスは、従来のシステムの複雑さを伴わずにエンドツーエンドのサイバーレジリエンスを必要とする組織向けに、エンタープライズバックアップソリューションを再定義します。CORE5は、不変性、認証情報の分離、最小権限アクセス、保存時および転送時の暗号化、ルートアクセスを許可しない強化OSを強制することで、APIからインフラストラクチャに至るシステムのあらゆるレベルで堅牢な保護を実現します。

ARTESCA+ Veeamは、バックアップとストレージを安全で統合された環境に統合し、リスク露出を低減するとともにゼロトラスト保護を強制します。以下の主要要素がソリューションのセキュリティを強化します:

  • ARTESCA OS: Scalityが開発・保守する専用セキュリティ最適化Linuxディストリビューション。必要最小限のパッケージのみを搭載し、root権限やスーパーユーザー権限を一切付与しません。
  • Veeamはこの強化環境内で動作するため、基盤OSの範囲が広くバックアップセキュリティに特化していない従来のVeeam-on-ESXi導入と比較して、攻撃対象領域を全体的に縮小します。
  • Veeamのようなサードパーティ製コンポーネントを追加しても、セキュアなアーキテクチャとゼロトラストの適用は完全に維持されます。
  • VeeamとARTESCAストレージコンポーネント間の内部専用通信により以下が保証されます:
    • 外部からアクセス可能な公開S3エンドポイントが存在しない
    • 外部DNS解決が不要
    • IAMアクセスキーやシークレットキーがアプライアンス外に共有されることは一切ない
  • ゼロトラストの徹底:最小権限の原則に従い、必須のポートとサービスへのアクセスのみを許可。MFA対応のUIアクセスとデフォルト拒否のファイアウォールルールを採用。
  • Windowsアクセス(VBR v12をサポートするため)は、多要素認証を備えたARTESCAのID管理を通じて管理可能。

オールインワン・アプライアンスの本当のメリットは何ですか?(ARTESCA+ Veeam)

ハードウェアの削減。コストの低減。迅速な導入。煩わしさの軽減。ただし明確にしておきましょう:すべての「オールインワン」アプライアンスが同等の性能を持つわけではありません。

固定されたハードウェアと独自スタックに縛られる従来のバックアップアプライアンスとは異なり、ARTESCA+ Veeamは完全なソフトウェア定義ソリューションです。シンプルさを損なうことなく、お好みのハードウェア上で動作します。これにより、別個のバックアップサーバーが不要になり、統合作業が軽減され、日常業務が簡素化されます。単一の統合ダッシュボードからARTESCAとVeeamの両方のメトリクスを一元監視でき、可視性と制御が効率化されます。統合のメリットをすべて享受しながら、ロックインは一切ありません。

オブジェクトストレージでVeeamを使用するだけの場合と、これはどう違うのですか?(ARTESCA+ Veeam)

ARTESCA+ Veeamソリューションでは、Veeamは単にオブジェクトストレージに書き込むだけでなく、アプライアンスに組み込まれています。Veeamサーバー、プロキシ、ゲートウェイの各コンポーネントは、ARTESCA OSによって管理されるセキュアなマイクロサービス環境内に直接デプロイされます。

これは従来のVeeam導入とどのように異なるのでしょうか?(ARTESCA+ Veeam)

従来、Veeamのバックアップ管理ソフトウェアとバックアップストレージには別々のインフラが必要でした。ARTESCA+ Veeamでは、両コンポーネントが安全なコンテナ化された環境内の単一サーバー上で共同稼働します。別々のサーバーも、手動での統合も不要です。これにより導入が簡素化され、セットアップ時間が短縮され、インフラコストが削減されます。

現在の標準的なVeeam導入環境は一般的にどのような構成になっていますか?(ARTESCA+ Veeam)

多くの組織では、Veeamとオブジェクトストレージを別々のインフラストラクチャに展開しています。これにより、Veeam Backup & Replicationとストレージバックエンド用に、物理サーバーまたは仮想サーバーを個別に用意する必要が生じることがよくあります。このアプローチはリスクの増加とオーバーヘッドの増大をもたらします:

購入・設定・保護・保守が必要なインフラ層の増加
システムとライセンスの重複による複雑さとコストの2倍化
認証情報の拡散やDNSの露出を含む攻撃対象領域の拡大
統合ポイントとトラブルシューティングの増加による導入期間の長期化
ARTESCA+ Veeamは、両コンポーネントを単一のセキュアなソフトウェアアプライアンスに統合することで、この課題を解消します。

どのバージョンのVeeamがサポートされていますか?(ARTESCA+ Veeam)

このアプライアンスは、WindowsおよびLinux環境において、Veeam Backup & Replication v12およびv13をサポートします。Direct-to-Object、SureBackup Lite、Instant Recovery、Object Lock、SOSAPIを含む、Veeamの主要な機能すべてがサポートされています。

これはハードウェアアプライアンスですか?(ARTESCA+ Veeam)

違います。 ARTESCA+ Veeamはソフトウェアのみのソリューションであり、業界標準のハードウェア上で自由に実行できます。この柔軟性によりコスト削減が可能となり、ベンダーロックインを回避できます。

ARTESCA+ Veeamは、他のARTESCAアプライアンスや導入オプションと比べてどう違いますか?(ARTESCA+ Veeam)

従来のARTESCAアプライアンス(ソフトウェア専用/ハードウェアベースを問わず)は、Scalityオブジェクトストレージソフトウェアのみに焦点を当てていました。ARTESCA+は新たなモデルを導入します:ARTESCAと業界最高クラスのサードパーティ製アプリケーションを統合したユニファイドソフトウェアアプライアンスです。本ソリューションでは、Veeam Backup & ReplicationをScalityプラットフォームに直接統合し、バックアップとストレージの両方を単一ソリューションで実現します。

この「+」アプローチは、スタンドアロン型ストレージから根本的な転換を意味します。特にリソース制約のある環境において、導入・管理・運用を簡素化する共同設計ソリューションの特徴は以下の通りです:

1台のアプライアンス、1回のインストール:VeeamとScalityが単一サーバー上で完全に統合され、ソフトウェアのみで動作。選択したハードウェアに即導入可能。
単一管理画面:統合ダッシュボードにより、ストレージとバックアップの両オペレーションを可視化。稼働状況、パフォーマンス、容量のメトリクスをリアルタイムで一元管理。
TCO削減:インフラを統合するARTESCA+ Veeamは、従来の多層バックアップ環境に比べ、導入コストと運用コストを最大30%削減。

ARTESCA+ Veeamとは何ですか?(ARTESCA+ Veeam)

ARTESCA+ Veeamソリューションは、従来のシステムの複雑さを伴わずに強力な保護を必要とする組織向けに、エンタープライズバックアップソリューションを再定義します。この統合ソフトウェアアプライアンスは、Veeam Backup & ReplicationとScality ARTESCAサイバーレジリエントオブジェクトストレージを単一のセキュアなプラットフォーム上に統合。導入と運用を簡素化し、サイバーレジリエンスを強化、TCOを30%削減します。要約:1台のボックス。最高峰のソフトウェア。組み込み型ランサムウェア耐性。追加インフラ不要。

StarWind HAを新しいハードウェアに移行する最も適切な方法は何か?

StarWind VSAN と StarWind VSAN Best Practices に従って生産環境が設定されている場合、ハードウェアのアップグレードは通常、ダウンタイムを必要としません。以下に、2ノード構成でのハードウェアアップグレードの手順を説明します。Windows クラスターでは、この手順は新しいノード 1 と 2 に Windows とともにその役割と機能が既にインストールされ、構成されていることを前提としています。この手順では、各サーバーがメンテナンス中に生産環境全体をホストできることも前提としています。

2ノード構成でStarWind HAを新しいハードウェアにマイグレーションする手順:

  • 1. 古いノード1のターゲットをすべてのクライアントサーバーから切断します。
  • 2. StarWind Management Consoleで古いノード2のHAデバイスを右クリックし、Replication Managerを選択します。
  • 3. レプリケーション マネージャー ウィンドウで、HA デバイスのレプリカを削除します。この手順を各 HA デバイスに対して実行します。
  • 4. 古いノード 1 をシャットダウンします。
  • 5. 古いノード 2 の同期リンクを新しいノード 1 サーバーに接続します。
  • 6. 新しいハードウェアがインストールされた新しいノード 1 を起動します。
  • 7. 新しいノード 1 と古いノード 2 間の同期リンクを構成します。
  • 8. 新しいノード 1 に StarWind VSAN をインストールし、新しいインストールにライセンス キー ファイルを適用します。
  • 9. StarWind Management Console で、古いノード 2 の HA デバイスを右クリックし、レプリケーション マネージャーを選択します。
  • 10. レプリケーション マネージャー ウィンドウで、レプリカを追加ボタンをクリックします。ウィザードの手順に従って、新しいノード 1 に HA デバイスのレプリカを設定します。この手順を各 HA デバイスに対して実行します。
  • NOTE: 前のデバイスが同期を完了するまで、次のデバイス レプリカを追加しないことをおすすめします。
  • 同期が完了したら、新しいノード 1 をクライアント サーバーに接続します。
  • 古いノード 2 のターゲットをすべてのクライアント サーバーから切断します。
  • StarWind Management Console で、新しいノード 1 の HA デバイスを右クリックし、Replication Manager を選択します。
  • レプリケーション マネージャー ウィンドウで、HA デバイスのレプリカを削除します。この手順を各 HA デバイスに対して実行します。
  • 古いノード 2 をシャットダウンします。
  • 新しいノード 1 の同期リンクを新しいノード 2 サーバーに接続します。
  • 新しいノード 2 を起動します。
  • 新しいノード 2 と 1 間の同期リンクを設定します。
  • 新しいノード 2 に StarWind VSAN をインストールし、新しいインストールにライセンス キー ファイルを適用します。
  • StarWind Management Console で、新しいノード 1 の HA デバイスを右クリックし、Replication Manager を選択します。
  • Replication Manager ウィンドウで、Add Replica ボタンをクリックします。
  • ウィザードの手順に従って、新しいノード 2 に HA デバイスのレプリカを設定します。この手順を各 HA デバイスに対して実行します。
  • NOTE: 前のデバイスが同期を完了するまで、次のデバイス レプリカを追加しないことをおすすめします。
  • NOTE: Heartbeat Failover 戦略で作成された HA デバイスについては、Heartbeat リンクの接続と設定も必ず行ってください。
  • 同期が完了するまで待ちます。
  • 同期が完了したら、新しいノード 2 をクライアント サーバーに接続します。

ストレージプールとは何ですか?また、どのように変更しますか?

ストレージプールは、StarWind仮想ディスク(LSFS専用ファイル、*.imgなど)を配置するデフォルトのパスです。

デフォルトのストレージプールパスを変更するには、以下の手順を実行してください:

  • StarWind Management Consoleを開きます。
  • ストレージ プールのパスを変更したいサーバーを選択します。
  • 構成 タブをクリックし、次に を選択します。
  • StarWind Management Console の右上にある 変更 をクリックします。
  • 表示されるポップアップ ウィンドウで、ストレージ プール タブを選択します。
  • ストレージ プールの新しいデフォルト パスを選択します。

HAデバイスを「ターゲットの追加ウィザード」で作成する際、「同期とハートビートチャネル用のインターフェースを指定する」というステップがあります。必要な1つのIPを選択したにもかかわらず、ウィザードが自動的に同じサブネットワーク内のすべてのIPを選択するのはなぜですか?

私たちは、すべてのデータリンクを専用サブネットに接続することを強く推奨します(すべての同期チャネルとハートビートを含む)。IPアドレスを選択すると、ウィザードは自動的にそのサブネット内のすべてのIPアドレスを予約します。これは、ハートビートと同期チャネルを同じデータリンクに割り当てることでHA(高可用性)の設定ミスからStarWind VSANユーザーを保護するためです。