投稿者「climb」のアーカイブ

StarWind VTL: Wasabi向けのストレージゲートウェイの提供

はじめに

現代のバックアップシステムは、「3-2-1のバックアップルール」に従っており、バックアップコピーを1つは安全なオフサイト(社外)の場所に保管することを推奨しています。これにより、プライマリインフラストラクチャやローカルバックアップが侵害された場合でも、ビジネスデータへのアクセスを確保でき、企業は迅速に復旧することが可能になります。

課題

ランサムウェア攻撃は、企業のデータにとって重大な脅威となっています。オフサイトバックアップは自然災害からデータを保護できますが、ランサムウェアに感染してしまうと、それらのバックアップも無用の長物となってしまいます。

物理テープにリモートバックアップを保存することはランサムウェアからの保護にはなりますが、テープインフラの維持や、オフサイトの保管庫への定期的なテープ輸送に多額のコストがかかります。さらに、災害発生時にバックアップデータにアクセスすることは、時間のかかる課題となります。

解決策

StarWind VTLは、S3 APIプロトコルを介してWasabiへのストレージゲートウェイとして機能することで、オフサイトバックアップがランサムウェアから完全に保護されることを保証します。Wasabiのオブジェクトロック機能により、バックアップは保持期間を通じて不変となり、ランサムウェア攻撃から確実に守られます。

StarWind VTLはバックアップソフトウェアとWasabiを連携させることで、予算が限られている場合でも、オフサイトバックアップをより手頃な価格で実現します。Wasabiはホットクラウドストレージにおいて非常に競争力のあるTB単価を提供し、不要な費用を削減します。さらに、Wasabiは迅速なバックアップ復元を可能にし、災害発生後も企業が迅速に業務を再開できるよう支援します。

まとめ

StarWind VTLは、S3 APIを介してWasabiへのストレージゲートウェイとして機能することで、Wasabiのオブジェクトロック機能を活用し、オフサイトバックアップを自然災害やランサムウェアの両方から確実に保護します。Wasabiの低コストなクラウドストレージと迅速な復元機能により、企業はコスト効率と迅速な復旧の両方を実現できます。


詳細手法はこちら

Google Workspace向けベストバックアップソリューションに関する総括

なぜGoogle Workspaceのバックアップが必要なのでしょうか?

Googleは自社が提供するインフラストラクチャについてのみ責任を負い、データの保護についてはお客様ご自身の責任となります。Google Workspaceの包括的なバックアップ対策が講じられていない場合、データの損失、保存期間の不備、およびコンプライアンス上の問題が生じるリスクがあります。

ユーザは以下の事項について責任を負います:

  • データのバックアップ、復元、および可用性
  • 監査ログの透明性
  • セキュリティ:フィッシング対策

Google Workspaceのバックアップソリューションを選ぶ際、どのような点を確認すべきでしょうか?

  • 複数のテナントの管理は、どの程度簡単ですか?

  • バックアップには何が必要ですか?

  • どのような連携が必要ですか?

  • そのベンダーには、他にも有益な製品はありますか?

  • 追加のバックアップストレージオプション(BYOC、ホスト型ストレージ、またはその両方)はありますか?

  • 細かいレベルでの復元機能はサポートされていますか?

  • 彼らの料金体系はどのようなものですか?

  • ベンダーは長期契約のみを求めているのでしょうか?

Veeam Backup & Replication(以下Veeam)を使用してHyper-VとNutanix AHV仮想基盤をバックアップする場合を比較

Veeam Backup & Replication(以下Veeam)を使用して仮想基盤をバックアップする場合、Hyper-VとNutanix AHVでは、その仕組みや運用の手軽さにいくつかの違いがあります。

それぞれの環境でVeeamを活用する際の長所と短所を比較表にまとめました。


比較まとめ

比較項目 Microsoft Hyper-V Nutanix AHV
アーキテクチャ Windowsベース:Veeamサーバーが直接管理(コンポーネントの導入が容易)。 アプライアンスベース:専用のAHV Proxy(仮想アプライアンス)を展開して管理。
バックアップ方式 VSS(Volume Shadow Copy Service)を利用した標準的な方式。 NutanixのSnapshot APIを利用。クラスタ全体に負荷を分散しやすい。
リストア機能 Instant VM Recovery(即時復旧)など全機能がフル活用可能。 Instant Recoveryは可能だが、以前は制限があった。最新版(v13〜)で統合が進展。
運用の容易さ Windows管理者には馴染み深いが、Windows Updateの影響を受けやすい。 Prism連携によりシンプル。ただし、専用Proxyの管理が1つ増える。
コスト Windows Serverライセンスに付随。追加費用を抑えやすい。 AHV自体は無料(Nutanix OSに含む)。Veeamのライセンス体系は共通。

1. Hyper-Vで使用する場合

Hyper-V環境はVeeamにとって古くからの主要プラットフォームであり、OS(Windows)との親和性が非常に高いのが特徴です。

長所(メリット)

  • フル機能のサポート: Instant VM Recovery、SureBackup(自動検証)、アイテム単位の復旧など、Veeamの全機能を最も安定して利用できます。

  • シームレスな統合: Veeam自身がWindows上で動作するため、管理サーバーとHyper-Vホスト間の連携が直接的で、ネットワーク構成や権限管理がシンプルです。

  • 柔軟なストレージ選択: バックアップ先(リポジトリ)としてWindowsサーバーをそのまま使えるため、既存資産を活かしやすいです。

短所(デメリット)

  • Windowsのオーバーヘッド: ハイパーバイザー自体がWindows OSであるため、パッチ適用や再起動といったOSメンテナンスの手間がつきまといます。

  • VSSの依存度: バックアップ時にWindows標準のVSSを利用するため、稀にVSSエラーによるジョブ失敗が発生し、切り分けに時間がかかることがあります。


2. Nutanix (AHV) で使用する場合

Nutanix AHVで使用する場合、Veeamは「AHV Proxy」という仲介役を通じてバックアップを行います。

長所(メリット)

  • HCI最適化: Nutanix独自のAPI(Snapshot API)を利用するため、仮想マシンに負荷をかけずに高速なバックアップが可能です。

  • シンプルな運用: Nutanix Prism(管理画面)と連携し、エージェントレスで効率的に保護できます。

  • V2V移行の容易さ: Veeamを介して、VMwareやHyper-VからNutanix AHVへの移行(またはその逆)が非常にスムーズに行えます。

短所(デメリット)

  • 専用Proxyが必要: バックアップを実行するために、Nutanixクラスタ上に「AHV Proxy」というLinuxベースの仮想アプライアンスを立てる必要があります。

  • 一部機能の世代差: 歴史の長いHyper-V版に比べると、以前は「即時復旧」の挙動や細かいリストアオプションで制限がある時期がありました(※最新のVeeam Data Platform v13等では大幅に改善されています)。


結論:どちらを選ぶべきか?

  • Hyper-Vが向いているケース: すでにWindows Serverの管理スキルが社内にあり、Active DirectoryなどのMicrosoftエコシステムと密接に統合された環境を好む場合。

  • Nutanix AHVが向いているケース: インフラのシンプルさ(HCIのメリット)を最大化し、ハードウェアからハイパーバイザーまで一貫したサポートと運用効率を求める場合。

Veeam自体のライセンス(VUL: Veeam Universal License)は共通なので、将来的にHyper-VからAHVへ移行する場合でも、ライセンスを無駄にすることなくスムーズに切り替えられるのが強みです。

StarWindは構造化データワークロードをどのようにサポートしますか?

StarWindは、パフォーマンス、可用性、および迅速な復旧が重要な仮想化環境向けに共有ストレージを提供することで、構造化データワークロードをサポートします。これにより、一貫したストレージ動作を必要とするデータベース、ERPシステム、およびその他のビジネスクリティカルなアプリケーションに最適です。


構造化データと非構造化データの比較[ブログ]

構造化データと非構造化データの比較

AIやRAGにとって、非構造化データはなぜ重要なのでしょうか?

文書、メール、チケット、チャット履歴などには貴重な知識が含まれているため、非構造化データはAIや検索強化生成(RAG)にとって極めて重要です。AIの回答の質は、こうしたコンテンツをどれだけ適切にインデックス化、チャンク化、埋め込み、保存できるかにかかっています。ソースデータの整理が不十分だと、検索精度が低下し、不正確な出力が生じることになります。


構造化データと非構造化データの比較[ブログ]:

構造化データと非構造化データの比較

どの種類のデータが最も分析しやすいでしょうか?

構造化データは、すでに一貫性のあるフィールドに整理されているため、生の状態で最も分析しやすいです。半構造化データは、通常、分析の前に解析処理が必要です。非構造化データからは、インサイトを抽出する前に、インデックス作成、文書処理、全文検索、またはAIツールの活用が必要となります。


構造化データと非構造化データの比較[ブログ]

構造化データと非構造化データの比較

半構造化データとは何ですか?

半構造化データは、構造化データと非構造化データの中間に位置します。リレーショナルテーブルにはきっちりと収まりませんが、タグ、キー、メタデータ、またはネストされた階層構造を含んでおり、機械が読み取れる形式となっています。代表的な例としては、JSON、XML、APIペイロード、イベントログ、テレメトリデータなどが挙げられます。


構造化データと非構造化データの比較[ブログ]

構造化データと非構造化データの比較

構造化データと非構造化データの違いは何ですか?

構造化データは固定されたスキーマに従い、行と列で保存されます。SQLを使用してクエリを実行したり、ダッシュボードで活用したりすることができます。非構造化データにはあらかじめ定義された形式がなく、文書、メール、画像、チャットログなどが含まれます。構造化データはレポート作成やトランザクション処理に最適です。非構造化データは、文脈の把握、検索、知識の抽出に適しています。


構造化データと非構造化データの比較[ブログ]

構造化データと非構造化データの比較

Microsoft 365 データ保護における6つの重大なミス

Veeamによると、76%の企業がクラウド上でデータ損失を経験している一方で、半数の企業は、ファイルが大量に削除された場合、データを復元することは不可能だと考えている。これらは、Microsoft 365のデータ保護に関して組織が犯しがちな過ちである。


クラウドアプリケーションは、組織にさまざまなメリットをもたらします。特に、ビジネスに不可欠なファイルやサービスにどこからでもアクセスできるため、従業員はオフィスにいてもリモートワーク中でも、場所を問わず生産性を維持できます。しかし、クラウドを活用することは、バックアップやデータ保護に関する新たなミスやエラーを招く可能性もあります。


間違いその1:データ保護をMicrosoft 365の組み込みツールに依存すること

多くのITリーダーは、OneDrive、SharePoint、Exchange Onlineがデータを自動的に保護してくれると想定しています。60%が、Microsoft 365がファイルを自動的に保護していると信じています。しかし、実際はそうではありません。

Microsoft 365の責任分担モデルに基づくと、完全なデータバックアップは提供されません。組み込みの復元ツールは、削除されたファイルを30日から90日間保存した後に、完全に削除してしまいます。


間違いその2: ランサムウェア攻撃の脅威を無視する

ランサムウェアは企業にとって依然として大きな問題となっています。特に、サイバー犯罪者がデータを暗号化するだけでなく、身代金が支払われない場合は削除すると脅迫してくる場合です。管理者アカウントへのリモートからの不正アクセスは、リスクをさらに高めます。

残念ながら、Microsoft 365はクラウドデータに対する自動的なランサムウェア保護を提供しておらず、攻撃者が要求する身代金を支払わない場合、被害者は大量のファイル削除に直面することになります。そして、身代金を支払ったとしても、攻撃者がデータを削除してしまう可能性は依然として残っています。

Climb Cloud Backup (CCB)の時間制限のない自動バックアップ機能により、削除から数年経った後でもデータの復元が可能です。一方、CCBの不変バックアップは別のクラウドに保存されるため、ハッカーがファイルを完全に削除することはできず、ランサムウェア攻撃によるデータ削除から組織を保護します。


間違いその3:内部脅威に対する保護対策の不備

ITリーダーは、外部からのサイバーセキュリティ脅威に強く注力しています。しかし、危険はそれだけではありません。内部脅威は、外部からの脅威よりもデータにとってさらに大きなリスクとなり得ます。これは、管理者のミスによるデータ損失のような不注意なケースもあれば、不満を抱いた従業員が意図的にデータを消去するようなケースもあります。


間違いその4:データ保護規則への不遵守

クラウドアプリケーションはグローバルなエコシステムで稼働していますが、多くの企業は自社のデータ保護プロセスが現地の規制に準拠しているかどうかを確認していません。一方、Microsoftの組み込みツールには、プライバシー関連法規で要求される長期的なデータ保持機能が備わっておらず、組織が数百万ドル規模の罰金や訴訟リスクにさらされる可能性があります。

CCB for Microsoft 365は、GDPRへの準拠を確保し、HIPAAのデータ保護要件を満たし、クラウドデータに対するSOC 2準拠をサポートします。さらに、業界固有のニーズに合わせた柔軟な保存ポリシーも提供します。


間違いその5:バックアップを元のデータと同じクラウドに保存する

多くの企業は、OneDriveやSharePointにバックアップを保存すれば適切だと考えていますが、それは元のデータと同じMicrosoft 365クラウドにバックアップを保存することを意味します。このシナリオでは、Microsoft 365アカウントが侵害された場合、攻撃者は元のデータとバックアップの両方を削除できてしまいます。CCBは、バックアップを独立して保存し、ハイブリッドストレージオプションを提供することでこの問題を解決します。これにより、必要に応じてバックアップをローカルサーバーにコピーすることが可能になります。


間違いその6:データ復旧計画が策定されていない

一部の企業は、バックアップを作成しているだけで十分だと考えていますが、データ復旧計画が機能するかどうかをテストすることは決してありません。サイバー攻撃やサービス停止といった実際のインシデントに見舞われて初めて、バックアップが不完全であることや、そもそもデータ復旧計画が策定されていないことに気づくのです。クライム/CCBなら、定期的な復旧シミュレーションによるデータの常時復旧性の確保と、即時のファイル復元機能により、組織がこの問題を回避できるよう支援します。


まとめ

これら6つのミスは、Microsoft 365のデータを深刻なリスクにさらします。IT管理者はこれらの問題を理解し、データを確実に保護するために必要な対策を講じる必要があります。

CCB for Microsoft 365は、これらのリスクを排除する包括的なソリューションを提供します。今すぐデモをリクエストして、データの保護を確実なものにしましょう!

Nutanix と「Hyper-V + StarWind vSAN」の比較について

Nutanixと「Hyper-V + StarWind vSAN」は、どちらもHCI(ハイパーコンバージドインフラ)的な構成を実現できますが、その設計思想やターゲット、コスト構造は大きく異なります。

それぞれの特徴を比較したメリット・デメリットをまとめました。


1. 比較概要

比較項目 Nutanix (Cloud Infrastructure) Hyper-V + StarWind vSAN
主なターゲット 中大規模〜エンタープライズ 小規模〜中規模、エッジ、ROBO
スケーラビリティ 非常に高い(数百ノード以上可能) 中程度(2ノード構成に強み、数〜十数台)
管理の容易さ Prism による統合管理(極めて容易) Hyper-VとStarWindを個別に管理
ライセンスコスト 高め(機能・サポート込み) 低め(既存資産の活用が可能)
ハードウェア 専用アプライアンスまたは認定品 汎用IAサーバ(自由度が高い)

2. Nutanix の長所・短所

Nutanixは「インフラを意識させない」ことを目的としたフルスタックのHCIソリューションです。

メリット (長所)

  • 圧倒的な運用性: 「Prism」という管理ツールにより、ストレージ、仮想マシン、ネットワーク、バックアップ、アップデート(ワンクリック・アップグレード)を一つの画面で完結できます。

  • データローカリティ: データをVMが動いているノードに優先的に配置するため、ネットワークトラフィックを抑え、安定したパフォーマンスを発揮します。

  • ハイパーバイザーの選択肢: 独自のAHV(無料)のほか、ESXiやHyper-Vも選択可能です。

  • 高度な機能: 重複排除、圧縮、イレイジャーコーディング、セルフヒーリング(自己修復)などが標準で高度に組み込まれています。

デメリット (短所)

  • 導入コストが高い: ライセンス費用に加え、サポート費用もエンタープライズ価格となります。

  • 最小構成のハードル: 基本的に3ノード以上が推奨されます(2ノード構成も可能ですが制約があります)。

  • リソース消費: 管理用の仮想マシン(CVM)が各ノードで一定のメモリとCPUを消費するため、小規模環境ではオーバーヘッドが目立ちます。


3. Hyper-V + StarWind vSAN の長所・短所

StarWindは、Windows Serverの標準機能であるHyper-Vを補完し、安価に共有ストレージ環境を作るためのソフトウェアです。

メリット (長所)

  • 圧倒的なコストパフォーマンス: Windows Serverのライセンスを有効活用でき、Nutanixに比べてライセンス費用を大幅に抑えられます。

  • 2ノード構成に最適: StarWindは2台のサーバを直接LANケーブルで結ぶ(スイッチレス)構成が得意で、最小限の機器で冗長化が可能です。

  • 既存ハードウェアの流用: 特定のベンダーに縛られず、一般的なIAサーバで構築できるため、ハードウェア選定の自由度が高いです。

  • 軽量な動作: NutanixのCVMに比べ、StarWindのサービスはリソース消費が少なく、ハードウェア性能をVMに回せます。

デメリット (短所)

  • 管理の分離: Hyper-Vの管理(Failover Cluster Manager)と、StarWindのストレージ管理、さらにハードウェアの管理が別々になるため、運用に手間がかかります。

  • 拡張性の限界: 数十台規模まで拡張する場合、管理の複雑性が増し、Nutanixのようなシームレスな拡張は難しくなります。

  • スキルセットが必要: Windows ServerとiSCSIストレージの両方の知識が必要であり、トラブル時の切り分けもユーザー側で行う場面が増えます。


4. どちらを選ぶべきか?

  • Nutanix が向いているケース:

    • 管理の手間を極限まで減らしたい。

    • 将来的にノードをどんどん増やしていく予定がある。

    • ミッションクリティカルなシステムで、手厚いメーカーサポートが必要。

    • キーワード: 「運用自動化」「スケーラビリティ」「エンタープライズ」

  • Hyper-V + StarWind vSAN が向いているケース:

    • 予算が限られている。

    • 2ノード〜4ノード程度の小規模なクラスタを作りたい。

    • Windows Serverの管理に慣れているエンジニアがいる。

    • キーワード: 「コスト削減」「省スペース」「小規模拠点」

補足: Nutanixも最近は小規模向けのライセンスを提供していますが、それでも「シンプルさ」と「安さ」では依然として StarWind + Hyper-V に軍配が上がることが多いです。

データベースのストレージ最適化に関するFAQ

TempDBのデータファイルはいくつ使用すべきですか?

実用的な目安としては、論理CPUコア1つにつき1つのTempDBデータファイル(最大8つまで)を使用し、すべてのファイルを同じサイズに設定することです。それ以降は、競合状況や監視結果に基づいて変更を検討してください。


データベースに複数のトランザクションログファイルを使用すべきですか?

ほとんどの場合、必要ありません。適切なサイズで、増分が固定された単一のログファイルの方が管理が容易であり、通常はパフォーマンスも向上します。主な例外は、トランザクション・ログがディスク全体を埋め尽くしてしまう場合です。ログファイルを拡張する余地がなく、ログファイルが満杯になったためにそのデータベースへの書き込みが停止している場合、別のディスクに2つ目のログファイルを追加することは、短期的な対策として妥当な場合があります。それでも、データベースを単一のログファイルに戻すために、後でログを再構築するよう努めます。


パーセンテージベースの自動拡張は避けるべきですか?

必ずしもそうとは限りませんが、予測不可能性が生じます。固定サイズの自動拡張の方が理屈が分かりやすく、ファイルが大きくなるにつれてサイズが急激に跳ね上がるのを防げます。


ストレージが本当にボトルネックかどうかはどうやって判断すればよいですか?

待機統計とファイルレベルのI/Oメトリクスを長期的に確認してください。レイテンシや待機が特定のファイルや操作と一致している場合、調査すべき具体的な箇所が特定できます。

すでに過負荷状態にある場合、どこから手をつければよいでしょうか?

可視性とリスクが最も高い箇所から着手してください。具体的には、TempDB、トランザクションログのサイズ設定、および基本的なI/Oモニタリングです。これらの変更は、パフォーマンスや安定性の向上、そしてチームへの時間的還元という点で、多くの場合、すぐに成果をもたらします。


TempDBとは:

SQL ServerにおけるTempDBを一言で言うと、「SQL Serverが作業場として使う、共有のゴミ捨て場兼スクラップ帳」です。

サーバが起動するたびに新しく作成され、再起動すると中身はすべて消去されるという、非常に特殊なシステムデータベースです。


主な役割

SQL Serverは、自分自身のメモリだけでは処理しきれない時や、一時的な保管場所が必要な時にTempDBを使います。

  • 一時オブジェクトの保存: ユーザーが作成した一時テーブル(#temp)やテーブル変数などを置く場所です。

  • 作業領域: 大きなデータのソート(並べ替え)、ハッシュ結合(JOIN処理)、重複削除(DISTINCT)などを行う際の作業スペースとして使われます。

  • 行バージョン管理: 「スナップショット分離レベル」などを使っている場合、変更前の古いデータを一時的にここに避難させます。


TempDBの4つの大きな特徴

  1. 再起動でリセットされる: SQL Serverサービスを再起動するたびに、TempDBは削除され、初期サイズで再作成されます。そのため、重要なデータをここに永続保存することはできません。

  2. ログ記録が最小限: 通常のデータベースと違い、リカバリ(復旧)を想定していないため、書き込みパフォーマンスを上げるためにトランザクションログの記録が簡略化されています。

  3. 全ユーザーで共有: 一つのインスタンス内にあるすべてのデータベースが、この一つのTempDBを共有します。

  4. 設定がパフォーマンスに直結する: みんなが使う「作業場」なので、ここが渋滞するとシステム全体の速度が低下します。

MSP360 BackupでのWasabi Covert Copy 活用

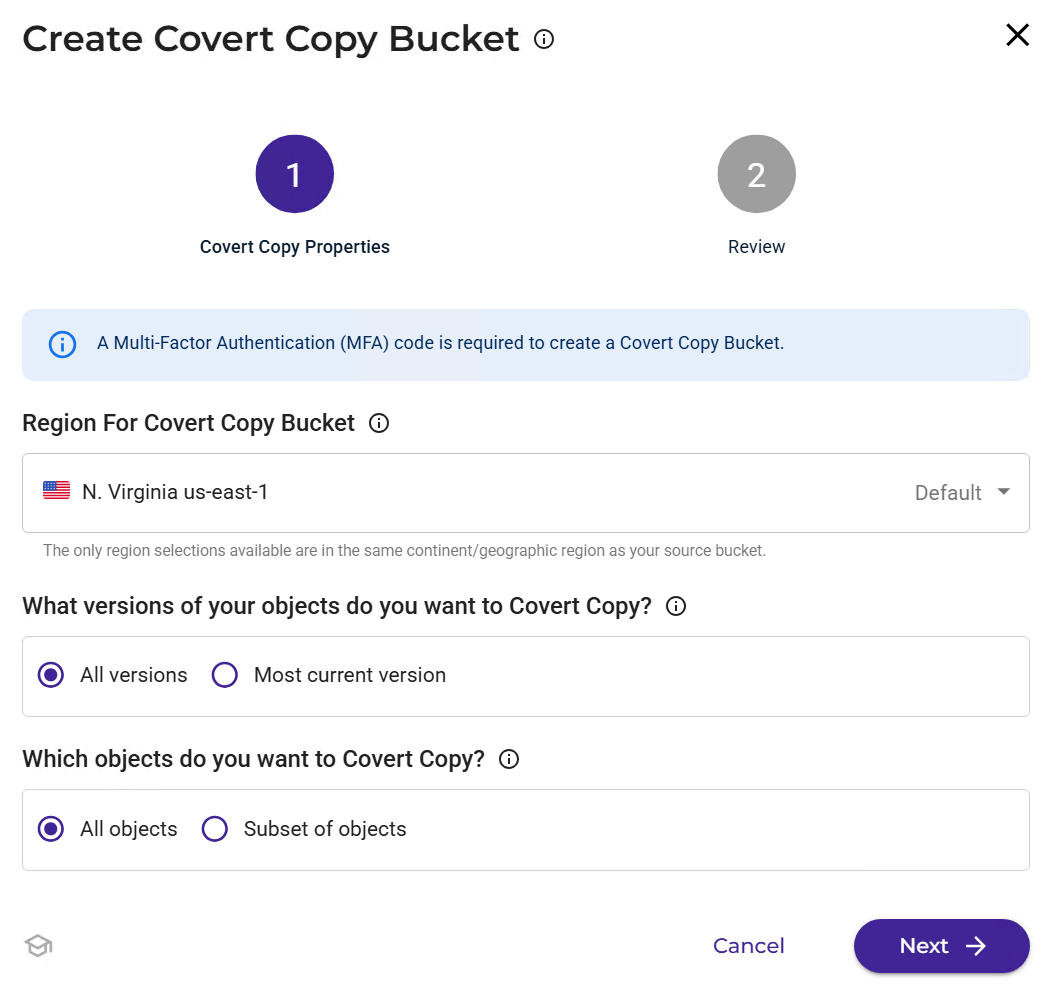
下記の記事では、他のバックアップコピーに影響を及ぼす災害が発生した場合に備えて、MSP360のバックアップの「ゴールデンコピー」を保護するために、WasabiのCovert Copyを使用する手順について説明します。

詳細は↓

https://docs.wasabi.com/docs/wasabis-covert-copy-feature-with-msp360-backup


HPE Morpheus VM Essentials – v8.1.0 のリーリース

主な新規機能情報:

●HPE Morpheus Software全体で単一のバイナリによるインストールが可能になりました。

●システムレベルの資産を一元管理するための新しいVMEシステムライブラリカタログが追加されました。

●ArubaCxDssセキュリティグループによるネットワークとセキュリティが強化されました。

●Zerto HPE VM DRのサポートが追加されました。

●パフォーマンスを最大化するため、NUMA L3境界に基づく自動vCPU配置。

●HVMネットワークのサポートが拡張され、Standard、Private、Data、Overlayネットワークがネイティブでサポートされるようになりました。

●ハイパーバイザーコンソールでのキーボードレイアウトのサポートが強化されました。

●HVMクラスタのアップグレード – アップグレードワークフローにより、クラスタのライフサイクル管理が合理化されました。

●Alletra MPプラグインの更新内容は多すぎて、ここではすべて記載できません。

●一括移行の改善:より高速で信頼性の高い移行が可能になりました。

HPE Zerto SoftwareがAWS Resilience Competencyパートナーの認定を取得

HPE Zerto SoftwareはAWSレジリエンスコンピテンシーパートナーとして認められ、サイバーリカバを含むレジリエンス設計、運用、復旧においてAWSの最高技術基準を満たしたことでコアレジリエンスの指定を取得しました。この検証により、クラウドIT専門家はAWS認証を受けたコンサルティングおよびエンジニアリングサービスを信頼して災害復旧、サイバー復旧、移行戦略を効率化できると保証します。

https://community.hpe.com/t5/multivendor-software/hpe-zerto-software-achieves-aws-resilience-competency-partner/td-p/7259288

wndowsファイルサーバからのバックアップについて

1台のWindowsシステムを複数のWindowsファイルサーバのバックアップ元として設定し、MSP360 Backupを使用してクラウドへバックアップを行う運用についてご連絡いたします。
この構成では、ハードウェアおよびMSP360 Backup本体に過度な負荷がかかり、トラブルの原因となる可能性が非常にあります。
システムの安定稼働のため、各Windowsシステムに対して1セットずつMSP360 Backupをデプロイすることを強く推奨いたします。

KVM(特にProxmoxやoVirtなど)環境でStarWind VSANを使用しているユーザ

この組合せはコストを抑えつつ2ノードでの可用性(HA)を確保したい中小企業やエンジニアの検証環境において、非常に人気のある組み合わせです。


1. 主なユーザ層と利用シーン

StarWind VSANはもともとWindows (Hyper-V) 環境に強いイメージがありましたが、現在はLinuxベースのCVM(Controller VM)を提供しており、KVMユーザの間でも一般的に使われています。

  • Proxmox VE ユーザ: KVMベースの仮想化OSであるProxmoxと組み合わせ、2台のサーバーだけで共有ストレージ不要のクラスタ(HCI)を構築するケースが非常に多いです。

  • oVirt / Red Hat Virtualization ユーザ: 企業向けのKVM管理プラットフォームで、共有ストレージとしてStarWindを採用し、高可用性を実現しています。

  • コスト重視の企業: 高価な物理SAN(外付けストレージ)を導入できない環境で、汎用サーバのローカルディスクを冗長化するために採用されています。


2. KVMユーザがStarWindを選ぶ理由

KVM標準の冗長化構成(CephやDRBDなど)と比較して、以下の点が評価されています。

  • 2ノード構成が可能: Cephなどは通常3ノード以上が推奨されますが、StarWindは「2ノード+外部ウィットネス(監視役)」で安定したHA構成が組めるため、ハードウェアコストを最小化できます。

  • 管理の容易さ: KVM/Linuxのコマンド操作に不慣れでも、Web GUIやWindowsの管理コンソールからストレージの同期状態を確認・管理できる点が好まれています。

  • パフォーマンス: 同期レプリケーションの効率が良く、SQL ServerやファイルサーバーなどのI/O負荷が高い業務アプリにも耐えうると評価されています。


3. 実際の導入構成例

多くのユーザが以下のような構成で運用しています。

  • 構成方法: KVMホスト上に「StarWind CVM (Controller VM)」という専用の仮想マシンをデプロイ。

  • ストレージ提供: CVMが各ホストのディスクをネットワーク経由でミラーリングし、iSCSIターゲットとしてKVMホストに再提供する。

  • ネットワーク: レプリケーション専用の10GbE以上の直結ラインを確保し、遅延を最小化する構成が一般的です。

4. ユーザの口コミ・評判(2026年時点)

ITレビューサイト(G2やTrustRadiusなど)では、以下のような声が見られます。

「Proxmoxクラスタを最小構成で組む際、Cephよりもセットアップが簡単で、パフォーマンスも安定している。」 「古いサーバーを再利用してKVMホストにしているが、StarWindを入れるだけでエンタープライズ級の共有ストレージが手に入った。」

DPAにおけるSQL Server ジョブの失敗:2026/01/22

dpa_sql_job_failure.txt

説明

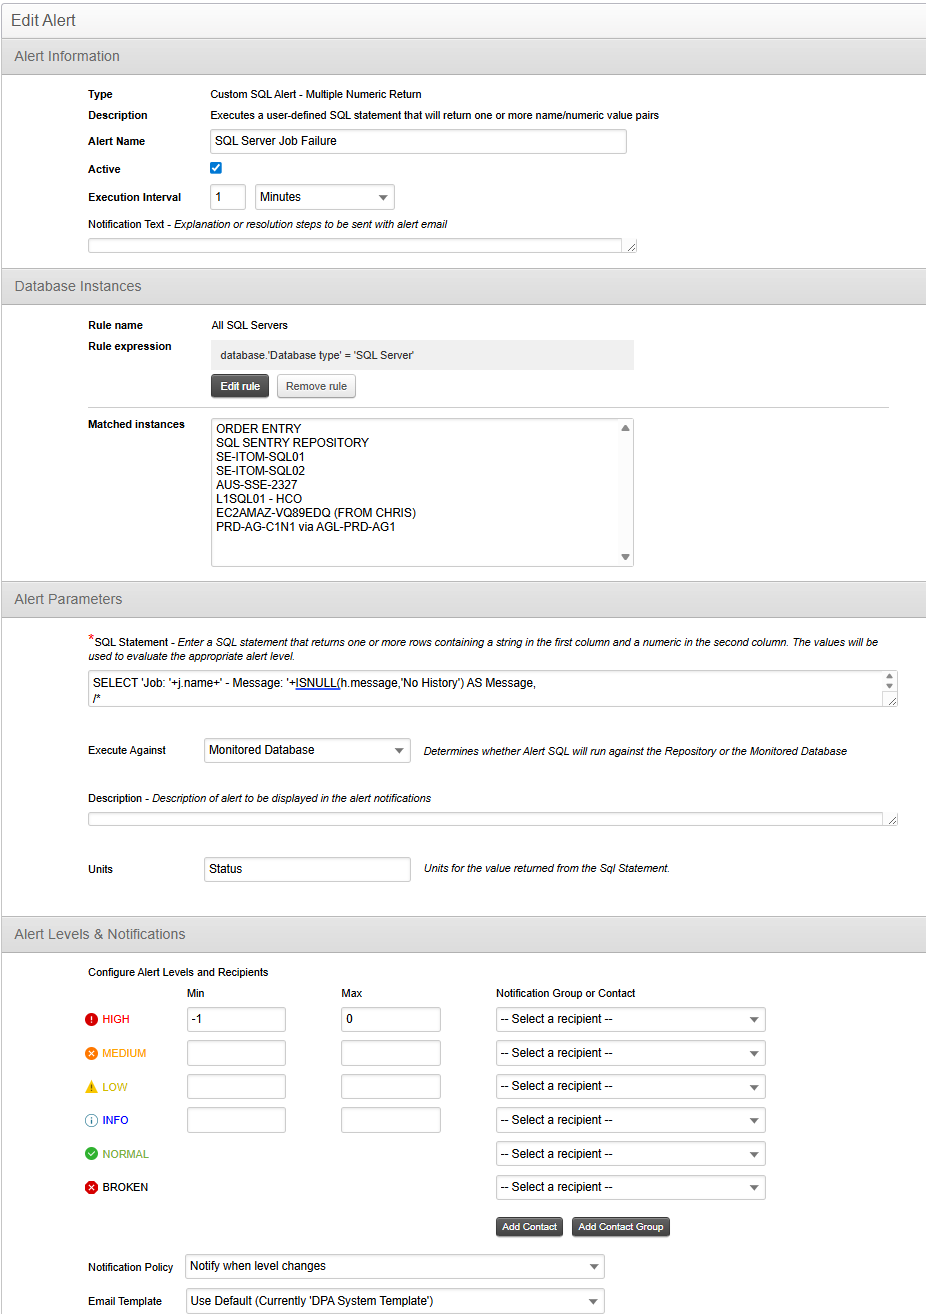
DPAには、ジョブステップのいずれかが失敗した際にトリガーされるデフォルトの「データベース・ジョブ失敗」アラートが用意されています。しかし、一部のジョブは条件分岐ロジックで設計されており、あるステップが失敗しても、後続のステップに処理が移行され、最終的に正常に完了する場合があります。そのような場合、ジョブは最終的に意図した通りに完了しているにもかかわらず、デフォルトのアラートが発動してしまう可能性があります。この拡張アラートは、真のジョブ失敗のみに焦点を当て、ジョブ全体が正常に完了しなかった場合に通知します。


アラートの定義

アラートを作成するには、アラート > アラートの管理に移動し、新しいカスタム SQL アラート – 複数の数値リターンを追加します。以下の設定を使用してアラートを構成し、添付のコードにある SQL をSQL ステートメントフィールドに貼り付けます。ステータスが正常ではない場合にトリガーされるよう、通知ポリシーを必ず更新してください。

image.png

AI Query Assist

1. AI Query Assistとは?

AI Query Assistは、生成AIと実行プランのコンテキストを活用して、パフォーマンス重視のSQL書き換えを提案するSolarWindsの機能です。

2. なぜ一般的なAIツールを使わないのですか?

一般的なAIツールには実行コンテキストが欠けていたり、機密性の高いクエリの詳細が漏洩する恐れがあります。AI Query AssistはSolarWindsのワークフローに組み込まれており、データベースのチューニングを目的に設計されています。

3. AI Query Assistはどのように機能しますか?

パフォーマンスの低いクエリを選択し、分析に送信すると、最適化されたバージョンと元のクエリを並べて確認でき、提案された変更点についての明確な説明も表示されます。

4. AI Query Assist はどこで利用できますか?

AI Query Assist は、SQL Sentry、Database Performance Analyzer (DPA)、および SolarWinds Observability SaaS で利用可能です。

5. 手動によるクエリチューニングの代わりになりますか?

いいえ。書き換えの段階を迅速化しますが、提案された SQL を展開するかどうかは、引き続きユーザー自身が確認、テスト、判断する必要があります。

データベースのパフォーマンス・チューニングと所要時間

パフォーマンスチューニングのようなことに関しては、「無駄な時間」という言葉にはあまり共感できません。確かに、誰もがそう感じることはあるでしょう。特に、何時間も費やした挙句、最初から間違った方向に進んでいたと気づいた時はなおさらです。


その代わり、それを「投資した時間」、つまり何かを学ぶために費やした時間だと捉えるようにすべきです。次にこう尋ねるべきです。「週に何時間、何かを学ぶために費やしていますか?」。これによって大抵、研修についての議論が始まり、そこから「実務を通じた」研修へと話題が移り、気がつけばまさに目指していた場所、つまりSQL文のパフォーマンスチューニングに費やす時間について話し合っているのです。


では、その時間はどれくらいになると見積もりますか?まだ答えないでください。開発、デプロイ、保守、本番サポート、管理など、あらゆる分野について考えてみてください。気づけば、時間の75%近くを単に処理を高速化しようとすることに費やしていることに気づくかもしれません。それはかなりの時間です!


もし、システムを高速化するためにそれほど多くの時間を費やすのであれば、できるだけ効率的に作業を進めたいと思うはずです。それを実現するには、待機イベントを活用します。


考え方は単純です。クエリが何を待っているのかが分かれば、そのボトルネックを取り除き、クエリの実行速度を向上させることができるのです。

オンプレミスでのバックアップの保護:StarWind VTLがVeeamと「3-2-1ルール」にどのように最適に適合するか

もし、ランサムウェアによってバックアップチェーン全体が暗号化されてしまう悪夢、あるいはさらに悪いことに、オフサイトのコピーまで被害に遭ってしまうという悪夢を見て、冷や汗をかいて目が覚めた経験はありませんか? 優れたチームであっても、こうした事態は起こり得ます。すべてがクラウドや脆弱なストレージ上に保存されているため、たった1回の侵害で数週間分の復旧手段が失われてしまうのです。ハッカーは、主にあなたのバックアップインフラを標的としています。(断言します)。だからこそ、私はオンプレミス環境を維持しつつ、セキュリティを多層的に強化するソリューションに情熱を注いでいます。本日は、ローカルストレージをランサムウェア対策済みの金庫へと変える画期的なソリューション、StarWind Virtual Tape Library(VTL)について深く掘り下げていきます。Veeam Backup & Replication(または他のツール)と組み合わせることで、テープをオフサイトに送る必要なく、黄金の「3-2-1」バックアップルールに完璧に適合します。なぜこれが次なる補完的なストレージ戦略となるべきか、技術的な側面から段階を追って解説していきます。


「3-2-1バックアップルール」— これは無視できません

このシンプルなルールを再確認しましょう。「3-2-1ルール」は単なる流行語ではありません。実世界の災害から生まれた、データ耐障害性の業界標準なのです。

これを守らないと後悔することになります。


  • データの3つのコピー:本番データのオリジナルに加え、少なくとも2つのバックアップ。
  • 2種類の異なるメディア:1つはディスク(高速アクセス)、もう1つはテープのようなもの(耐久性があり、オフライン)。
  • オフサイトコピー1つ: 火災、洪水、またはサイト全体の障害に対する地理的な保護のためです。


しかし、クラウドが完璧ではない場合もあります。クラウドによるオフサイト保存は便利ですが、インターネットに依存した復元や、潜在的なセキュリティ侵害、ダウンタイムのリスクにさらされます(最近のAzureやAWSのダウンタイムで、何百もの企業がオフラインになったことを覚えていますか?)。


そこで登場するのがStarWind VTLです。これはローカルディスク上でテープをエミュレートし、物理的なテープを使わずに「異なるメディア」を実現すると同時に、速度と管理性を確保するためにすべてをオンプレミスに保持します。このソリューションがどのようにしてこのルールを完璧に満たすかについては、こちらで詳しく説明します。


主なアーキテクチャの特徴:


エミュレーション層: 独自開発のソフトウェアを使用して、SCSIテーププロトコル(例:IBMやHPのライブラリ)をエミュレートします。1台あたり最大10,000本の仮想テープをサポートし、各テープの容量は100GBから100TBまで対応しています。RAIDプールにより、ペタバイト規模まで拡張可能です。


ストレージバックエンド:Linux(軽量なフットプリントが推奨)またはWindows上に展開し、冗長性のためにソフトウェアRAIDを使用します。ローカルドライブからプールを作成し、VTLデバイス用のボリュームを割り当てます。


設計による不変性:仮想テープはWORM(Write-Once-Read-Many)に準拠しています。一度書き込まれるとロックされ、ルートレベルの脅威による上書きも不可能です。これにより、バックアップは論理的にエアギャップが確保され、ランサムウェアが変更可能なターゲットを攻撃できなくなります。


階層化とレプリケーション: 長期保存のためのAWS S3/GlacierまたはBackblaze B2へのオプションのクラウドゲートウェイ。バックアップは当初オンプレミスに保持され、その後オフサイトへの自動レプリケーションが行われます。

Zerto + HPE Morpheus VME: 仮想化レジリエンスの未来

仮想化の状況は変化しており、柔軟性はかつてないほど重要になっています。組織が従来のハイパーバイザーに代わる現代的でコスト効率の良い選択肢を求める中、HPE Morpheus VM Essentials(VME)はハイブリッドクラウド時代に向けた強力なKVMベースのソリューションとして台頭しています。


HPE Morpheus Softwareにおける初のカーネルベースの仮想マシン(KVM)ベースのハイパーバイザーに対するプラットフォームサポートが拡張されたHPE Zerto Software v10.8.11。このリリースは、HPEから企業の災害復旧とサイバーの回復力を企業仮想化に提供します。

画像を表示

なぜこれが重要なのか:

長年にわたり、Zertoは秒単位のRPOと分単位のRTOの基準を設定してきました。この支援をHPE VMEに拡大することで、企業はサイバーのレジリエンスを犠牲にすることなくインフラを近代化する自由を与えられます
🔹 ジャーナルベースのブロックレベルレプリケーションによる継続的データ保護(CDP)— スナップショットではなく
🔹 5〜15秒ごとに回復ポイントが奪取され、数千のチェックポイントが最大30日間保持されます
🔹 RPOは秒単位で測定されます。RTOは数分単位で測定されます — 個々のVMまたは複数VMのアプリケーショングループ全体に対して
🔹 チェンジブロックトラッキングによるほぼ同期レプリケーション — 本番ストレージへのパフォーマンス影響ゼロ
🔹 仮想保護グループ(VPG)を用いた複数VMワークロード間のアプリケーション一貫性回復

VeeamとのHPE Morpheus VM Essentials統合がもたらす可能性を突き進む

データ主導の現代において、組織はリソースの最適化、コスト削減、および事業継続性の確保のために、仮想化技術への依存度を高めています。しかし、仮想環境における効率的なデータ保護とシームレスな管理への需要は、依然として極めて重要です。HPEの「Morpheus VM Essentials(HPE VME)」と、Veeamの業界をリードするデータ保護プラットフォームを統合することで、これらの重要なニーズに驚くほど容易かつ効率的に対応する強力なソリューションが実現します。ここでは、VeeamとのHPE VME統合の重要性と価値、エージェントレスバックアップの利点、そしてこれらのテクノロジーを導入することが現代のIT環境においてなぜ画期的な変化をもたらすのかについて解説します。


ブロードコムによるVMwareをめぐる騒動

現在のVMwareの市場環境は、ブロードコムによる買収に伴うライセンスおよびサポートの大幅な変更の影響を受けています。ブロードコムは新しいサブスクリプションモデルを導入し、これにより顧客のコストは3倍から15倍に跳ね上がり、利用可能な製品バンドルの数も減少しました。永久ライセンスの廃止や技術サポートの縮小は、顧客に大きな不安をもたらしています。調査によると、VMware顧客の32%が代替ソリューションを積極的に検討しており、2028年までに30%がVMware vSphereハイパーバイザーから他のプラットフォームへ移行すると予想されています。

代替ソリューションへの関心を高めている主な要因には、セキュリティ機能、スケーラビリティ、コスト、およびコンテナ化やクラウド戦略との整合性が挙げられます。組織は、VMの無秩序な増加、運用の複雑化、ベンダーロックインへの懸念といった課題に直面しており、ITチームはハイブリッドおよびマルチクラウド環境とシームレスに統合できる、費用対効果が高く柔軟な仮想化ソリューションの評価を迫られています。

VMwareの代替候補としては、以下が挙げられます:


  • HPE Morpheus VM Essentials Software:HPEのハイブリッドクラウドエコシステムと統合されたKVMベースのハイパーバイザー(HVM)を提供します。
  • Microsoft Hyper-V
  • Nutanix AHV
  • RedHat OpenShift Virtualization
  • Proxmox VE


HPE Morpheus VM Essentialsについて


HPE Morpheus VM Essentials ソフトウェア(VM Essentials)は、VMware および HPE 環境全体における仮想化管理を統合・簡素化するために設計された、コスト効率に優れた KVM ベースのハイパーバイザーソリューションです。HPE のハイパーバイザーは HVM と呼ばれ、15 年以上にわたるイノベーションを通じて HPE によって開発・強化されてきました。本ソリューションは、VMware vSphere StandardおよびEnterprise Plusエディションに代わるコスト効率の高い選択肢を求める組織を対象としており、統合されたハイブリッドクラウド運用、コスト削減、および管理の簡素化を重視しています。

HPE Morpheus VM Essentialsは、ローカルおよびネットワーク接続型の両方の外部ストレージをサポートし、効率的なリソース利用のための分散ワークロード配置機能に加え、VMの自動フェイルオーバーを可能にする高可用性を備えています。また、ホストおよびVMストレージのライブマイグレーション、アフィニティおよびアンチアフィニティグループによるワークロードのバランス調整、ワークロードの高速化のためのGPUパススルー、クラッシュ一貫性のあるVMバックアップおよび復元機能を統合して提供します。


ここでは、VMware vSphere StandardおよびEnterprise Plusエディションに対する競争力のある代替ソリューションとして、以下の機能を提供します:


  • コスト削減: HPE Morpheus VM Essentialsは、コア単位ではなくCPUソケット単位でライセンスされるため、VMwareで一般的に採用されているコアベースのライセンス方式と比較して大幅なコスト削減を実現します。HPEおよびサードパーティ製ハードウェアプラットフォームの両方をサポートするスタンドアロンソフトウェアとして利用可能なほか、ワークロードの最適化のためにHPE Private Cloud Business Edition(dHCIまたはHPE SimpliVityプラットフォーム)にも統合されています。本ソリューションは、組み込みOSと統合インストーラーによりインストールプロセスが簡素化されており、導入を簡単かつ効率的に行えます。


  • 統合管理: VM Essentials Managerコンソールは、単一のインターフェースからHVM(KVMベース)およびVMware ESXiクラスタの両方を統合管理し、VMのプロビジョニング(「ベンダー」)、基本的なタスクの自動化、IPアドレス管理(IPAM)、DNSオーケストレーション、およびシークレット管理を簡素化します。


  • エンタープライズグレードの機能: マイクロセグメンテーション機能によりワークロードの分離が強化され、ネットワークトラフィックが保護されることで、セキュリティが向上します。さらに、HPEは、ISV認定の拡大や高度な移行および災害復旧機能の導入を含むロードマップに基づき、プラットフォームを継続的に進化させ、変化する企業のニーズに対応しています。機能には、2ノードのHPE SimpliVityクラスター向けに特別に設計されたLinuxベースのアービターノードを備えた高可用性(HA)が含まれ、小規模な導入環境における回復力と耐障害性を強化します。また、ホストとストレージのライブマイグレーション、ワークロードのバランス調整、VM配置を最適化するためのアフィニティおよびアンチアフィニティグループ、統合データ保護も提供します。


  • マイグレーションツール: VMware vCenterからHVMクラスターへVMを移行するための組み込み機能を備え、LinuxおよびWindowsオペレーティングシステムの両方でバッチ移行をサポートします。最大20台のLinuxおよびWindows VM(RedHat、Ubuntu、SUSE、Windows Server 2022以降を含む)のバッチ移行ワークフローをサポートし、移行前の検証チェックを内蔵することで、適切なドライバー、ネットワークの到達可能性、電源状態、データストアの容量を確認し、移行速度を最適化し、ダウンタイムを最小限に抑えます。


  • エコシステム統合: このソリューションは、HPE ProLiant、Alletra Storage MP B10000、Synergy、MSAをはじめ、Dell PowerEdge、PowerStore、NetApp AFFシステムなど、幅広い検証済みハードウェアプラットフォーム上で動作し、広範な互換性と柔軟な導入オプションを保証します。Veeam、ZertoなどのISVとのエンタープライズグレードのバックアップおよびディザスタリカバリ統合により、堅牢なデータ保護機能を提供します。RedHat、CentOS、SUSE、Microsoft Windows、Canonical Ubuntu、Rocky Linuxなどの主要なゲストOSをサポートし、多様なワークロード要件に対応します。


  • 将来を見据えたアップグレードパス: スタンドアロンソフトウェアとして、またはHPE Private Cloud Business Editionの一部として利用可能です。大規模なエンタープライズ環境やマルチクラウドオーケストレーション(Kubernetesやパブリッククラウドとの統合、ポリシー主導のガバナンス、FinOps機能を含む)に対応するため、HPE Morpheus Enterpriseへのアップグレードオプションが用意されています。

VMWare&HVM clusters management.png


リハイドレーションのオーバーヘッドなしに、ESXiからNutanix AHVへの移行を簡素化

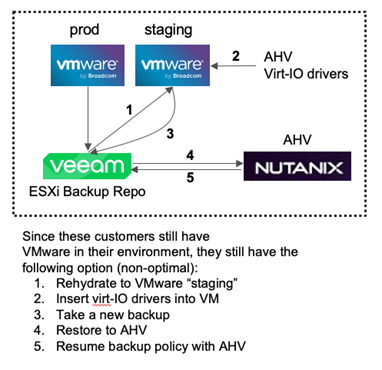
つい最近まで、Nutanix AHV への移行中に VMware ESXi のバックアップを維持するには、万が一古いバックアップを復元する必要が生じた場合に備えて、スタンバイ状態のステージング・ポッド用に VMware ライセンスを維持しておく必要がありました。この余分なハードウェアとライセンスは、バックアップがコンプライアンス義務の対象となる限り、導入・維持し続ける必要がありました。

これは、ほとんど使用されることのないソリューションに対して、多大なコストがかかることになります。


VeeamとNutanixは、Nutanix AHVへの移行を可能な限りスムーズかつコスト効率の高いものにするため、新たな共同ソリューションを発表しました

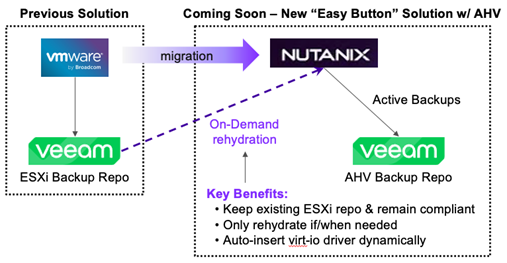
今後、お客様は既存のバックアップを作成時の状態のまま維持する(例:Veeamのアーカイブストレージの一部としてカタログ化されたVMwareバックアップ)という選択肢を得られ、余分なライセンス費用、ハードウェア費用、およびIT関連費用を削減できるようになります。

長期バックアップにアクセスできれば、それで十分です。コンプライアンスを維持するために、「万が一に備えて」という名目のライセンス費用を支払う必要はありません。


主なメリット:

  • すべてのバックアップを事前に変換することなく、コンプライアンス要件を満たします。
  • 自動化された「ワンクリック」の動的復元プロセスを提供します。
  • 「万が一に備えて」という名目のVMwareライセンスを永続的に保有する必要がありません。
  • これにより、本番環境をNutanix AHVへ移行するという主要なタスクに集中できます。


コスト削減の機会がある理由は以下の通りです:

  • AHVは、Nutanix Cloud Platform (NCP) ライセンスの一部として追加費用なしで提供されます。
  • 移行コストが削減されます(環境全体を移行するか、「万が一に備えて」VMwareライセンスを維持し続ける必要がないため)。
  • Veeamユニバーサルライセンス(VUL)を利用すれば、追加コストなしでライセンスを別のワークロードに移行できます。

これはお客様にとって大きなメリットです。VeeamとNutanixは、インフラストラクチャおよび運用コストの削減を目的としたソリューションで協力しています。