投稿者「climb」のアーカイブ

オブジェクトストレージ vs ブロックストレージ vs ファイルストレージ

オブジェクトストレージ、ブロックストレージ、ファイルストレージは、クラウドストレージの3大選択肢であり、それぞれが独自の特性を持ち、その用途を決定づけています。本ガイドでは、オブジェクトストレージ、ブロックストレージ、ファイルストレージを比較し、それぞれの違い、長所と短所、およびユースケースに焦点を当てて解説します。


主なポイント:オブジェクトストレージ、ブロックストレージ、ファイルストレージの比較


・オブジェクトストレージは、画像、動画、PDFなどの非構造化データを、メタデータ(識別情報や属性)が付随した個別の単位である「オブジェクト」として保存します。オブジェクトは、「バケット」と呼ばれるコンテナに整理されます。

・ブロックストレージは、データを「ブロック」と呼ばれる小さな単位に分割し、限られたメタデータと共に保存することで、高速かつ効率的なアクセスを実現します。

・ファイルストレージは、データをファイルシステムに保存します。ファイルシステムは階層構造をとっており、データの共有アクセスを可能にします。


専門家の分析:データストレージアーキテクチャの種類


・一般的なファイルストレージ:Dropbox、Google Drive、iCloudなどの多くの人気クラウドストレージサービスは、SaaS(Software as a Service)として提供されるファイルストレージです。これらはファイルシステムを採用しており、階層構造内のフォルダにデータを保存します。

・ネットワーク接続ストレージ(NAS):ネットワーク接続ストレージ(NAS)は、ハイブリッドクラウドを導入する業界において最も広く利用されているファイルストレージの1つです。市場規模は500%以上成長し、2023年の約220億ドルから2033年には1,380億ドル以上に拡大すると予測されています。1

・データストレージアーキテクチャの選択:ワークロードに適したデータストレージを選択する際は、データ量、アクセス頻度、コスト、パフォーマンス要件、および共有アクセス性に注意を払ってください。


Blobストレージとオブジェクトストレージ


Blobストレージは、オブジェクトストレージの一種です。「Blob」は「binary large object(バイナリ大容量オブジェクト)」の略で、音声ファイル、画像、動画ファイルなど、テキストではない大容量のバイナリデータを指します。

オブジェクトストレージは、Blobを含むデータを元のアップロード形式のままメタデータと共に保存するのに対し、Blobストレージはバイナリ大型オブジェクトを保存するオブジェクトストレージの一種です。つまり、Blobストレージはオブジェクトストレージの一種ですが、すべてのオブジェクトストレージがBlobストレージであるわけではありません。


オブジェクトストレージの活用例


・メディアの保存: 動画や画像などのメディアファイルはファイルサイズが非常に大きくなるため、大量のストレージ容量が必要となります。オブジェクトストレージシステムの料金が比較的安価であるため、Backblaze B2のようなサービスを利用すれば、大規模なメディア保存においても通常、コスト効率に優れています。これは特に中国のクラウドストレージサービスに当てはまり、これらのサービスでは、大規模なメディア保存向けに手厚い無料プランや競争力のある価格設定を提供していることがよくあります。

・バックアップ: クラウドオブジェクトストレージは通常、冗長化されており、異なるゾーンやリージョンにある多数のデバイスに分散して保存されます。そのため、システム障害やデータの永久的な損失リスクに強く、重要なデータのバックアップに最適です。

・ビッグデータ分析: オブジェクトストレージは、大量の非構造化データを元の形式のまま保存できるため、ビッグデータ分析のデータソースとして機能するデータレイクの構築に最適です。


ブロックストレージの活用事例

・仮想マシン: 仮想マシンのファイルシステムとしてフォーマットされた後、オペレーティングシステムやスワップ領域など、仮想マシンを稼働させるために必要なコンピューティングリソースがブロックストレージ上にインストールされます。

・データベース: ブロックストレージは効率的かつ高速なデータ転送に最適化されているため、さまざまな種類のデータベース、特にリレーショナルデータベースなど、高いI/Oパフォーマンスを必要とするデータベースに最適です。

・ハイパフォーマンスコンピューティング: ハイパフォーマンスコンピューティングでは、コンピュータクラスタやスーパーコンピュータを使用して、高度な計算処理のためのデータ処理速度を向上させます。ブロックストレージは、低レイテンシと高スループットを特徴としており、特にランダムなデータアクセスが必要な場合に、この目的に最適です。


ファイルストレージの活用事例


・ハイブリッドアクセス管理: ハイブリッドクラウド環境を構築する際、オンプレミスのファイルシステムを、同じファイルシステムを持つクラウドファイルストレージと容易に統合できます。

・コンテナストレージ: ファイルストレージはコンテナ内で使用され、クラスタ内のコンテナ間で共有データへのアクセスが可能になります。

・データベースのバックアップ: ファイルストレージソリューションのファイルシステムは、データベースに容易に接続し、バックアップ用のコピーを作成できます。


ブロックストレージ、ファイルストレージ、オブジェクトストレージの違いは?

ブロックストレージ、ファイルストレージ、オブジェクトストレージの違いは、ブロックストレージがデータを分割して等サイズのブロック単位で保存するのに対し、ファイルストレージはデータを階層的なファイルシステムで整理・保存し、オブジェクトストレージはデータを元の形式のまま拡張可能なストレージユニットに保存する点にあります。


ブロックストレージとBlobストレージの違いは?

ブロックストレージは、データを等しいサイズのブロックに分割して保存するのに対し、BLOBストレージ(オブジェクトストレージのもう1つの種類)は、画像、動画、音声ファイルなどのデータを、メタデータとともに元の形式のまま、フラットなネームスペースに保存します。


S3オブジェクト・ストレージかブロック・ストレージか?

Amazon S3はオブジェクトストレージサービスであり、データを「バケット」と呼ばれるコンテナ内のオブジェクトとして保存します。
AWSにおける動的ワークロードへの対応策

タグベースの自動化


タグベースの自動化により、組織はAWSリソースに割り当てられたメタデータに基づいて、バックアップ操作を動的に管理できます。「Environment=Prod」や「Backup=true」などのリソースタグを使用することで、AWS BackupやAWS Data Lifecycle Managerなどのバックアップツールは、手動での更新を行うことなく、バックアップポリシーへのリソースの包含や除外を自動的に行うことができます。


これは、インスタンスやボリュームが頻繁に作成および終了されるオートスケーリング環境や一時的な環境において特に有用です。タグベースのルールにより、指定された条件を満たすすべての新規起動リソースが自動的に保護されるため、一貫性が向上し、運用上のオーバーヘッドが削減されます。


増分バックアップ

増分バックアップでは、前回のバックアップ以降に変更されたデータのみをキャプチャするため、バックアップ時間、ストレージ使用量、およびネットワーク帯域幅を削減できます。Amazon EBSスナップショットやAWS BackupなどのAWSサービス、およびVeeamやMSP360などのサードパーティ製ツールは、増分バックアップの仕組みに対応しています。

データが頻繁に変更される動的なワークロードにおいて、増分バックアップは、フルバックアップを繰り返すことなくデータ保護を維持するための効率的かつ費用対効果の高い方法を提供します。また、復元を高速化し、変更頻度の高い環境において極めて重要な、より厳格な復旧時点目標(RPO)をサポートします。


ライフサイクル管理(コールドストレージ)

ライフサイクル管理により、バックアップやスナップショットを、Amazon S3 Glacier や Glacier Deep Archive などの低コストなストレージクラスへ、時間の経過とともに自動的に移行させることができます。AWS Backup や S3 ライフサイクルポリシーなどのサービスは、保存期間やアクセス頻度に基づいた自動的な階層化をサポートしています。

頻繁にバックアップが生成される動的なワークロードの場合、ライフサイクルルールを使用することで、コンプライアンスや監査の目的でバックアップを保持しつつ、古くアクセス頻度の低いバックアップをアーカイブすることで、ストレージコストを抑制できます。このアプローチにより、アクティブなストレージ容量を圧迫したり、不要な費用が発生したりすることなく、長期的な保存が可能になります。


アカウント間/リージョン間のバックアップ

アカウント間およびリージョン間のバックアップ戦略は、バックアップデータをプライマリ環境から分離することで、耐障害性を高めます。AWS Backupは、リージョンやAWSアカウントをまたぐバックアップコピージョブをサポートしており、特定エリアでの障害、セキュリティ侵害、または誤削除からの保護に役立ちます。

この分離は、リソースの入れ替わりが激しく、運用ミスのリスクが高まる動的なワークロードにおいて極めて重要です。バックアップを異なるアカウントやリージョンに保存することで、組織は影響範囲を縮小し、災害復旧体制を強化し、データ主権や規制要件を満たすことができます。


Infrastructure as Code によるバックアップのオーケストレーション

AWS CloudFormation、Terraform、Pulumi などの Infrastructure as Code (IaC) ツールを使用すると、アプリケーションのインフラストラクチャと同様に、バックアップ構成を定義し、バージョン管理を行うことができます。バックアップポリシーやリソースのタグ付けを IaC テンプレートに直接組み込むことで、チームはデプロイプロセスの一環として一貫したバックアップ手順を徹底することができます。

これは、インフラストラクチャが頻繁に起動・停止される動的なワークロードにおいて特に有益です。バックアップポリシーの適用を自動化することで、手動による介入やデプロイ後のスクリプトに依存することなく、新しいリソースがデフォルトで保護されるようになります。また、環境全体での監査可能性と再現性が向上し、コンプライアンスの遵守と運用上の健全性の維持が促進されます。


結論

AWS上の動的なワークロードを保護するには、従来のバックアップ戦略以上のものが必要です。クラウドネイティブインフラストラクチャの一時的な性質、頻繁なデータ変更、および自動スケーリングに対応するには、ポリシー主導型でタグを認識し、インフラストラクチャのプロビジョニングと緊密に統合されたツールと手法が求められます。

AWSのネイティブサービスと高度なサードパーティ製ソリューションを組み合わせることで、組織は環境に合わせて拡張可能な、耐障害性が高く監査可能なバックアップ戦略を維持できます。自動化、リージョン間の分離、およびInfrastructure-as-Codeによるオーケストレーションを導入することで、最も動的なワークロードであっても、データ保護がその変化に確実に対応できるようになります。

Climb Cloud Backup & Security; AWS EC2 バックアップおよび災害復旧

Climb Cloud Backup & Security (Acronis Cyber Protect)は、Amazon EC2インスタンス向けのバックアップ、災害復旧、サイバー保護を統合したソリューションです。自動化されたバックアップスケジュール、迅速な復旧、高度な脅威防御機能を、企業およびマネージドサービスプロバイダー向けに設計された単一のプラットフォームに統合しています。このプラットフォームは、アプリケーション一貫性のあるバックアップ、暗号化、および不変ストレージを利用したランサムウェア対策をサポートしています。

主な機能は以下の通りです:

包括的なEC2バックアップ:AWS EC2上で実行されているデータ、システム状態、およびアプリケーションを保護します

柔軟なスケジュール設定:ワークロードのパターンに合わせてカスタマイズされた手動および自動のバックアップスケジュールをサポート

増分および差分バックアップ:変更されたデータのみをバックアップすることで、ストレージ使用量と帯域幅を削減

AES-256暗号化:コンプライアンスとプライバシー保護のため、転送中および保存中のデータを保護

ランサムウェア対策ストレージ:不変ストレージを使用して、バックアップの不正な削除や暗号化を防止

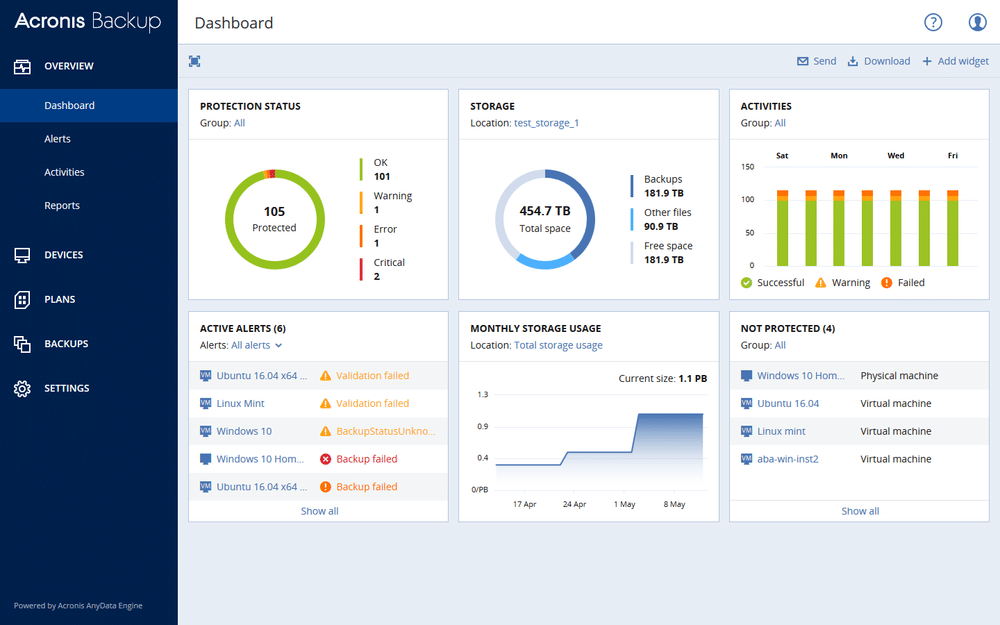
screenshot of Acronis dashboard

Zerto用語集

1. システム構成・コンポーネント

  • ZVM (Zerto Virtual Manager): サイト間のレプリケーションに必要なすべての設定を管理するWindowsサービス(またはLinuxアプライアンス)です。ハイパーバイザー(vCenterやSCVMMなど)と連携してインベントリ情報を取得し、管理コンソールを提供します。
  • VRA (Virtual Replication Appliance): 各ハイパーバイザーホスト上にインストールされる仮想アプライアンスで、実際のデータレプリケーション(書き込みデータの転送)を担当します。
  • ZCC (Zerto Cloud Connector): マネージド・サービス・プロバイダー(MSP)環境において、顧客ネットワークとクラウド側のレプリケーションネットワークを安全に接続・分離するためのコンポーネントです。
  • ZCM (Zerto Cloud Manager): 複数のサイトや顧客(ZORG)を一元管理するための管理サービスです。

2. 保護とレプリケーション

  • VPG (Virtual Protection Group): 一緒に保護・復旧する必要がある複数の仮想マシン(VM)をまとめたグループです。例えば、Web、アプリ、DBサーバーを1つのVPGにまとめることで、書き込み順序の整合性を保ったまま復旧できます。
  • Journal (ジャーナル): 復旧サイト側のVRAによって管理されるファイルで、保護されたVMへのすべての書き込みコピーを保存します。これにより、数秒単位の任意の時点(チェックポイント)への復元が可能になります。
  • Checkpoint (チェックポイント): 数秒ごとにジャーナルへ書き込まれる復旧ポイントです。管理者が手動で説明付きのチェックポイント(例:「パッチ適用前」)を作成することも可能です。
  •  
  • CDP (Continuous Data Protection): スナップショットを使用せず、リアルタイムでデータの変更をキャプチャし続けることで、非常に短いRPO(目標復旧時点)を実現する技術です。


3. リカバリ・同期プロセス

  • Failover (フェイルオーバー): 障害発生時に、保護サイトから復旧サイトへ業務を切り替える操作です。テスト用の「Failover Test」も本番に影響を与えず実行可能です。
  • Bitmap Sync (ビットマップ同期): ネットワーク断などの後に、変更されたブロックのみを特定して同期するプロセスです。同期中も既存のジャーナルからの復旧は可能です。
  • Preseed (プリシード): 復旧サイトにあらかじめデータのコピー(仮想ディスク)を置いておくことで、初期同期時のWAN経由のデータ転送量を大幅に削減する機能です。


4. 主要な指標

  • RPO (Recovery Point Objective): 目標復旧時点。データ損失を許容できる最大時間を指し、Zertoでは通常数秒単位です。
  • RTO (Recovery Time Objective): 目標復旧時間。復旧操作を開始してからサービスが再開されるまでの時間を指します。

動的なワークロード向けのAWSバックアップソリューション「N2WS」

N2WSは、ダイナミックなAWS環境向けに特別に設計された、クラウドネイティブなバックアップおよび災害復旧プラットフォームです。スナップショットのみを扱うツールとは異なり、N2WSはポリシー駆動型の自動化、アカウント間の分離、不変性、および環境全体の復旧オーケストレーションを単一のコンソールに統合しています。安全なAPI呼び出しを使用してAWSアカウント内で直接動作するため、データ、キー、および権限に対する完全な制御を維持できます。

EKSクラスター、マルチアカウントアーキテクチャ、またはコンプライアンス主導のワークロードを管理するITシステム管理者やクラウドエンジニアにとって、N2WSは、ストレージコストを膨らませることなく、バックアップを驚くほど簡単に、復旧を極めて高速に、そしてランサムウェア対策を高セキュリティで実現することに重点を置いています。


主な機能は以下の通りです:


アカウント間およびリージョン間の分離:専用のDRアカウントを作成してバックアップを本番環境から分離し、影響範囲を縮小するとともに、誤削除や悪意のある削除から保護します。


不変のバックアップとコンプライアンスロック:改ざん防止型のバックアップ保持ポリシーを適用し、管理者による変更や削除さえも防止することで、ランサムウェアへの耐性と規制コンプライアンスをサポートします。


環境全体の復旧オーケストレーション:VPC、サブネット、ルーティングテーブル、VPN、ロードバランサー、セキュリティグループを含む環境全体を、正しい起動順序で復元します。


AWS EKS バックアップおよびリカバリ:EKS ネームスペースおよびクラスターに対してポリシー主導型の保護を提供し、ロールバックや移行シナリオに合わせて、同一または別のクラスターへの柔軟な復元を可能にします。


統合されたマルチアカウントおよびマルチクラウド管理:ツールやワークフローを切り替えることなく、単一のコンソールからAWS、Azure、Wasabiのバックアップを管理します。


きめ細かなスケジューリングとタグベースの自動化:秒単位のスケジューリング精度と、タグを使用したリソースの動的な包含をサポートします(オートスケーリングや一時的なワークロードに最適です)。


1つのポリシー、複数の保持期間:単一のポリシー内で週次および月次の保持スケジュールを設定でき、バックアップの肥大化を防ぎ、ストレージ使用率を最適化します。


コスト最適化機能:スナップショットのアーカイブ、ライフサイクル自動化、即時クリーンアップ、リソーススケジューリングを備え、ストレージの過剰プロビジョニングを防止します。


自動化されたDR(災害復旧)演習:本番ワークロードに影響を与えることなく、非破壊的な復旧シナリオを実行し、災害への備えを検証します。


きめ細かなファイル単位の復元:環境全体の復旧を必要とせずに、個々のファイル、フォルダ、ボリューム、またはインスタンス全体を復元します。


お客様のAWSアカウント内で実行:お客様自身のAWS環境内で安全なAPI呼び出しを通じて動作し、データの完全な管理と主権を確保します。

動的なワークロードがデプロイされる主なAWSサービスとは何か?

Amazon Elastic Kubernetes Service(EKS)における動的ワークロードは、通常、需要に応じて自動的にデプロイ、スケーリング、および終了されるコンテナ化されたマイクロサービスで構成されています。EKSにおけるバックアップ戦略では、永続データ(例:ポッドにアタッチされたボリューム)とクラスターの状態(例:デプロイメント、サービス、コンフィグマップ)の両方を考慮する必要があります。VeleroやEBSと統合されたAWS Backupなどのツールは永続ボリュームのデータを取得できますが、クラスター構成の復元には、GitOpsの実践やHelm、TerraformなどのIaCツールがよく使用されます。バックアップソリューションは、動的に変化するネームスペース、ボリューム、ノードグループを識別し、追跡できる必要があります。


AWS Lambda

AWS Lambda関数は本質的に一時的かつステートレスですが、S3、DynamoDB、SQSなどの動的なデータソースに関連付けられたイベントを処理したり、トリガーしたりすることがよくあります。Lambdaベースのワークロードに対するバックアップ戦略は、関連するデータや構成アーティファクト(関数コード、環境変数、IAMロール、イベントソースのマッピング)の保護に重点を置きます。AWS CloudFormation または AWS Serverless Application Model (SAM) を使用して、インフラストラクチャをコードとしてキャプチャできます。誤削除やデプロイエラーが発生した場合に迅速な復旧を確実にするためには、関数定義の定期的なエクスポートとバージョン管理が不可欠です。


オートスケーリンググループ(ASG)を使用したAmazon EC2

オートスケーリンググループ(ASG)は、定義されたポリシーに基づいてEC2インスタンスを起動および終了させるため、アクティブなリソースのセットは非常に動的になります。ASGインスタンスは頻繁に置き換えられるため、バックアップは、基盤となる起動テンプレート、構成ファイル、およびEBSボリューのような永続ストレージに重点を置きます。AWS BackupおよびDLMを使用すると、タグベースのポリシーを使用してEBSボリュームのスナップショットを自動化できます。バックアップ戦略では、起動構成で使用されるゴールデンAMIに加え、共有ボリュームや外部データベースに保存されていないインスタンス固有のデータも確実に取得する必要があります。


サーバーレス AWS ワークロード

サーバーレスアーキテクチャでは、Lambda、API Gateway、Step Functions、DynamoDB、S3 などの複数のマネージドサービスが、疎結合なアプリケーションとして組み合わされることがよくあります。これらのワークロードをバックアップするには、マルチサービスアプローチが必要です。各コンポーネントの状態と構成に加え、DynamoDBテーブルやS3バケットなどのデータ永続化レイヤーもキャプチャする必要があります。DynamoDB PITRやS3レプリケーションが一般的に使用されます。IaCやアプリケーションテンプレート(例:AWS CloudFormation StackSets)をサポートするツールはアーキテクチャ定義の保持に役立ち、AWS Backupのような集中管理型サービスは、対応している場合、データ保護を処理できます。

AWSにおけるダイナミック・ワークロードとは何か、またどのような特別な課題があるか?

ダイナミック・ワークロードとは、需要の変化に応じてリソースを自動的に増減させるクラウドベースのアプリケーションやサービスのことです。この弾力性はクラウドネイティブアーキテクチャの中核となる機能であり、多くの場合、オートスケーリンググループ、サーバーレス関数、あるいはKubernetesのようなコンテナオーケストレーションプラットフォームによって実現されます。


これらのワークロードは、通常、疎結合かつ分散型です。単一のモノリシックなアプリケーションとして構築されるのではなく、APIを介して通信する、より小規模で独立したコンポーネント(多くの場合マイクロサービス)で構成されています。これにより、耐障害性とスケーラビリティが向上する一方で、バックアップや復元操作の際の状態や依存関係の追跡が複雑になります。


動的なワークロードは頻繁に変化します。リソースは、CI/CDパイプラインやインフラストラクチャ・アズ・コード(IaC)のデプロイの一環として、自動的に作成、変更、または終了される場合があります。この急速な変動により、バックアップ戦略は手動設定に依存するのではなく、自動化され、ポリシー主導でなければなりません。バックアップポリシーは、新しいリソースが出現した際に動的に検出し、保護する必要があります。


動的ワークロードのバックアップにおける主要な課題の一つは、「スナップショット」の取得が困難であることです。インフラストラクチャやデータの状態が時間経過とともに一貫して維持される静的システムとは異なり、動的環境には、その状態が分単位で変化する一時的なコンポーネントが存在します。そのため、より頻繁なバックアップ、より短いRPO(復旧時点目標)、そして固定されたアーキテクチャを前提とせずに分散サービス全体にわたるデータをキャプチャできるツールが必要となります。

HPE Zerto V10.8.11のリリース

新機能

HPE Morpheus Enterprise および HPE Morpheus VM Essentials Manager 向け HPE Zerto ソフトウェア

HPE Zerto は HPE Morpheus Enterprise および HPE Morpheus VM Essentials Manager と統合され、HVM 環境における継続的なレプリケーションとディザスタリカバリを実現します。現在、レプリケーションは HVM 間環境でのみサポートされています。HVM 環境では、以下の主要機能がサポートされています:

  • Failover Live(障害発生時に仮想マシンをリカバリサイトへリアルタイムでフェイルオーバー)
  • Reverse Protect(フェイルオーバー後、元の本番サイトへのレプリケーションを再確立)
  • Failover Test(本番ワークロードに影響を与えることなくリカバリを検証)
  • ランサムウェア検出(悪意のある暗号化を検出し、特定の時点へのリカバリを可能にする)


保護対象のVMが電源オフ時のRe-IP

  • 保護対象のVMが電源オフの状態では、HPE ZertoはQEMUゲストエージェントがインストールされているかどうかを判断できません。

復旧操作中、HPE ZertoはQEMUゲストエージェントの存在を確認できない場合でも、Re-IPの実行を試みます。エージェントがインストールされていない場合、Re-IP操作は失敗します。

回避策:

Re-IPをサポートするための前提条件として、すべての保護対象VMにQEMUゲストエージェントがインストールされている必要があります。

すべてのVMにQEMUゲストエージェントがインストールされていることを確認してください。

VPGの作成および編集ワークフロー中、保護対象VMの電源が入っており、QEMUゲストエージェントが検出されている場合にのみ、IP設定の構成が可能となります。


SELinuxポリシーによるRe-IPの失敗

特定のLinuxディストリビューション(CentOSやRocky Linuxなど)では、SELinuxポリシーが厳格化されているため、QEMUゲストエージェントコマンド「guest-exec」の実行が阻止され、Re-IP操作が失敗します。

回避策:

SELinuxポリシーの適用状況はLinuxディストリビューションによって異なり、Re-IPをサポートするためにVMの追加設定が必要になる場合があります。

  • 特定のLinuxディストリビューション(CentOSやRocky Linuxなど)でRe-IPを有効にするには、SELinuxの適用レベルを下げる必要があります。
  • この回避策では、QEMUゲストエージェントを事前に定義されたRPCコマンドセットに制限し、アクセス拒否を防ぐためにSELinuxの適用を無効にします。

Re-IPを許可するためにSELinuxの強制レベルを下げる手順あり。


フェイルオーバー実行中のリカバリホスト/データストアの変更

ユーザーは、リバースプロテクトの「VPGの編集」画面において、フェイルオーバー実行中にのみホスト/データストアの設定を変更できます。

フェイルオーバーのコミット後は、リカバリ ホスト/データ ストアの変更をサポートしていないため、設定済みのホスト/データ ストアを変更することはできません。


Zerto で保護されている VM でのストレージ ライブ マイグレーションの実行

HPE Zerto で保護されている VM に対してストレージ ライブ マイグレーションを実行するには、VM の電源をオフにし、マイグレーションを実行してから、電源をオンにする必要があります。

Climb Cloud Backup & SecurityがGoogle Workspaceに提供するデータ保護機能について

Climb Cloud Backup & SecurityはGoogle Workspaceの標準機能(Google Vaultなど)では補いきれない「意図しない削除」「ランサムウェア被害」「迅速な時点復元」に特化した、強力なクラウド・ツー・クラウド(C2C)バックアップソリューションを提供しています。


1. 主なバックアップ対象

Google Workspace内の主要なデータを網羅的に保護します。

  • Gmail: メール本文、添付ファイル、ラベル、スレッド全体。

  • Google ドライブ: マイドライブ内のファイル・フォルダに加え、共有ドライブ(旧チームドライブ)も対象。

  • 連絡先とカレンダー: 連絡先グループや予定、添付ファイルなど。


2. 注目すべき5つの保護機能

① エージェントレスの直接バックアップ

GoogleのデータセンターからAcronisのクラウドストレージへ直接データを転送します。自社サーバーの設置や、各PCへのソフトインストールは不要で、デバイスの動作が重くなることもありません。

② 高度な検索と粒度の細かい復元

  • 全文検索: バックアップ内のメールやファイルをキーワードで検索し、必要なものだけを数秒で特定できます。

  • アイテム単位の復元: フォルダ丸ごとではなく、特定のメール1通、ファイル1件単位での復元が可能です。

③ ランサムウェア・セキュリティ対策

  • 改ざん防止(不変ストレージ): バックアップデータそのものが攻撃者によって暗号化されたり削除されたりするのを防ぎます。

  • ブロックチェーン認証: Acronis Notary技術により、バックアップデータがバックアップ時から改ざんされていないことを証明できます。

④ 自動化と効率化

  • 新規ユーザーの自動保護: 新しく追加されたユーザーや共有ドライブを自動で検出し、バックアップ設定を適用します。

  • 重複排除: 同じデータが複数の場所に存在しても、保存容量を最小限に抑える仕組みがあり、コスト効率を高めます。

⑤ コンプライアンスとガバナンス

Google標準の「保持ポリシー」では対応が難しい「特定時点へのロールバック(Point-in-time recovery)」が可能です。これにより、誤操作や悪意のある削除から確実にデータを守ります。

3. Google Workspace標準機能(Google Vault等)との違い

機能 Google Workspace (標準/Vault) Climb Cloud Backup & Security
主な目的 電子情報開示・コンプライアンス保持 災害復旧・事業継続 (BCP)
復元操作 複雑(エクスポート後の再インポート等) 簡単(数クリックで元の場所に復元)
時点復元 困難(削除されたものは保持されるが復旧が大変) 容易(特定の日時の状態に即座に戻せる)
一元管理 Google管理画面のみ サーバーや他クラウドと統合管理可能

【最新機能】GenAI Protection (生成AI保護)

2026年2月にリリースされた「 GenAI Protection」は、組織内での生成AI(ChatGPT、Claude、Geminiなど)の利用を安全に管理・制御するためのセキュリティ機能です。

多くの企業が「AIを使いたいが、機密情報の流出が怖い」という課題を抱える中、この機能は「利便性を損なわずにリスクを抑える」ことを目的としています。主な機能は以下の3点です。


1. 「シャドーAI」の可視化

従業員がIT部門の許可なく利用しているAIツール(シャドーAI)を自動で検出します。

  • 利用状況の把握: 誰が、いつ、どのAIアプリケーションやWebサイトを利用しているかをダッシュボードで一覧化します。

  • トレンド分析: 組織内でどのようなAI導入パターンがあるかを可視化し、リスク評価に役立てます。


2. プロンプトによる機密情報漏えいの防止 (DLP連携)

AIとのチャット(プロンプト)の内容をリアルタイムで検査し、重要なデータが外部に送信されるのを防ぎます。

  • 機密データの検知: 個人情報(PII)、クレジットカード情報、設計図、ソースコード、医療情報(PHI)などのパターンを識別。

  • 送信ブロック: AIモデルの学習データとして取り込まれるリスクがある機密情報が含まれていた場合、プロンプトの送信そのものを遮断します。


3. 悪意あるプロンプト攻撃の防御

AIを悪用しようとする試みからシステムを保護します。

  • プロンプトインジェクション対策: AIのガードレールを回避しようとする特殊な入力(脱獄/Jailbreak試行)を検知し、不適切な利用を阻止します。

  • ブラウザ・デスクトップ両対応: Webブラウザ上での利用だけでなく、デスクトップアプリ型のAIツールに対しても監視が可能です。


なぜこの機能が必要なのか?

従来のWebフィルタリングでは「AIサイトへのアクセス許可/拒否」という極端な設定しかできませんでした。 しかし、GenAI Protectionを導入することで、「AIの利用は許可するが、社外秘データの入力だけを禁止する」という柔軟な運用が可能になります。

[重要] この機能は Acronis Cyber Protect Cloud のエージェントに統合されているため、新たなソフトをインストールすることなく、既存の保護設定(管理計画)の一部として簡単に有効化できるのが大きなメリットです。

Database Performance Analyzer (DPA)の開発状況 (updated March 2026)

DPAの最新リリース状況

  • データベース検出機能により、ネットワーク上のデータベースを検索できるため、データベース環境を簡単に特定して登録し、可観測性の実現までの時間を短縮できます。
  • DPA Centralの機能が拡張され、環境全体のビューが表示されるようになりました。カスタムプロパティでフィルタリングしたり、カスタムプロパティを列として表示したりできます。その他の改善点として、ページネーション、グループ化ビュー、SAMLのサポートが追加されています。
  • 「AI Query Assist」機能で SolarWinds AI を活用し、SQL Server および Oracle ターゲットのクエリパフォーマンスを最適化するためのクエリ書き換えの提案を提供します。
  • 多数の Azure SQL DB メトリクスが追加され、tempDB の使用状況を含め、データベースの動作のさまざまな側面とクエリパフォーマンスを関連付けることが可能になりました。
  • PostgreSQLおよびMySQLデータベースワークロード向けのテーブルチューニングおよびインデックスアドバイザー。
  • DPAのPlatform Connectを通じて、ServiceNowおよびPagerDutyとのアラート通知連携が簡素化されました。
  • IPv6専用またはハイブリッド環境向けのIPv6サポート。
  • 認証サポートの強化(MySQL向けのgMSAおよびSHA2パスワード)。

現在取り組んでいること

以下は、DPAに関して現在取り組んでいる、または検討中の事項の一覧です:


  • データベース検出機能について、検出結果をDPAの各インストール間で共有し、異なるDPAインストールに登録されている検出結果を無視するようにします。また、検出対象をクラウドアカウントにも拡張します。
  • DPAをDockerコンテナで提供し、ポータブルかつ効率的なデプロイ環境を実現します。
  • DPAの統合の柔軟性を高めるため、汎用的なWebhookを統合用に導入します。
  • SAP Hanaを監視対象としてサポートします。これにはオンプレミスおよびHana Cloudのデプロイメントが含まれ、シングルコンテナおよびマルチコンテナアーキテクチャに対応します。
  • Oracle Autonomous Databaseを監視対象としてサポートします。
  • DB2の最新バージョン向けに、セッションブロッキング情報を提供します。
  • 既存のインデックス、テーブルサイズ、カラムのカーディナリティなどの追加プロンプト入力により、AIクエリアシストの出力品質を継続的に向上させます。また、将来のリリースでは他のDBMSタイプにも対応を拡大します。
  • ホームページにアラームアイコンが表示されないよう、チューニングアドバイザーをミュートする機能を追加します。これは、監視対象への変更を行う能力が限られている場合に役立ちます。これらのアドバイザーをミュートすることで、対処不可能な問題に気を取られることがなくなります。
  • チューニングの意思決定を支援するため、SQL ServerのtempDBのアクティビティおよび構成情報の可視化を拡充します。DPAは、懸念されるtempDBの動作や状態について通知するアラートを提供します。
  • ユーザー権限管理用のエンドポイントを含むDPAのAPI。
  • SolarWinds製品(SquadCastおよびService Desk)へのアラート通知(Platform Connect経由)。
  • 複数のDPAサーバー間で一貫性を維持できるようにする、大規模なDPA環境向けの管理機能。
  • DPAのセキュリティが、米国連邦政府および共通基準相互承認協定(CCRA)参加国での利用に必要な厳格な保護プロファイルを満たすことを保証するための、共通基準(Common Criteria)認証。


(注) 上記の機能の記載順は優先度を示すものではありません。また上記のリストは、現在開発中または検討中の項目を示していますが、これらの機能がいつ、あるいは実際に提供されるかを保証するものではありません。


Database Performance Analyzer (DPA) 2026.1 のGA

DPA 2026.1 リリース

Database Performance Analyzer (DPA) 2026.1が一般提供(GA:general availability)を開始したことをお知らせいたします。本リリースでは、アラートメールの認証にOAuth 2.0に対応したほか、ネットワーク上のデータベースを特定し、監視対象として検討できるようにする新しい検出機能を導入しています。

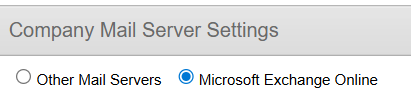
Microsoft Exchange Online 向け OAuth 2.0

セキュリティ強化のため、Microsoft は Exchange Online における基本 SMTP 認証を段階的に廃止し、OAuth 2.0 への移行を進めており、2026年3月からこの変更が適用されます。この変更は、アラートメールの配信に Exchange Online を使用するように DPA が設定されている環境に影響します。

サービスの中断を防ぐため、DPA 2026.1 にアップグレードし、Microsoft Exchange Online との通信に OAuth 2.0 を使用するように SMTP 設定を更新してください。

image.png

新機能:データベース検出 !

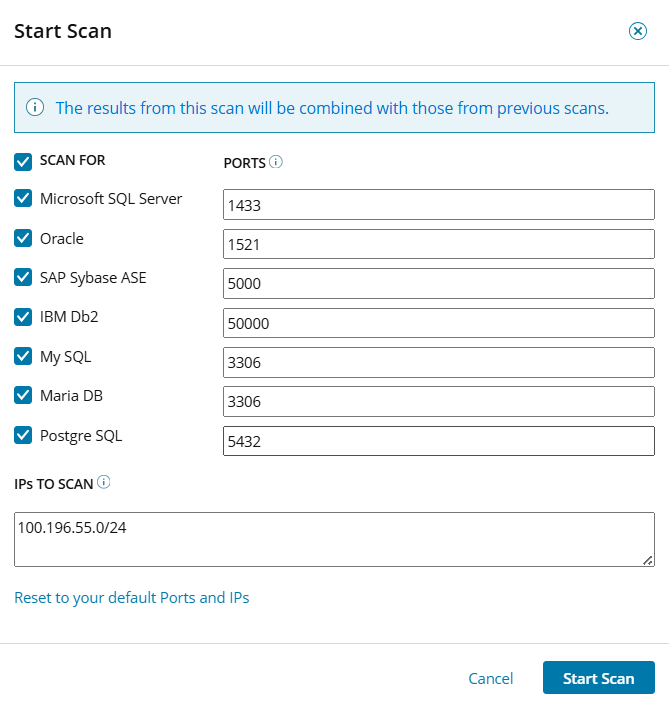
DPA 2026.1 では、ネットワーク上のデータベースインスタンスを特定し、監視のためのオンボーディングプロセスを効率化する新しいデータベース検出機能が導入されました。

この機能により、DPAはユーザーが指定したIPアドレスとポートをスキャンし、DPAにまだ登録されていないデータベースインスタンスを検出します。検出結果は登録ワークフローに直接反映され、IPアドレスとポート情報が自動的に入力されるため、導入から価値創出までの時間を短縮し、データベース環境全体の可視化を加速します。

今後の検出機能の強化点には以下が含まれます:

  • クラウドアカウントベースのデータベース検出
  • 複数のDPAデプロイメント間での検出結果の共有
  • インテリジェンスと自動化の拡張

image.png


Climb Cloud Backup & Securityのセキュリティ機能ではどのようなことができますか?

Climb Cloud Backup & Securityは、「次世代アンチウイルス」「エンドポイント管理」「バックアップ」の3つを1つのエージェントに統合しているのが最大の特徴です。

具体的にできることを、セキュリティのライフサイクルに沿って整理して解説します。


1. 攻撃を未然に防ぐ(プロアクティブ)

攻撃を受ける前に、システムの弱点を補強する機能です。

  • 脆弱性診断: OSや各種アプリケーション(Microsoft, Adobe, Javaなど)の脆弱性をスキャンし、リスクを可視化します。
  • パッチ管理: 脆弱性が見つかった際、管理コンソールから一括で修正パッチを適用できます。
  • URLフィルタリング: 悪意のあるサイトやフィッシングサイトへのアクセスをブロックします。


2. 攻撃をリアルタイムで検知・遮断(アクティブ)

侵入しようとする脅威を最新のAI技術で食い止めます。

  • AIベースの次世代アンチマルウェア: 従来の「パターンマッチング」だけでなく、AI(機械学習)や振る舞い検知を用いて、未知のランサムウェアやウイルスを検知します。
  • 自己保護機能: Acronis自身のプロセスやバックアップデータが書き換えられないよう保護する、強固な防御層を持っています。
  • エクスプロイト防止: ソフトウェアの不具合を突いた攻撃(メモリインジェクションなど)を阻止します。


3. 被害から迅速に復旧する(リアクティブ)

万が一感染してしまった場合、他社製品にはない強力なリカバリ機能を発揮します。

  • 自動ロールバック: ランサムウェアによってファイルが暗号化され始めたことを検知すると、即座にプロセスを停止し、暗号化される直前の状態へ自動的にファイルを復元します。
  • セーフリカバリ: バックアップデータ内にマルウェアが潜んでいないかスキャンしてから復元を行うことで、再感染(バックドアの復活など)を防ぎます。
  • ディザスタリカバリ (DR): システム全体がダウンした場合でも、クラウド上で仮想マシンとして即座に起動させ、業務を継続できます。


導入するメリットのまとめ

通常のセキュリティソフト(ウイルス対策のみ)と比べると、以下のような違いがあります。

機能 一般的なウイルス対策ソフト Acronis Cyber Protect
未知の脅威 パターン更新まで防げない場合がある AI/振る舞い検知で未知の攻撃も遮断
感染後の対応 OSの再インストールが必要なことも 1クリックでバックアップから復旧
管理の負担 バックアップソフトと別々に管理 1つの画面で一元管理が可能


導入ヒント:「守る(防御)」と「戻す(復元)」がセットになっているため、万が一防御を突破されても「データが消える」「業務が止まる」という最悪の事態を避けられるのが最大の強みです。


Database Performance Analyzer (DPA) 2025.2のGA

このリリースでは、DPAは「AI Query Assist」という機能を通じてAIの力を提供します。この機能はSQLを書き換え、パフォーマンスを向上させることで、問題のあるクエリの解決にかかる平均時間を短縮します。詳細および今回のDPAリリースに含まれるその他の機能については、以下をご覧ください。

AI Query Assist (Tech Preview)

最適なパフォーマンスを発揮しつつ、望ましい結果を生み出すクエリを作成することは、特に複雑なSQLの場合やスキーマが十分に理解されていない場合には、困難な作業となり得ます。さらに、パフォーマンスの低いクエリを書き直すには、DBAや開発者が数多くの試行錯誤を繰り返す必要があり、多大な時間を要する場合があります。

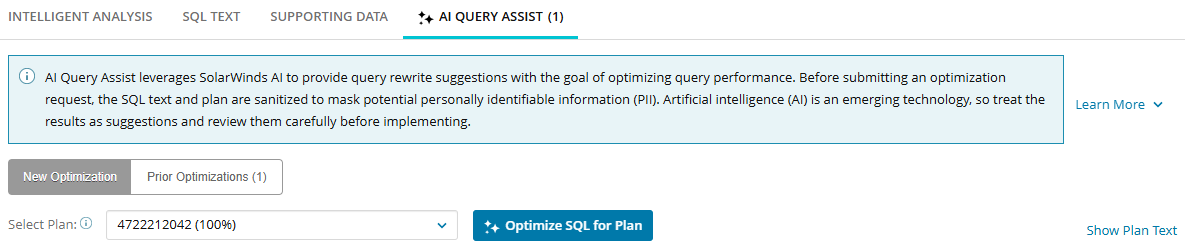
AI Query Assistは、SQLのパフォーマンス向上を目的にトレーニングされたSolarWinds AIを活用し、機能的な同等性を維持しつつ、より高いパフォーマンスを発揮するクエリへと巧みに書き換えます。SolarWinds AIは管理された環境内で動作し、機密性の高い個人識別情報(PII)が完全にマスキングされ、安全に保たれることを保証します。AI Query Assistは現時点ではSQL Serverのクエリ最適化をサポートしていますが、今後のリリースではより幅広いDBMSへの対応が予定されています。

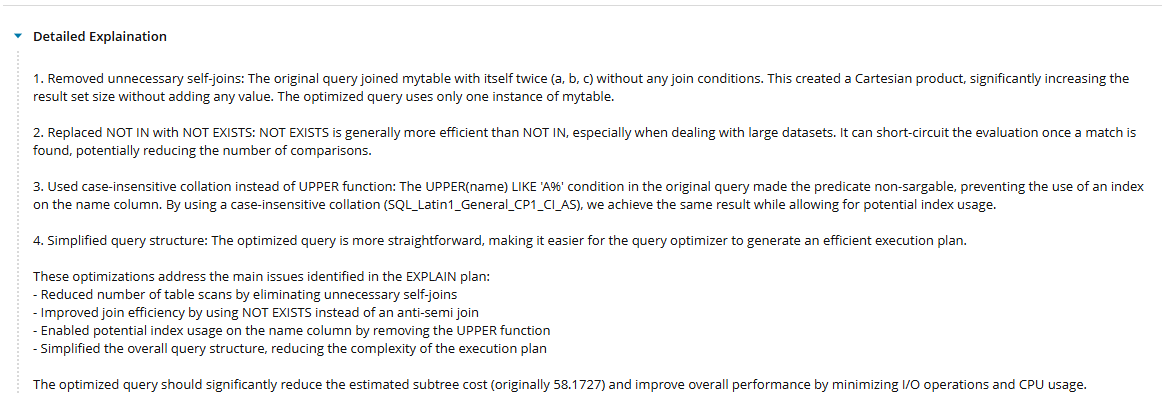
SolarWinds AIは、SQLテキストと実行計画(Explain Plan)を入力としてクエリを書き換え(最適化)ます。これにより、DBMSがクエリをどのように実行することを選択したかについての洞察を得ることができます。DDLには実行計画がないため、DDLステートメントは最適化できない点に注意してください。最適化の結果には以下が含まれます:

  • 概要:クエリがどのように最適化されたかについての概要説明
  • 思考:AIが最適化において何を考慮したかの説明
  • 説明:クエリがどのように最適化されたかについてのより詳細な説明
  • 最適化されたSQL:DPAは元のSQLテキストと最適化されたSQLテキストを並べて比較表示します

AIは新興技術であり、時間とともに改善されている点に注意してください。したがって、最適化結果を採用する前に、分析とテストを行う必要があります。

AIクエリアシストの使用

この機能を使用するための前提条件は次のとおりです:

  • Platform Connect: AIクエリアシストを有効にする最初のステップは、DPAの[オプション]ページにあるPlatform Connectリンクに従って、DPAのPlatform Connectコンポーネントを設定することです。AIクエリアシスト機能がオンになっていることを確認してください。
  • ライセンス:この機能を利用するには、監視対象のSQL ServerインスタンスにDBSHまたはDBSHDSライセンスが割り当てられている必要があります。
  • ユーザー権限:DPA管理者、または監視対象インスタンスに対する「監視の管理」権限を持つユーザーは、最適化リクエストを送信できます。読み取り専用ユーザー、または監視対象インスタンスに対する「表示」権限を持つユーザーは、最適化結果を確認できますが、新しい最適化リクエストを送信することはできません。

最適化の取得:

  1. 問題のあるクエリの [クエリ詳細] ページに移動します。このページへのアクセス方法は複数ありますが、最も一般的な方法は、[トレンド] ページのグラフから SQL ハッシュをクリックすることです。
  2. [AI Query Assist] タブをクリックします
  3. ドロップダウンからプランを選択します
  4. [プランの SQL を最適化] ボタンをクリックします。これにより、SolarWinds AI に最適化リクエストが送信されます。処理完了まで数秒から数分かかる場合がありますが、これは主にクエリの複雑さに依存します。
  5. [最適化を表示] をクリックして、最適化結果を確認します。

新しい最適化のリクエスト

AIクエリアシストに関するフィードバック

AIクエリアシストによるクエリの最適化について、皆様のご感想をお聞かせください!AIが優れた提案を行ったかどうかに関わらず、その内容をお知らせいただければ、最適化機能の改善に役立てたり、最適化されたクエリの成果を皆様と共に喜んだりすることができます。フィードバックは、「いいね」または「イマイチ」のアイコンをクリックし、結果に関するコメントを入力して送信してください。

PostgreSQL の実行プランとチューニングのアドバイス

PostgreSQL のパラメータ化クエリ(つまり、バインド変数を使用するクエリ)については、PostgreSQL は自動的に実行プランを生成しないため、DPA がクエリのパフォーマンスに関する詳細な洞察を提供することが困難でした。

このリリースでは、DPA が PostgreSQL にパラメータ化クエリの実行プランを生成するよう明示的に要求するようになりました。実行プランの詳細を確認できるという利点に加え、「テーブルチューニング」や「インデックスアドバイス」など、プランを活用する機能の利便性がさらに向上します。

IPv6

DPAはIPv6を完全にサポートするようになり、IPv6またはハイブリッドネットワーク環境でもDPAを利用できるようになりました。IPv6アドレスを指定する際は、次のように角括弧で囲むのが最適な場合があります:

  • ポート番号を指定する URL では角括弧を使用してください:
    • https://[::1]:8080
    • https://[fd42:8204:8306:c108:250:56ef:fe98:9466]:3000
  • ネットワーク設定やpingコマンドなどでは角括弧を使用しないでください:
    • ping6 fd42:8204:8306:c108:250:56ef:fe98:9466

Database Performance Analyzer (DPA) 2025.3のGA

Teamsの新しいWebhookのサポート

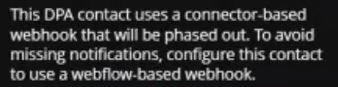
Teamsの連携機能について、Microsoftは従来のコネクタベースのWebhook URLのサポートを終了し、WebflowベースのWebhook URLに移行します。Microsoftは、新しいコネクタベースのWebhookに対して暫定的なサポートを提供していますが、これは2025年末をもって終了する予定です。

DPAは現在、暫定的なコネクタベースのWebhookと新しいWebFlowベースのWebhookの両方をサポートしており、連絡先に対して暫定または従来のWebhookを設定している場合、製品内でメッセージを表示します。また、DPAのREST APIも更新され、連絡先に従来のWebhookを割り当てようとするとエラーが返されるようになりました。

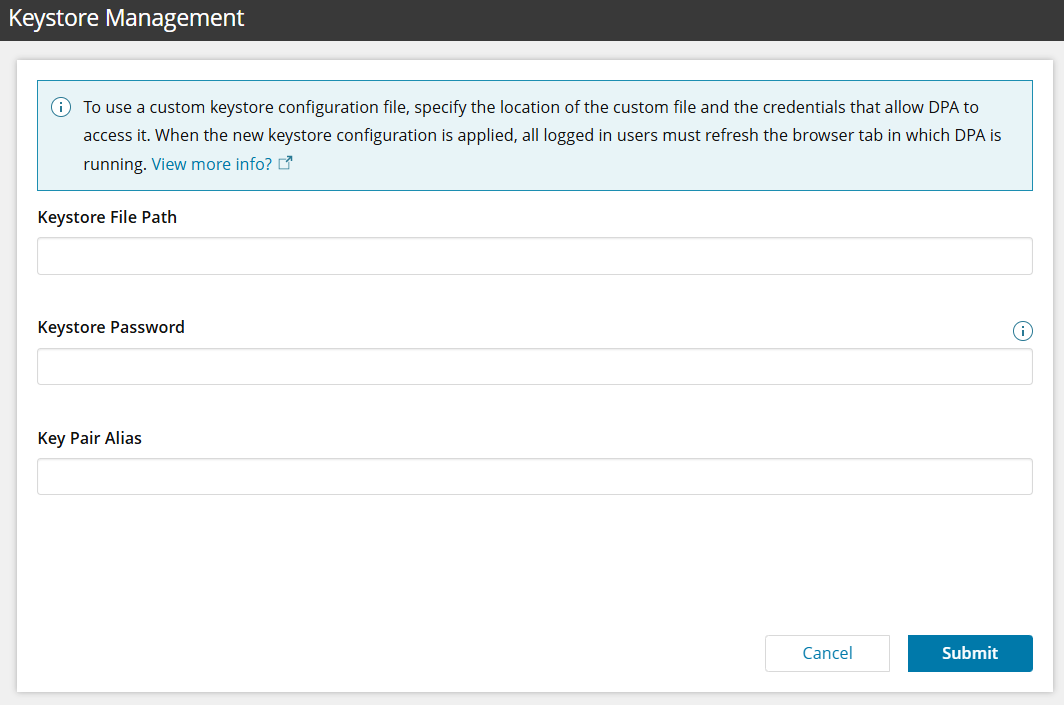
キーストアの管理

DPAには、カスタムで暗号化されたSSL証明書を使用してDPAに接続できるようにする「キーストアの管理」ページが追加されました。管理者は「オプション」ページにある「キーストアの管理」リンクを使用して、証明書とキーストアのパスワードが格納されたカスタムキーストアの保存場所を指定できます。

迫りくる脅威:DBAの大量離職

DBA(データベース管理者)のバーンアウト(燃え尽き)は、単なる人材確保の課題にとどまらず、ビジネス上のリスクでもあります。「State of Database Report」調査によると、DBAの38%が職を辞することを検討したことがあるとのことです。


1人の離職がもたらす影響:

  • 財務的損失:DBA1人を補充するのに6~9ヶ月分の給与が必要
  • 知識の喪失:組織のノウハウが失われる
  • 運用リスク:ダウンタイムの増加、システムの不安定化、およびインシデントの深刻化


バーンアウトの原因とは?その「消火活動」の過負荷

なぜDBAは退職を考えているのでしょうか?それは、彼らの1日が純粋に事後対応的な業務に費やされているからです。報告書によると、彼らは週に27時間(時間の68%近く)という驚くべき時間を、以下の業務に費やしています:

  • アラートやチケットへの対応
  • バックアップと復旧
  • パフォーマンス問題の修正

「消火活動」に費やされる1時間は、最適化、自動化、あるいはイノベーションに費やされるはずだった1時間です。この不均衡が仕事の満足度を蝕み、バーンアウトを加速させています。


監視における重大な認識のギャップ


この業務負荷の問題は、経営陣とDBAの間にある根本的な認識のズレによってさらに悪化しています。経営陣は、監視体制が包括的かつ統合されていると想定しがちです。一方、DBAはそれが
危険なほどサイロ化されていることを知っています:

  • 経営陣の認識:IT経営幹部の50%近くが、自社の環境は統合されていると考えている
  • DBAの現実:これに同意するDBAはわずか40%

この認識のギャップは、重大な死角を生み出し、アラート疲労を助長し、インシデントの見落としを招くことで、リスクの高い非効率性を招いています。この乖離は、すでに手一杯のチームに直接的なプレッシャーを加えています。


事態を悪化させる認識のズレ

経営陣とDBAの認識が一致していないと、非効率性とリスクが倍増します。認識のズレは、単にフラストレーションを引き起こすだけでなく、対応時間の遅延、ダウンタイムの増加、そしてイノベーションの阻害につながります。その影響はビジネス全体に波及し、人事部門だけに留まりません:

  • 離職コストの増加:DBAの大量離職という悪循環を招く
  • 対応時間の遅延:事業継続性に直接的な影響を与える
  • イノベーション能力の低下:デジタルトランスフォーメーションの取り組みを阻害する

DBAの燃え尽きがもたらす経済的コストを削減し、経営層とDBAの間の溝を埋める方法はDPA(Databese Performance Analyser)の導入です。


毎週金曜日に実施できる30分の軽量な復元テスト

ほとんどの「バックアップテスト」は大きすぎるために失敗します。
こちらが軽量な週ごとのルーティンで、実際に何かを学べるものです。


ステップ 1️ – ターゲットを1つ選ぶ
• 1つのエンドポイントまたは1つのクリティカルフォルダー
• クライアント/エンドポイントを週ごとにローテーションする


ステップ 2️– 2回の復元を実行する
• ファイルレベル:1つのファイルを別の場所に復元する
・システムレベル:小さな画像スナップショットや重要なアプリ設定(該当する場合)を復元する


ステップ 3️– 検証
• 可能であればチェックサム/ハッシュ
・許可/所有権確認
• App Openテスト(設定/データベースダンプ用)


ステップ 4️– 3桁だけ記録する
・時間を回復する
• 位置(どこ)を復元する
・壊れたもの(もしあれば)


4〜6週間後にはパターンが見えます:
✔️ 帯域幅のボトルネック
✔️ 保持ギャップ
✔️ 許可の驚き
✔️ きれいに復旧しない「グリーンジョブ」

これが本当のバックアップ成熟度、つまり回復の再現可能な証明です。

成熟したバックアップが必要ですか?

ぜひご覧ください。https://www.climb.co.jp/soft/#cloud

どのような種類の不変性手法があるか?

MSPや中小企業が、全体的なバックアップ戦略の一環として不変性(イミュタブル)機能を活用するには、3つの方法があります。

1. ストレージレベルの不変性

これは現在、特にクラウドストレージにおいて最も一般的なアプローチです。オブジェクトストレージサービスでは、データを一度書き込んだ後、一定期間ロックすることができます。その期間中、ストレージに保存されたデータを削除したり上書きしたりすることはできません。保存期間が終了すると、ここに保存されたデータは他のファイルと同様に扱われます。

2. ソフトウェアによる不変性の確保

一部のバックアッププラットフォームでは、過去のバックアップセットが変更されないようにする保持ロック機能を提供しています。このアプローチにより、例えば個々のファイルが削除されたり、破損したりした場合でも、バックアップチェーンは保護されます。バックアップ・ベンダーは、保持設定と整合性チェックを組み合わせており、ファイルがバックアップセットから削除された場合でも、選択されたデータセットを完成させ、復元可能性を確保するために、そのファイルが再度バックアップされるようにします。

3. エアギャップまたはオフラインコピー

これは厳密には「不変性」ではありませんが、ネットワークから切り離されたコピーは、第三者が保存データにアクセスできないため変更不可能です。ただし、物理メディアは時間の経過とともに劣化したり、適切に保管されないと読み取れなくなったりする可能性がある点に留意してください。テープや交換可能なメディアのアーカイブがある場合は、定期的にローテーションを行う必要があります。これは日々のバックアップには効率的ではありませんが、物理的な分離を優先する業界では依然として信頼されている方法です。

なぜ不変性が今、これまで以上に重要なのか

つい最近まで、ランサムウェアの標的は主に本番システムに限られていました。しかし現在では、攻撃者は意図的にバックアップファイルも狙っています。本攻撃を開始する前に、これらのバックアップを密かに暗号化または削除できれば、被害者は安全策を失うことになります。そのため、多くの中小企業が直面するリスクを軽減するため、現在では多くのサービスプロバイダがバックアップ戦略の一環として不変性(イミュタビリティ)を取り入れています。

ランサムウェア: 最近のランサムウェアは、サーバーを暗号化するだけでなく、マップされたドライブ、NASボリューム、アクセス可能なクラウドバケットも検索します。不変性のあるストレージに保存されたデータは、マルウェアがアクセスしたとしても改ざんされることはありません。

偶発的または意図的な削除: 人為的ミスは依然としてデータ損失の主な原因です。ロックされたバックアップは、従業員によるディレクトリの上書きや、攻撃者が盗んだ認証情報を使ってデータを消去する行為からデータを保護します。

サイバー保険、コンプライアンス、および監査要件: サイバー保険契約や、医療、金融サービス、法務、政府などの業界における規制では、特定のデータが改ざんされていないという証拠が求められることがよくあります。不変性(イミュタビリティ)は、その保証を提供します。

サービスプロバイダにとっても、不変性とは究極的にはリスクの低減と復旧時間の短縮を意味します。中小企業にとっては、最悪のシナリオであっても、データやシステムが復元できる可能性が極めて高いということを確信できることを意味します。

イミュータブル(不変)バックアップとは何ですか?

不変バックアップとは、一定期間、変更、削除、上書きが不可能なデータのコピーのことです。一度作成されると、そのバックアップは保存期間が満了するまで、作成時の状態のまま維持されます。

実際には、不変性は通常、以下の3つのいずれかによって実現されます。ほとんどの企業にとって、これには新しいハードウェアや大規模なインフラの変更は必要ありません。不変性レイヤーは、多くの場合、すでに使用されているクラウドストレージやバックアップソフトウェアに組み込まれています。重要なのは、管理者であれ、ランサムウェアであれ、有効な認証情報を持つ攻撃者であれ、誰も保護されたコピーを変更できないことをシステムが保証できるかどうかです。この「ロックされたコピー」こそが、不変性の真価を発揮する要素です。

●書き込み一回・読み取り多回(WORM)ポリシーを適用するストレージシステム

●ロックされた保存期間をサポートするオブジェクトストレージサービス(S3 Object Lockなど)

●バックアップジョブの過去のバージョンの変更を防止するバックアッププラットフォーム

Climb Cloud Backupに「Restore Wizard」を導入

復元設定を行う際、設定項目をいちいち探したり、以前の設定内容を思い出したりする必要はありません。

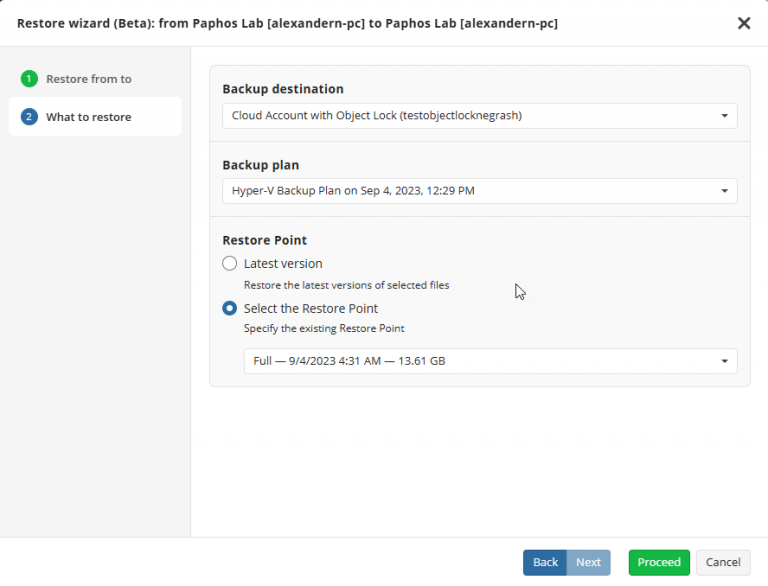
Climb Cloud Backupの最新アップデートでは、手順を段階的に案内する「復元ウィザード」を導入しました。その目的はシンプルです。特に時間と明確さが求められる状況において、復元設定をより簡単かつ確実に行えるようにすることです。

概要

復元ウィザードは、バックアッププランの選択から復元ポイントや保存先の指定に至るまで、復元設定の主要な手順を順を追って案内します。

これは、復元の内部的な仕組みを変えるものではありませんが、設定プロセスをより明確にし、分かりやすくします。

Climb Cloud Backup の「復元ウィザード」とは

大まかに言えば、復元ウィザードは、Climb Cloud Backup での復元設定をガイド形式で行う機能です。

以前は、復元の設定は事前に構成された復元プランに依存しており、それらのプランの構造を十分に理解している必要がありました。このアプローチは機能していましたが、特にデータを別のマシンに復元するといったあまり一般的ではないシナリオでは、混乱を招く可能性がありました。

このウィザードは、すべての重要な決定事項を単一のフローにまとめることでこのプロセスを簡素化し、個々の要素を組み合わせて考える必要なく、ステップバイステップで復元を設定できるようにします。

「復元ウィザード」の実用的な活用例

汎用的な復元ウィザードの価値を理解する最良の方法は、実際にどのような復元シナリオに対応しているかを確認することです。

1. ソースコンピュータへの復元

特定のファイルやフォルダを復元する必要がある場合、このウィザードを使用すれば、復元計画の構成について考える必要なく、手順に従って段階的に作業を進めることができます。

2. ローカルコンピュータへの復元

元のマシンが利用できない場合でも、インターフェースの異なる部分間を切り替えることなく、同じガイド付きフローを通じて別のローカルマシンへの復元を設定できます。

現在の制限事項

現時点では、ウィザードによる復元は、Windows OS を実行している元のコンピュータまたはローカルコンピュータでのみ利用可能です。

他のマシンへの復元機能については、今後のアップデートで対応する予定です。

「汎用復元ウィザード」に関する総括

復元ウィザードは、小規模ながらも実用的な変更点です。新しい復元機能を追加するものではありませんが、既存の機能をより使いやすくしています。

Wasabi Cloud Strageの技術ブログはありますか?

Wasabiの「Veeam v10 Cloud Connect With Wasabi」の紹介サイト

https://docs.wasabi.com/docs/how-do-i-use-veeam-v10-cloud-connect-with-wasabi

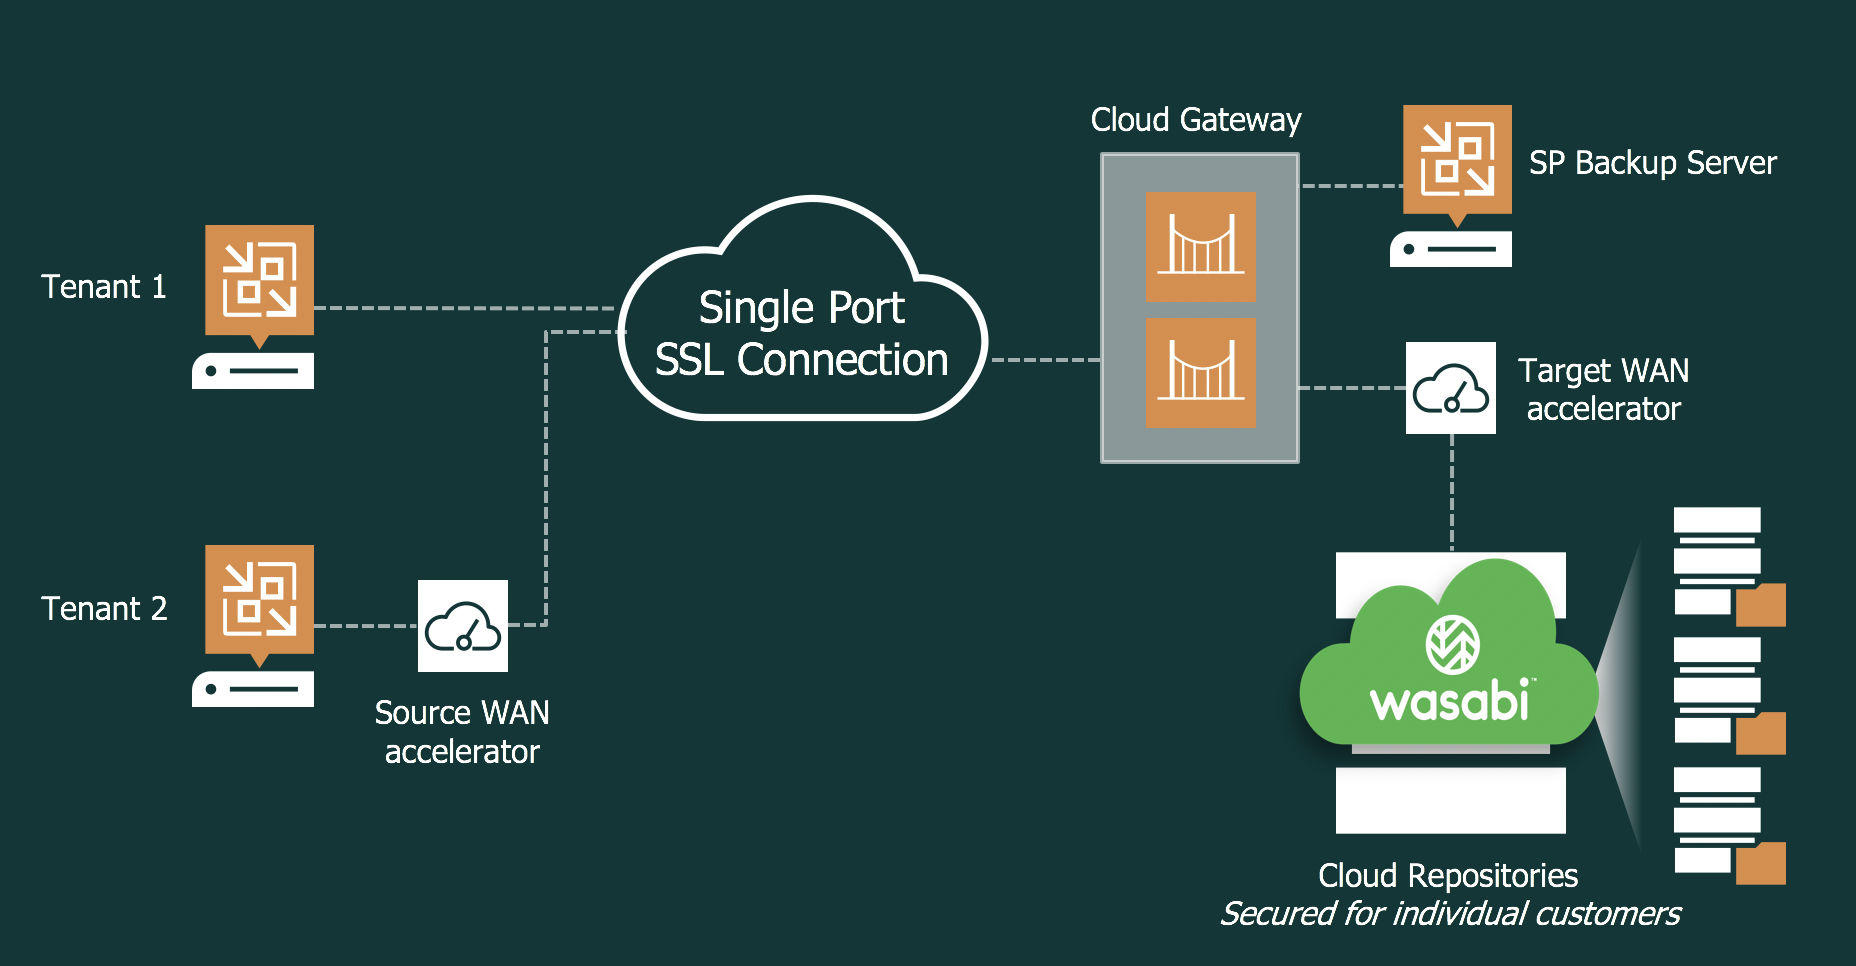
Veeam Backup & Replication v10 の 「Cloud Connect」 機能を利用して、バックアップデータを Wasabi クラウドストレージに保存するための設定ガイドです。

主な内容は以下の通りです。

1. 概要と対象者

  • 対象: Veeam クラウド・サービス・プロバイダー(VCSP)およびその顧客(テナント)。
  • 目的: サービスプロバイダーが Wasabi をバックエンドストレージとして使い、顧客にクラウドレポジトリや災害復旧サービスを提供するための構成説明。
  • 注意点: Wasabi 自体は Cloud Connect プロバイダーではありません。あくまでプロバイダーが Wasabi をストレージとして利用する構成を指します。

2. 事前準備

  • Veeam Backup & Replication v10 以降。
  • 「Cloud Connect Provider」が有効な Veeam プロバイダーライセンス。
  • Wasabi アカウント。
  • (不変性バックアップが必要な場合)Wasabi の Object Lock 機能の有効化。

3. 設定の主なステップ

記事では、以下の順序で設定手順が詳述されています。

  1. クラウドゲートウェイの構成: 証明書の発行と、通信の入り口となるゲートウェイサーバーの設定。
  2. ゲートウェイプールの作成: ゲートウェイをグループ化し、管理しやすくする設定。
  3. テナント(顧客)の作成: 顧客ごとのユーザー名、パスワード、バックアップ容量(クォータ)を割り当てます。この際、バックアップ先として Wasabi を含む「Scale-out Backup Repository (SOBR)」を指定します。
  4. 顧客側 Veeam の設定: 顧客側の Veeam 管理画面で、プロバイダーの DNS/IP アドレスと提供された認証情報を入力し、接続を確立します。
  5. バックアップジョブの作成: 顧客が自身の仮想マシンなどをバックアップする際、保存先としてプロバイダーのクラウドレポジトリを選択します。

4. データの流れ

  1. 顧客のデータがプロバイダーのローカルストレージに一度バックアップされる。
  2. Veeam の「Copy」機能(またはオフロード機能)により、プロバイダーから Wasabi のバケットへデータが転送される。
  3. Wasabi のコンソール上でデータが正しく書き込まれていることを確認する。

まとめ

このドキュメントは、「Veeam v10 を使っているるユーザがデータを Wasabi に効率よく、かつ安全に保管するための連携手順書」です。

ScalityとWasabiが提供する、高可用性かつリーズナブルな価格のデータストレージとセキュリティ

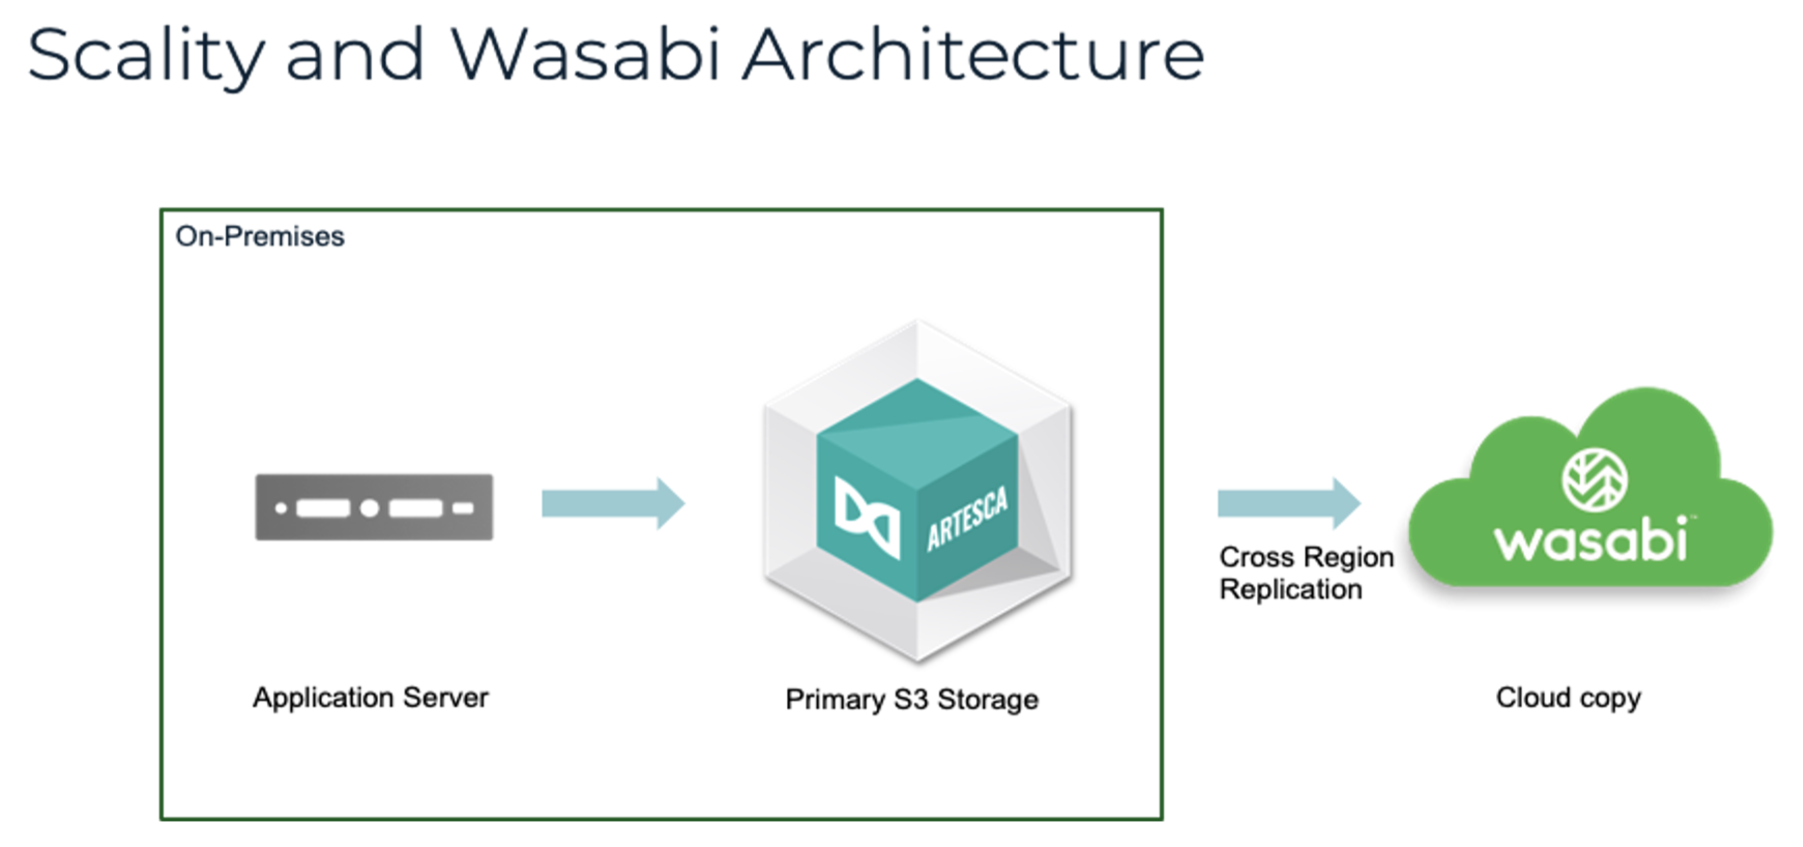
Wasabiは、手頃な価格で高速かつ信頼性の高いオンデマンド型クラウドストレージを提供する、今注目のクラウドストレージ企業です。ScalityのARTESCAとWasabiを統合したソリューションは、最高のセキュリティ、俊敏性、選択肢、そしてコスト削減を実現する、統一されたハイブリッドクラウドストレージリポジトリを提供します。

ScalityとWasabiの組み合わせは、Veeamによるバックアップと併せて、比類のないサイバーセキュリティと統合管理を実現する、スケーラブルで柔軟なソリューションです。当社の「pay-as-you-grow(成長に合わせて支払う)」モデルでは、お客様は容量分のみを支払うため、予測不能なコストを心配する必要がありません。これは、最も重要なワークロードをオンプレミスで運用する中小企業にとって理想的なソリューションです。

ユーザ保護に向けたパートナーシップ

現実として、犯罪者はお客様のデータを狙っており、そのアクセスを阻止するのはお客様の責務です。しかし、Scality、Veeam、Wasabiが味方につけば、お客様は独力で対応する必要はありません。Wasabi、Veeam、Scalityはいずれもデータの不変性を確保するソリューションを提供しており、これはフィッシングやランサムウェアに対する最善の防御策となります。

Veeam、ARTESCA、Wasabiを活用することで、ユーザは3-2-1-1-0バックアップポリシーを実装できます: これらと協力することで、ユーザの独自のニーズに最適な、最も安全なストレージソリューションを提供しています。

●データの3つのコピー:プライマリストレージ + ARTESCA + Wasabi

●2つの異なるバックアップリポジトリ:ARTESCA + Wasabi

●1つの外部バックアップ:Wasabi

●少なくとも1つの不変バックアップ:このケースでは、ARTESCAとWasabiの両方が不変です。したがって、Veeamはエンドツーエンドの不変性を確保した状態でバックアップを保存できます。

●復旧失敗ゼロ:Veeamはバックアップが確実に復旧可能であることを検証する「Sure Backup」を実装しています。ARTESCAリポジトリはそのパフォーマンスにより、これを実現しています。

Bare Metal (Server)エディションについて

Bare Metal エディション(旧Serverエディション)は2026年2月末でEOSとなりました。