投稿者「climb」のアーカイブ

Oracle Linux KVM 向けのVMware VSAN代替技術について

Oracle Linux KVM環境において、VMware vSAN(ハイパーコンバージドインフラ/HCIストレージ)に完全に相当する単一の「Oracleブランド製品」はありませんが、同等の機能を実現するサードパーティ製ソリューションは存在します。

Oracle Linux KVM (通常は Oracle Linux Virtualization Manager – OLVM で管理) でHCI構成を組む場合の主な選択肢は以下の通りです。


1. GlusterFS (Red Hat Gluster Storage)

Oracle Linux KVM (OLVM) は、Red Hatの oVirt プロジェクトをベースにしています。oVirt環境において、vSANのように「コンピュートノードのローカルディスクを束ねて共有ストレージにする」ための標準的な技術が GlusterFS です。

  • 特徴: 複数のサーバーのディスクを一つの大きなファイルシステムとして扱います。
  • メリット: OLVM (oVirt) との親和性が高く、ハイパーコンバージド構成(HCI)が組みやすいです。
  • vSANとの違い: vSANはカーネルレベルで動作しますが、GlusterFSはファイルシステムベースです。

2. サードパーティ製 商用SDS (vSANの代替として有力)

オープンソースの構築・運用負荷を避けたい場合、Oracle Linux KVM上で動作する商用ストレージソフトウェアを使用します。これらはサポートがあり、vSANに近い使い勝手を提供します。

  • StarWind Virtual SAN (VSAN):
    • VMware vSANからの移行先として人気があり、KVM (Linux) 版も提供されています。
    • 2ノード構成から安価に始められるのが特徴です。

比較表: VMware vSAN vs Oracle KVM向け代替案

機能/特徴VMware vSANGlusterFS (OLVM)StarWind VSAN
統合レベルハイパーバイザー(ESXi)に完全統合OLVMと統合可能ソフトウェアとしてインストール
難易度低 (vCenterから設定)高 (設定が必要)低~中
コスト高 (ライセンス費用)低 (OSSベース)中 (商用ライセンス)
サポートBroadcom (VMware)Red Hatベンダー (StarWind/クライム)
アーキテクチャカーネルモジュールファイルシステムiSCSIターゲット / ソフトウェア

推奨されるアプローチ

  1. 「Oracle純正」に近い構成を望む場合:
    • OLVM + 外部ストレージ (iSCSI/NFS/FC) の構成が最も標準的でトラブルが少ないです。OracleはHCI(内蔵ディスク共有)よりも、信頼性の高い専用ストレージ(SAN/NAS)の使用を推奨する傾向があります。
  2. コスト削減でHCIを実現したい場合:
    • GlusterFSまたはStarWind VSAN を検討してください。

ご提案できる次のステップ

現在検討されているシステムの規模(ノード数)や、重視されるポイント(コスト、パフォーマンス、運用の楽さ)を教えていただければ、例えば、StarWindで十分かなどをアドバイスができます。
AWS 障害発生時にユーザが対応すべきこと

  • ●ライフサイクルポリシーでコスト削減:古いバックアップをAmazon S3 Glacierなどの低コストストレージに移行するライフサイクルポリシーを設定します。これによりストレージコストを大幅に削減できます。
  • ●異なるリージョンやアカウントへのバックアップ:バックアップを異なるAWSリージョンやアカウントに複製することで、災害復旧計画を強化します。これにより、リージョン固有の問題やセキュリティ上の課題からデータを保護できます。
  • ●RTO短縮のためのバックアップ自動化:AWS Backupを使用して頻繁なバックアップ間隔を設定します。1時間ごと、あるいは数分おきの自動バックアップにより、データを迅速に復旧でき、ダウンタイムを最小限に抑えられます。
  • ●リソースにタグを付けて管理を容易に:タグにより関連するバックアップを迅速に識別・グループ化でき、管理やコスト監視が容易になります。これによりレポート作成やコンプライアンスチェックも簡素化されます。
  • ●災害復旧計画を定期的にテスト:DRドリルを自動化し、バックアップと復旧プロセスを確認します。バックアップが機能し、データを迅速に復元できることを確認することで、潜在的な問題を発見・修正できます。

StarWind VTL:自社データセンターのイミュータブル(不可変性)とランサムウェア対策の強化へ

ランサムウェアの絶え間ない脅威に直面するIT管理者なら、基本を超える堅牢なバックアップ戦略の重要性を理解しているはずです。ここではStarWind Virtual Tape Library(VTL)に焦点を当てます。このソリューションはバックアップを不変かつランサムウェア対策を施しつつ、すべてを自社データセンター内で管理下に置くことを実現するものです。長年仮想化とバックアップツールを扱ってきた経験から、StarWind VTLはこの分野における技術的優位性が際立っています。詳細を考察します。

StarWind仮想テープリポジトリが技術的優位性を確立する理由は?

StarWind VTLはソフトウェアで物理テープライブラリをエミュレートしますが、大容量回転ディスクやフラッシュストレージといった現代的なストレージ技術を活用し、オプションでクラウド連携も可能です。これにより、既存のテープ中心のバックアップインフラを全て撤去することなく、シームレスに統合できます。鍵となるのはオンプレミス展開です。自社データセンターのハードウェアに直接インストールするため、データのローカライゼーションを完全に制御できます。クラウドへの依存は必須ではありません——データは管理者の管理下で、希望する場所に留まります

技術的には、VTLはバックアップを仮想テープイメージに書き込むストレージゲートウェイとして機能します。これらのイメージは、直接接続ストレージ(DAS)にローカル保存するか、AWS S3、Azure、Wasabiなどのクラウドプロバイダーに階層化して追加の保護層を構築できます。しかし真価はデータ保持にあります:フルバージョンでは、カスタム保持ポリシー、レプリケーション、階層化を設定し、重要なバックアップをオンサイトに保持することで、超高速復旧を実現します。これにより、危機発生時にクラウドからダウンロードするダウンタイムを回避できます。

不変性とランサムウェア対策:中核となる強み

ランサムウェアはバックアップを標的にするのが大好きです。それが身代金を支払わせる手段だからです。StarWind VTLは書き込み不可・読み取り可能(WORM)ストレージでこれに対抗し、設計上バックアップを不変にします。データが仮想テープに書き込まれると、マルウェアがネットワークに侵入しても変更や削除は不可能です。この不変性レイヤーが組み込まれているため、ランサムウェアが改ざんする余地は皆無です。

さらにエアギャップを実現:VTLはデータをオフサイトストレージ(クラウドまたは別のオンプレミスサイト)に複製することで、隔離されたリカバリポイントを作成します。しかし純粋なクラウドソリューションとは異なり、データセンター内の制御権はユーザーが保持します。

例:

  • ●ローカルキャッシュと階層化:直近のバックアップは高速なオンプレミスフラッシュに保存し、古いものは不変のクラウドアーカイブへ階層化。
  • ●ランサムウェア対策設計:仮想テープは本質的に安全であり、有料版ではプロアクティブな監視により不審な動作をアラート通知。
  • ●3-2-1ルール準拠:監視を損なうことなく、複数コピー(ローカルディスク、仮想テープ、クラウド)を容易に実現。


この不変性とオンプレミス制御の組み合わせは、データ主権が絶対条件となるVMwareやHyper-V環境において、VTLをゲームチェンジャーにします。

オンプレミス制御がこれまで以上に重要である理由

データローカリゼーションについて考えてみましょう。GDPRなどの規制や単純なビジネスニーズから、完全な可視性なく他社のクラウドにバックアップが浮遊している状況は望ましくありません。StarWind VTLは自社サーバーへの展開を可能にし、自社ストレージ(容量用回転ディスク、高速用フラッシュ)を活用します。暗号化、アクセス、ポリシーを制御可能です。ベンダーロックインなし。自社データセンター、自社ルールです。


製品版では、エンタープライズ向けハードウェア搭載のプリビルドVTLアプライアンス、管理用Web UI、AI搭載テレメトリによる「コールホーム」監視機能を提供。これにより問題を未然に防止し、障害発生後の対応ではなく先手を打つことが可能になります。技術に精通した管理者にとって、このレベルの制御は復元時間の短縮と、ランサムウェア被害時のRTO/RPO低減につながります。


まとめ

StarWind VTLは単なるバックアップツールではありません。データの不変性、ランサムウェアへの耐性、オンプレミスでの管理を重視し、データを真に「自分たちのもの」として守るための技術的な防護策です。攻撃の手口が進化し続ける現代において、これを導入することは、迅速な復旧と多大な損失を伴うダウンタイムの差を分けることになり得ます。

StarWind VTLをお試しになった方や、VMware/ESXiとの統合についてご質問がある方は、ぜひご連絡ください。

Microsoftの Storage Spaces Direct (S2D)について

消去符号化や革新的なキャッシュ技術に加え、Microsoft Storage Spaces Directは、NASやSANといった従来の物理共有ストレージオプションの数分の1のコストで、比類のない効率性とパフォーマンスを約束します。その他の機能には、オフライン重複排除、自動階層化、ハイパーバイザーレベルでのVM中心のスナップショット、USBフラッシュドライブを監視用デバイスとして使用する2サーバークラスタリングなどが含まれます。

Microsoft S2Dは確かに多様なストレージを強力なシステムに統合する可能性を秘めていますが、SAN価格の数分の1という主張には疑問が残ります。Storage Spaces Directは最上位のWindows Serverライセンスとして提供されます。S2Dを購入すると、実際には使用しない機能を含むWindows Serverの全機能を購入することになります。また、習得と運用が非常に複雑です。したがって、コスト効率性は実際にはS2Dの最大の弱点です。

Microsoftの Storage Spaces Direct (S2D) vs. StarWind VSAN 比較こちら

Kubernetes(Amazon EKS)向け次世代自動バックアップ&リカバリ

AWS EKSの自動バックアップと復旧の新たなサポート

N2WSは、Kubernetes(Amazon EKS)アプリケーションとデータ向けの自動化された使いやすいバックアップと復旧機能を提供します。本アップデートにより、EKSクラスター全体および個々のネームスペースに対して、ワンクリックでポリシー駆動型の保護を実現します。N2Wは、EKSネームスペースとそのRDSデータベースなど、環境全体をシームレスにバックアップし即時復元するため、災害時の即時ロールバック、クラスター間リカバリ、クラスター間のワークロード移行が可能になります。

Amazon S3向け効率化されたバックアップと復旧

N2WSはAmazon S3バケット向けの効率化されたバックアップと復旧サービスを提供開始しました。S3オブジェクトデータストレージは、柔軟なバックアップ頻度設定と即時復元により保護されます。本ソリューションにはリージョン間およびアカウント間の災害復旧機能が含まれており、企業はAWSインフラ全体でデータの耐障害性を維持できます。

コンプライアンスロックの不変性をAWSおよびAzureからWasabiへ

N2WSは、コンプライアンスロックの不変性により、AWSおよびAzureからの隔離されたオフサイトバックアップ保護をWasabiへ拡張することで、多層的なランサムウェア保護を提供します。Wasabiリポジトリに書き込まれたバックアップコピーは、ルートユーザーであっても変更または削除できず、データの改ざんやサイバー脅威から保護すると同時に、組織が規制およびコンプライアンス要件を満たすことを支援します。

N2WSの最新アップデートにおけるその他の新機能は以下の通りです:

Azureリソース制御: N2Wは、N2Wコンソールから直接Azure VMの自動起動・停止・休止機能を提供し、AWS向けに既に提供されているインテリジェントな自動化機能を拡張します。ITチームはAzureとAWSの操作を個別にフィルタリングして表示でき、マルチクラウドのコスト最適化に対する明確な可視性と制御を獲得し、最終的に無駄なクラウド支出を大幅に削減できます。

・ ●Azure環境向けクロスサブスクリプションDR:N2Wは、既存のクロスリージョンDR機能に、VMとディスクのクロスサブスクリプションサポートを追加し、Azure災害復旧機能を拡張しました。この強化により、ワンクリック復元機能や不変ロックと組み合わせることで、組織は包括的で多層的なランサムウェア対策アプローチを実装できます。

・●単一ポリシーでの複数保存スケジュール設定:多様なデータ保存要件を持つ組織のバックアップ管理を簡素化するため、単一ポリシー内で複数の保存スケジュールを設定する機能を導入。例えば、週次バックアップと月次バックアップを統一ポリシー下で別々の期間保存可能となり、管理オーバーヘッドを削減しつつ細かな制御を実現。

・ ●マルチクラウドリポジトリからのAzureポリシー復旧向け新リカバリシナリオ:DR計画が機能しないことに気づく最悪のタイミングは、実際のダウンタイム時です。N2Wのリカバリシナリオでは、あらゆるリポジトリ(Wasabi、Amazon S3、Azureオブジェクトストレージ)からAzureポリシーの復旧をテストするDR訓練を実行可能にします。DRテストのスケジュール設定やオンデマンド実行、重要リソースの優先順位付け、監査対応レポートの提供を実現します。

NIS2 コンプライアンス導入ヒント

  • 侵害シミュレーションプラットフォームの活用:侵害および攻撃シミュレーション(BAS)ツールを用いた模擬攻撃を実行し、検知およびインシデント対応ワークフローがNIS2のタイムラインに沿った適切なアラート、通知、エスカレーション経路をトリガーすることを検証する。
  • 特権アカウント向け階層型アクセスログの導入:標準的なログ記録を超え、特権アカウント向けにコンテキスト認識型ログ記録(例:アクセス場所、時間異常、行動逸脱)を実装する。これにより不正利用を早期に発見し、フォレンジック対応の準備を支援する。
  • 脅威シナリオと事業影響のマッピング:一般的なリスク評価ではなく、現実的な脅威シナリオ(例:OT環境でのランサムウェア、クラウドプロバイダー侵害)と事業影響(ダウンタイム、法的リスク)を関連付けたマトリクスを作成し、統制策や継続性対策の正当性を立証する。
  • 国境を越えたインシデント対応計画の策定:組織が複数のEU加盟国で事業を展開している場合、国境を越えた報告義務、データローカリゼーション規則、規制当局への連絡先を事前に定めた対応プロトコルを構築する。
  • 資産・リスクインベントリにおける自動化されたサプライヤー分類の適用:動的タグ付けを活用し、リスクエクスポージャー、契約条件、データアクセス権限に基づいてサプライヤーと関連システムを自動分類。これによりレビューと対応の優先順位付けを効率化する。

 Kubernetesバックアップに関するヒント

バックアップインフラを本番クラスターから分離: バックアップコントローラーとストレージ統合を、プライマリクラスターへの依存を最小限に抑えた独立した管理クラスターまたは分離されたネームスペースでホストします。

動的PVC検出とラベリングによるアプリケーション認識型バックアップ: バックアップジョブへの自動包含を実現します。作成時にボリュームにアプリケーション識別子をタグ付けすることで、粒度を向上させ、マルチテナント環境やネームスペースが密集した環境におけるボリュームの取りこぼしリスクを低減します。

ランサムウェア耐性のための不変・時間ロック型バックアップの実装: S3 Object Lockの組み込みサポートにより、N2WSはバックアップにWORM(Write Once Read Many)ポリシーを適用可能。これにより有効期限前の変更や削除を防止します。

シミュレート復元テストによるフェイルオーバー検証の自動化:インフラストラクチャ・アズ・コードのテンプレートとCI/CD自動化を活用し、バックアップから定期的に分離された「カナリアクラスター」を起動。復元が完全に行われ、ワークロードが期待通りに機能することを検証します。

ワークロードの重要度とライフサイクルに基づく保持ロジックの適用:ワークロードを重要度別に分類し、バックアップ頻度・有効期限・ストレージ階層を適切に調整。規制対応バックアップと一時的な開発ワークロードでは、異なるローテーションポリシーが必要となる場合があります。

Veeam KastenはKubernetes専用のデータ保護ソリューションで、各種Kubernetesディストリビューション上のステートレス/ステートフルなアプリケーションの構成と永続ボリューム上のデータ、OpenShift VirtualizationやSUSE Virtualization(Harvester)の仮想マシンに対してバックアップとリストア、モビリティを提供します。

AWS Backupのコスト削減に関するヒント

コミット前のモデルアーカイブスナップショット拡張: EBSスナップショットをアーカイブ階層に移動する際は、事前にフルスナップショットのサイズを見積もる。変更頻度の高いワークロードは、増分ウォームスナップショットよりも多くのスペースを消費し、期待される節約効果を損なう可能性がある。

復元無料階層を戦略的に活用:一部のサービス(EBSウォーム復元など)は無料ですが、他は有料です。復元無料の中間サービスへ復元する復旧ワークフローを設計し、可能であれば内部でデータを移行してください。

二重課金削減のための復元テストのタイミング調整:ライフサイクル移行直後や保持期間満了直前に復元テストをスケジュールしてください。これにより、いずれ削除されるテストデータに対して、ウォームストレージと復元リソースの実行時間の両方を支払うことを最小限に抑えられます。

コンプライアンス用バックアップと運用用バックアップの分離:コンプライアンスに基づく長期保存用と運用復旧用で、別々のバックアップ計画と保管庫を使用する。これにより、短期間の運用用バックアップが高コストな長期保存ルールを継承するのを防ぐ。

スコープ付きIAMロールで復元影響範囲を制限:過度に許可された復元権限は、大規模な誤復元を招きやすい。きめ細かいIAM制御により、予期せぬ復元やデータ転送の課金リスクを直接低減できる。

Azureの停止を回避する方法

●ワークロードに応じたフェイルオーバー優先度の設定: すべてのワークロードが即時復旧を必要とするわけではありません。重要度に応じて分類し、階層化されたフェイルオーバー計画を設計します。ミッションクリティカルなシステムにはホットスタンバイ環境を有効化し、重要度の低いシステムにはコスト削減のためウォームまたはコールドリカバリを計画します。

●DNSフェイルオーバー自動化の事前準備: 停止はDNSレイヤーでアプリケーション可用性を損なうことが多い。Azureエンドポイント障害を自動検知し、最小限の遅延で代替リージョンやクラウドへトラフィックをリダイレクトするグローバルDNSフェイルオーバーソリューションを導入する。

●迅速な復旧のための不変インフラストラクチャの展開: インフラストラクチャ・アズ・コード(IaC)を活用し、環境定義をGitリポジトリに保存します。これにより、Azureのコントロールプレーン可用性に依存せず、他の地域やクラウドへの重要サービスの迅速かつクリーンなデプロイが可能になります。

●プロアクティブな対策のためのAzureサービスヘルスAPIの監視: これを監視スタックに統合し、サービス問題のプログラム通知を受信します。顧客に影響が出る前にワークロードを先制的にリダイレクトする自動スケーリングやフェイルオーバースクリプトと組み合わせます。

●分割シナリオに対する地域間レプリケーションの強化: 地域を跨ぐアクティブ-アクティブアーキテクチャを使用する場合、部分的な障害時の分割脳を防止するため、データ層に競合解決ロジックを設計します。重要なデータパスにはクォーラムベースの書き込みや強一貫性モデルを活用します。

Wasabiはバックアップと復旧にどのように活用されるのか?

●冗長化のためWasabiを二次バックアップ拠点と組み合わせる:別のバックアップ先(オンプレミスまたは他クラウドプロバイダー)と組み合わせることで、予期せぬ障害発生時にも事業継続性を確保します。

●バージョン管理と併せてWasabiオブジェクトロックを活用する:両者を組み合わせることで、部分的な破損や意図しない変更が発生した場合にファイルの状態を以前の状態にロールバックでき、ランサムウェアに対する強固な防御策となります。

●移行後のデータ検証と整合性チェックを実行:定期的な整合性チェック(チェックサム検証経由)を実行し、重要なバックアップファイルが完全かつ変更されていないことを確認します。これにより、時間の経過に伴うサイレントデータ破損を防ぎます。

●高速復元目標でバックアップスケジュールを最適化:バックアップウィンドウを最小化するスケジュールを設計します。バックアップが時間依存性を持つ場合、オフピーク時間帯のWasabiの高速性を活用し、パフォーマンスを最大化します。

●バックアップテストと復旧シミュレーションの自動化:テスト実行を自動化し、バックアップデータが目標RTO(復旧時間目標)とRPO(復旧ポイント目標)内で復元可能であることを確認します。Wasabiはデータ転送量(エグレス)を課金しないため、定期的な訓練でも予期せぬコストが発生しません。

Database Performance Analyzer (DPA)の理解:問題が発生する前にデータベースを監視するための完全ガイド:

データがキングである世界では、データベースの健全性とアプリケーションのパフォーマンスは表裏一体の関係にあります。遅いクエリ、リソースのボトルネック、最適化されていないワークロードは、ユーザー体験を悪化させ、コスト増を招きます。多くの企業はこうした問題に対処するため、Database Performance Analyzer(DPA)を活用しています。DPAは監視・最適化プラットフォームであり、データベース管理者(DBA)、開発者、ITチームがデータベースのワークロードを詳細に把握するのを支援します。

Database Performance Analyzer(DPA)の機能とは?ITチームは高度なツールであるDPAを活用し、データベースの動作効率に関する問題を検出、修正、診断します。DPAはシステムレベルの指標だけでなく、待機時間データも分析します。これにより、アプリケーションがデータベースとどのように連携しているか、パフォーマンス問題の真の原因がどこにあるかをユーザーが容易に把握できます。DPAは通常、多くの主要なリレーショナルデータベースプラットフォームと連携します。Oracle、SQL Server、MySQL、PostgreSQL、SAP ASE、DB2などです。ハイブリッドまたはマルチデータベースシステムを導入している企業は、多様なデータベースに対応するこの集中監視ソリューションを活用できます。

DPAにおける待機時間分析の重要性

従来のパフォーマンス監視ツールは、CPUやメモリの使用率を監視するだけでした。これらの指標は有用ですが、処理が遅延する根本原因を説明できません。DPAの最大の利点は、SQL文がロック、I/O、ネットワーク応答などの要因で待機する時間を特定できる点です。

  1. DPAは待機状態を分析して問題箇所を特定します。
  2. 問題を引き起こしている正確なクエリ
  3. パフォーマンス低下の主な原因
  4. ワークロードの経時的な挙動変化
  5. これにより医師は問題を早期に発見し、より正確に診断できます。
  6. データベースパフォーマンスアナライザーの最も重要な2つの機能は、リアルタイム監視と通知です。
  7. DPAは常にパフォーマンスデータを監視しているため、チームは問題が発生した時点で特定できます。

クエリの詳細分析

各ステートメントの実行頻度、リソースコスト、待機時間、実行時間に関する情報をユーザーに提供します。これにより開発者とDBAが連携し、機能不全のクエリを改善できます。

過去の発生傾向

DPAは長期間にわたりパフォーマンスデータを保持するため、パターンを分析し将来の要件を予測できます。チームは日単位、週単位、さらには年単位での進捗状況を振り返ることができます。

多様なプラットフォーム上で動作

DPAは様々なデータベースエンジンと連携するため、組織は全てを追跡するために多種多様なツールを使用する必要がありません。

使いやすいレポートとダッシュボード

可視化機能により、複雑なパフォーマンス統計を、必ずしもDBAではない開発者、システム管理者、マネージャーなど他の関係者にも理解しやすくします。

APMおよびITSMツールの活用

DPAは、チケットシステム、自動化プラットフォーム、アプリケーションパフォーマンス管理技術と連携して使用されることが多く、チームが単一のパフォーマンスエコシステムを構築するのを支援します。

現代のIT環境においてDPAが重要な理由

1. 作業の迅速化

クエリレベルや待機レベルでのパフォーマンス問題を特定することで、チームは大幅な時間節約が可能です。

2. アプリケーションの効率化

通常、データベースワークロードを最適化すれば、エンドユーザーにとって即座に改善が実感できます。

3. 連携の強化

DPAは全員に同一のパフォーマンスビューを提供するため、IT運用、開発者、データベースチームの協業が容易になります。

4. コスト削減

リソースの使用状況を正確に把握できれば、より的を絞った要求が可能になり、技術への負荷を軽減し、場合によっては高額なインフラ改善を回避できるかもしれません。

5. 信頼性の向上

プロアクティブな監視により、過酷な負荷条件下でも重要アプリケーションの安定稼働が保証され、ダウンタイム発生リスクを低減します。

データベースパフォーマンスアナライザーの活用タイミング

動作遅延アプリの高速化手法

不正動作SQL文の特定

アプリケーション移行・更新支援

拡張・増設準備

ハイブリッドクラウド/オンプレミスデータベースの監視

データベース変更がパフォーマンスに与える影響の検証

要約すると、データベースパフォーマンスアナライザーは、データベースに依存する多数のアプリケーションを運用する企業にとって優れたツールです。待機時間分析、明確なクエリ可視化、使いやすいダッシュボードにより、チームは問題発生後の対応から、問題発生前の機能改善へと移行できます。DPAは、データ環境が迅速かつ信頼性高く、ビジネスの必要に応じて拡張できることを保証するツールを提供します。

中央管理:

この機能は、個別のDPAサーバーを相互に連携させるために使用されます。中央サーバーはリモートサーバーから情報を収集し、データを単一のインターフェースに統合します。各DPAサーバーは独自のリポジトリを持ちます。中央サーバーのオーバーヘッドは低く、他のDPAインストール環境からの追加情報はリポジトリデータベースに追加されません。DPA Centralの導入を検討すべき状況は以下の通りです:

  • DPAを支えるインフラリソース(例:ストレージ可用性、I/Oスループット、RAM、CPU)が、分析対象クエリ量の増加に伴い容量限界に達する場合。
  • 監視対象インスタンスが地理的に分散しており、遠隔インスタンスへのネットワーク遅延時間が大きい場合。各拠点に個別のDPAサーバーを設置できます。
  • 別々のチームや事業部門が、担当するデータベースインスタンスのサブセットを管理できるようにしたい場合

注記: SolarWindsでは、データベースインスタンスの監視にも使用するサーバーにDPA Centralを設定することを推奨します。DPA Central専用の別サーバーを用意する必要はありません。

  • 中央サーバーの設定

– サーバーにDPAをインストールします。これが中央サーバーとなります。

– そのインスタンスに管理者としてログインします。

– 右上のDPAメニューから[オプション]をクリックします。

– [管理] > [表示] で [セントラル管理] をクリックします。

– 登録済みサーバーの一覧に、DPA サーバーが「セントラル DPA サーバー」として表示されていることを確認します

  • リモート DPA サーバーの追加

– 右上隅の DPA メニューから [オプション] をクリックします。

– [管理] > [表示] で [セントラル管理] をクリックします。

– [サーバーの追加] をクリックします。

– リモート DPA サーバーに関する情報を入力します。

– [接続テスト] をクリックし、[保存] をクリックします。

  1. テストが成功した場合、DPA がプロバイダーのホストとポートを介してリモートサーバーと通信できることを示します。DPA がユーザーを認証できることを示すものではありません。
  2. テストが失敗した場合は、[サーバー名] フィールドのホスト名を確認してください。アンダースコア (_) 文字が含まれていませんか?アンダースコアはホスト名として無効です。ホスト名を変更できない場合は、IP アドレスを入力してください。
  3. 残りのリモートDPAサーバーについても手順1~4を繰り返します。

注記: リモートDPAサーバーの詳細はリポジトリではなく、中央サーバー上の以下のファイルに保存されます:

DPA-install-dir/iwc/tomcat/ignite_config/iwc/central/RemoteRepositories.json

これはプレーンテキストのJSONファイルです。このファイルには機密データは保存されません

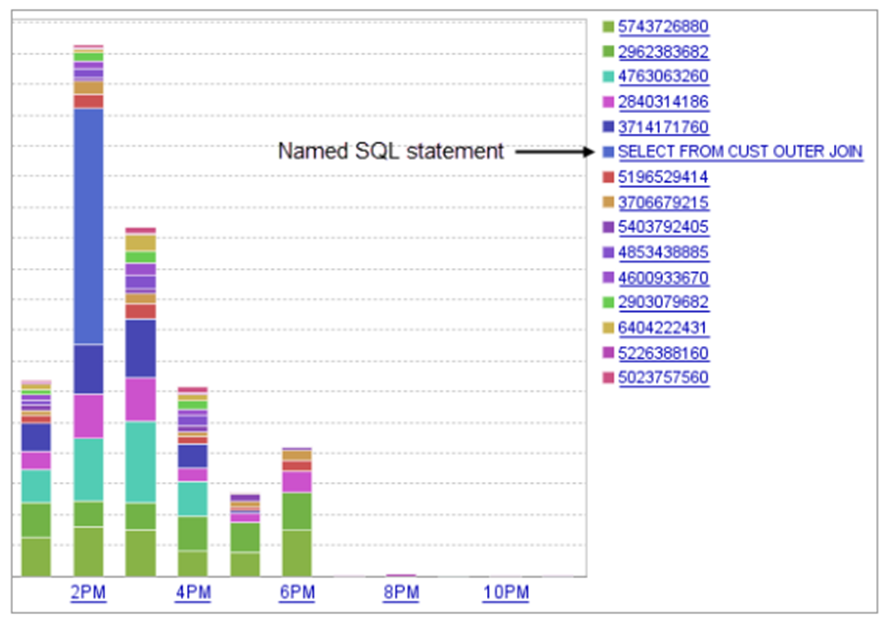
SQL文の除外:

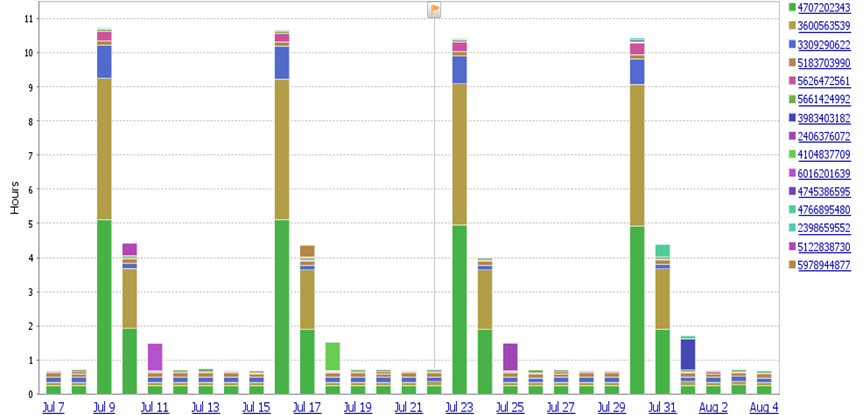
一部の長いSQL文は調整にうまく対応しない可能性があります(例: データベースのバックアップ、レプリケーション、データロードに関連するSQL文)。特定のクエリをDPAから除外することで、トレンドチャートを占有したり、効果のないチューニングアドバイスを生成したりするのを防げます。

注記: 除外されたSQL文がデータベースのパフォーマンスに影響を与え始めた場合、除外されているためDPAでは問題として表示されません。

  • サーバーに移動
  • SQL文を表す名前またはハッシュ値をクリックします。クエリ詳細ページにSQL文に関する情報が表示されます
  • 右上隅で「SQLプロパティ」をクリック
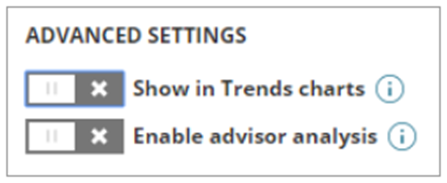
  • 詳細設定で、以下のいずれかまたは両方のオプションを無効にします:

– 「トレンドチャートに表示」設定を無効にすると、複数日または1日のトレンドチャートからSQL文が除外されます。1日未満の期間をドリルダウンすると、チャートにSQL文が含まれます。

– [アドバイザー分析を有効にする] 設定をオフにすると、クエリアドバイザーおよびテーブルチューニングアドバイザーを生成するために DPA が実行する分析からこのステートメントが除外されます。分析が無効な場合、DPA は SQL ステートメントの問題を検出しません。注記: [トレンドチャートに表示] 設定をオフにすると、両方のオプションがオフになります。DPA は、トレンドチャートに表示されない SQL ステートメントの分析を実行しません。

image.png

・Saveをクリック


レポートグループの作成:

レポートグループは、関連するレポートのデータを同一ページに表示するために使用されます。レポートグループを使用すると、複数のレポートを簡単に実行またはスケジュールできます。

  • 該当するサーバーをクリック
  • ページの右上にある「レポート」をクリック
  • 「レポートグループの作成」をクリック
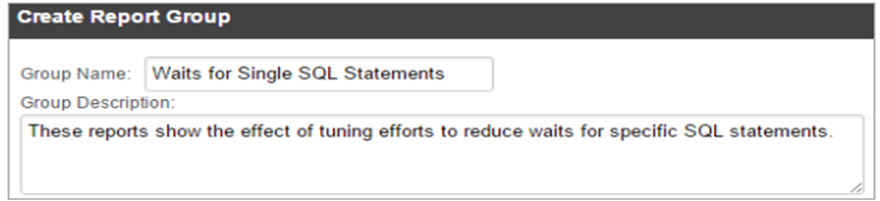
  • グループ名と説明を入力(説明は任意ですが、入力することを推奨します)

image.png

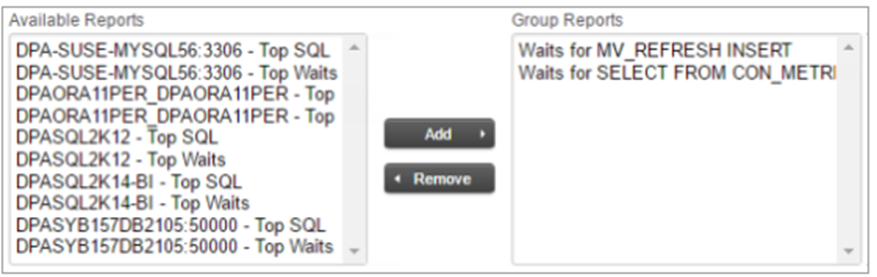
  • グループに含めるレポートを選択し、「追加」をクリック

image.png

  • OKをクリック

追加リソース: レポートグループの作成

SQL検索:

 SQL検索 機能は、SQL文に関する既知の情報に基づいて任意のSQL文を検索するために使用されます。時間範囲を指定し、任意のフィルタと検索文字列の組み合わせを適用できます。

  • DPAホームページから、検索対象のデータベースインスタンス名をクリックします。
  • ページ上部で「SQL検索」をクリックします(選択したデータベースインスタンスでこの機能が有効化されていない場合、ページにメッセージが表示されます)。Find SQL機能を有効化するには、全データベースインスタンスまたは特定のインスタンスに対して設定します。
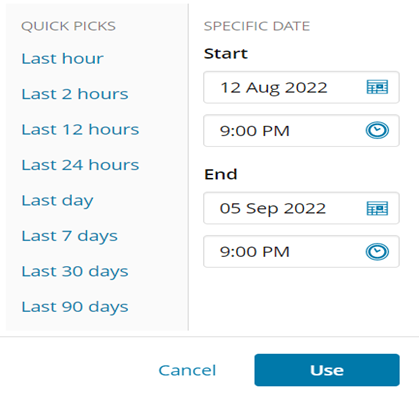
  • ページ上部で事前定義期間を選択するか特定の日付を入力(デフォルトは24時間)し、[検索]をクリック
  • フィルターの適用には、選択したデータベースインスタンスに応じて、以下のフィルターカテゴリの一部または全てが利用可能です:

image.png

データベースユーザー: SQL文を実行したユーザーID。

プログラム: SQL文を実行したアプリケーション。

データベース: SQL文がクエリを実行したデータベース。

マシン: SQL文が実行されたコンピュータ。

  • 左上隅の「フィルター」をクリック
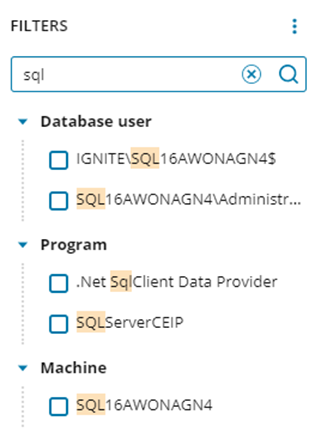
  • 値を検索するには、フィルター検索フィールドに検索文字列を入力します。検索文字列を含む値のみが表示されます

image.png

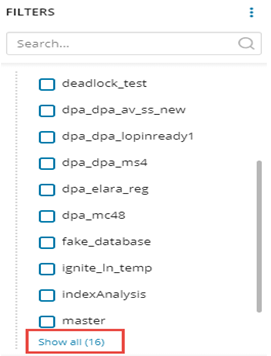
・フィルターカテゴリに10件以上のアイテムが含まれる場合は、「すべて表示」リンクをクリックしてください。

image.png

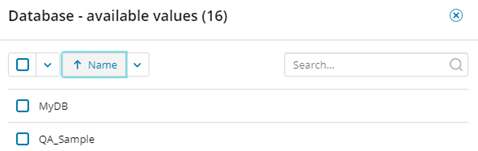
・ダイアログが開いたら、ページをめくってすべての項目を表示したり、並べ替え順を変更したり、検索したりできます。

image.png

  • 1つ以上のフィルターを選択し、[検索]をクリックして適用します。
  • 検索結果には、すべてのフィルターに一致するSQL文のみが含まれます。フィルターに検索語句が適用されていない場合、結果は待機時間順に並べ替えられます。
  • 適用されたフィルターは、[フィルター]ボタンと[検索]バーの上に一覧表示されます。

注:

  • SQLテキストが不明な場合、特定のユーザーによって実行されたSQL文、特定のアプリケーションの一部として実行されたSQL文、特定のコンピューターから実行されたSQL文、または特定のデータベースに対して実行されたSQL文を特定するためにフィルターを適用できます。
  • SQLテキストについて何か知っている場合は、テーブル名や実行されている操作などの検索文字列を入力できます。

追加リソース: SQLドキュメントの検索


DPA 導入ガイド:

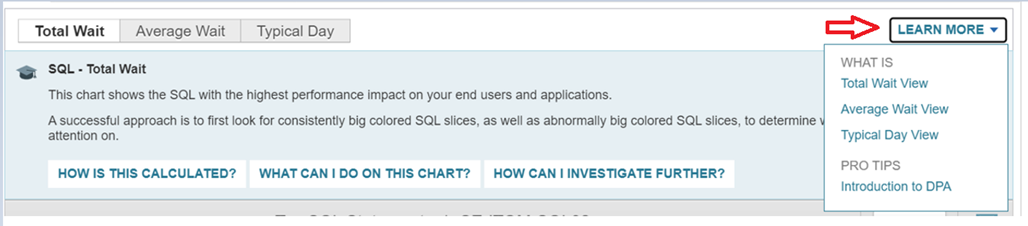
DPAに初めてサインインした際に概要動画を見逃した場合、トレンドページの右上に「詳細を見る」タブが配置されています。

image.png

注釈:

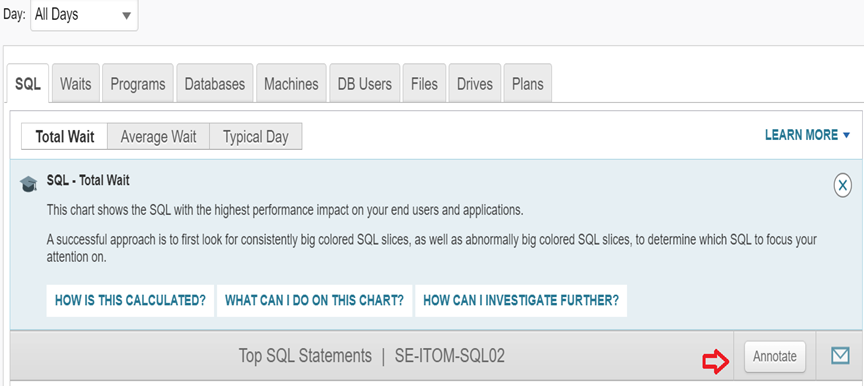
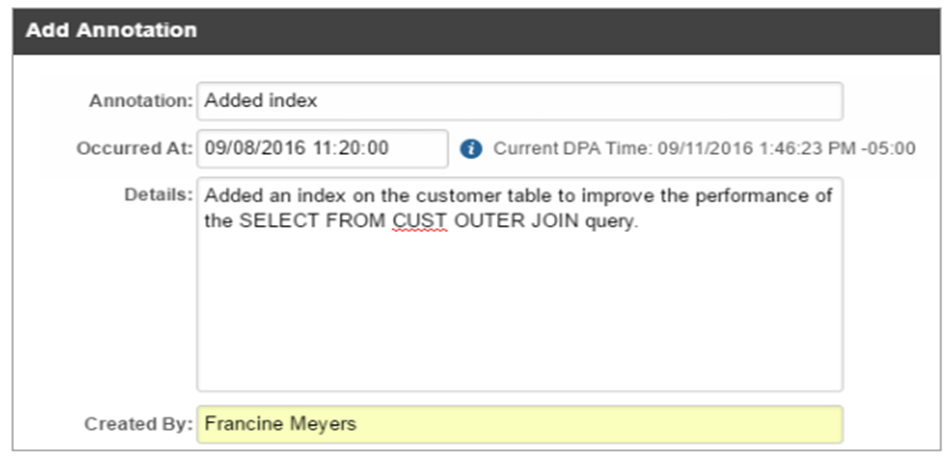
 注釈は、パフォーマンスに影響を与える可能性のある変更(インデックスの追加、クエリのチューニング、リソースの追加など)を行う際に使用します。注釈はすべてのトレンドチャートおよびタイムスライスチャートに表示されます。変更前後のパフォーマンスデータを比較することで、変更がどのような影響を与えたかを確認できます。

  • DPAホームページから、変更の影響を受けるデータベースインスタンスの名前をクリックします。
  • トレンドチャートの右上にある「注釈を追加」をクリックします。

image.png

  • 注釈に名前を付け、追加日時を指定し、変更内容とその理由の詳細を記入してください。保存をクリックします。注記:DPAサーバーが異なるタイムゾーンにある場合は、DPAサーバーの時刻を入力してください。

image.png

  • 注釈はチャート上にフラグとして表示されます。フラグにカーソルを合わせると概要が表示され、クリックすると詳細が表示されます。

image.png

リソースのカスタマイズ: カスタムメトリックしきい値:

リソースメトリックは、データベースの健全性を監視し、リソース競合とデータベース待機時間の増加を関連付けるために使用されます。リソースメトリックのグラフは、メトリックが警告または重大なしきい値を超えたことを示します。事前設定されたしきい値は、環境の要件に合わせて変更できます。メトリックに既定のしきい値が設定されていない場合、デフォルトのしきい値を追加できます。監視対象のインスタンスはすべて定義されたしきい値以下である必要があり、特定のデータベースインスタンスのみを対象とすることも可能です。カスタムしきい値は「デフォルトとして保存」をクリックすることで、すべてのインスタンスのデフォルトとして保存できます

  • 現在のしきい値を表示するには、確認したいリソースメトリックのしきい値を持つデータベースインスタンスをクリックします
  • リソースをクリック

image.png

  • 新しいしきい値を入力してください:

– メトリックにデフォルトのしきい値がない場合、有効にしたい各しきい値レベルの横にあるトグルスイッチをクリックします。

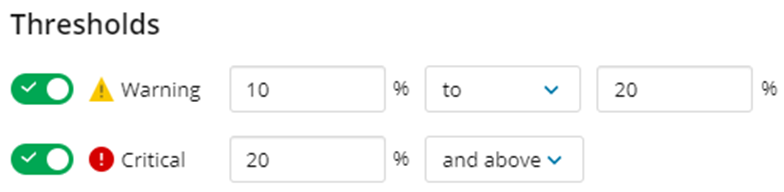
– 警告レベルと重大レベルの双方を有効にする場合、両レベルの交点に同じ値を入力します:

  • より高い値でアラートが発生するメトリックについては、警告の最大値と重大の最小値と同じ数値を入力します。

– DPAは値が警告範囲内(範囲を含む)の場合に警告アラートを発行します。DPAは値が最小重大閾値を超えた場合に重大アラートを発行します。

– 例:ステップ1で示したしきい値の場合、値が10から20の間にあればDPAは警告アラートを発行します。値が20を超えると、DPAは重大アラートを発行します。

  • 低い値でアラートが発生するメトリクスの場合、警告の最小値と重大の最大値に同じ数値を入力します。

– DPAは、値が警告範囲(範囲内を含む)にある場合に警告アラートを発行します。DPAは、値が最小重大しきい値未満の場合に重大アラートを発行します。

– 例:下記のしきい値の場合、DPAは値が90から95の間に警告アラートを発行します。DPAは値が90未満の場合に重大アラートを発行します。

  • 次のいずれかを実行します

このデータベースインスタンスのみに新しい値を適用するには、[保存]をクリックします。

すべてのデータベースインスタンスに新しい値を適用するには、[デフォルトとして保存]をクリックします。

  • [デフォルトとして保存]を選択した場合、インスタンスごとにカスタムしきい値が指定されていない限り、新しいデフォルトしきい値がすべてのデータベースインスタンスに適用されます。カスタムしきい値が設定されているデータベースインスタンスは、引き続きそれらのしきい値を使用します。

追加リソース: カスタムリソースしきい値

アイドルブロッカーの特定:

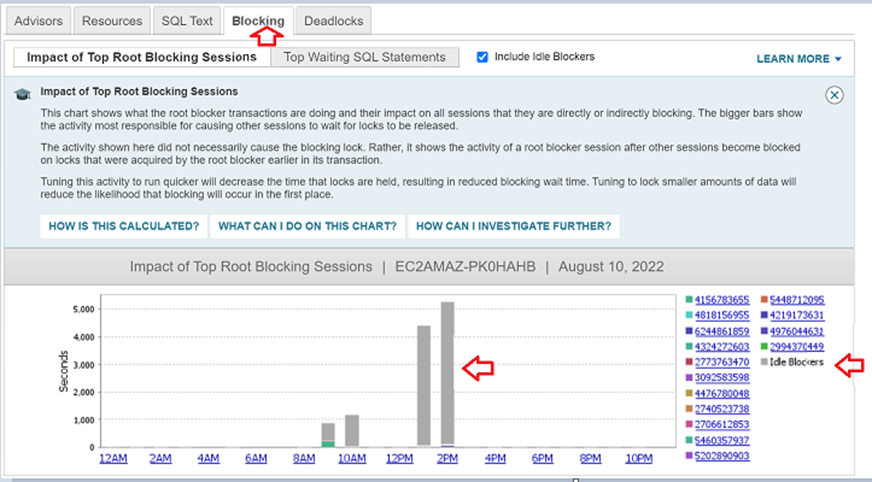
 アイドルブロッキングは、セッションがトランザクションを開いた(リソースにロックを設定した)後、明示的にコミットまたはロールバックを行わなかった場合に発生します。トランザクションは、現在作業が行われていないにもかかわらず、開いたままになります。アイドルブロッカーが存在するかどうかを確認するには、次の手順を実行します。

  • パフォーマンスが低下しているサーバーに移動します
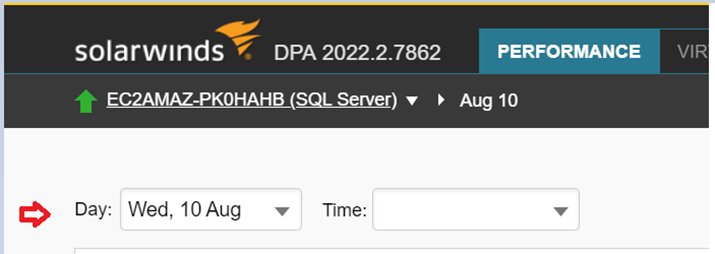
  • 日付でフィルタリングします

image.png

  • ページの一番下までスクロールしてください

image.png

  • 調査するには、バーまたは軸ラベルをクリックしてください。


カスタムアラートの作成: テンプレートとして使用できるカスタムスクリプトがいくつか投稿されています。

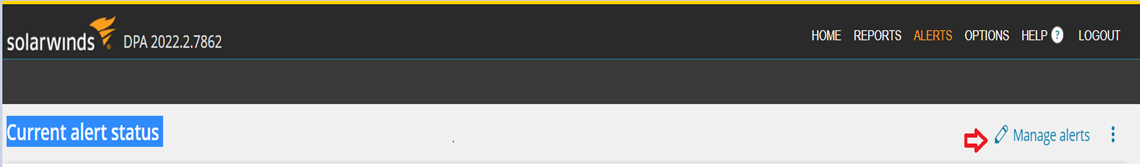
  • ホームページで、右上の「アラート」をクリック
  • アラートの管理」をクリックimage.png
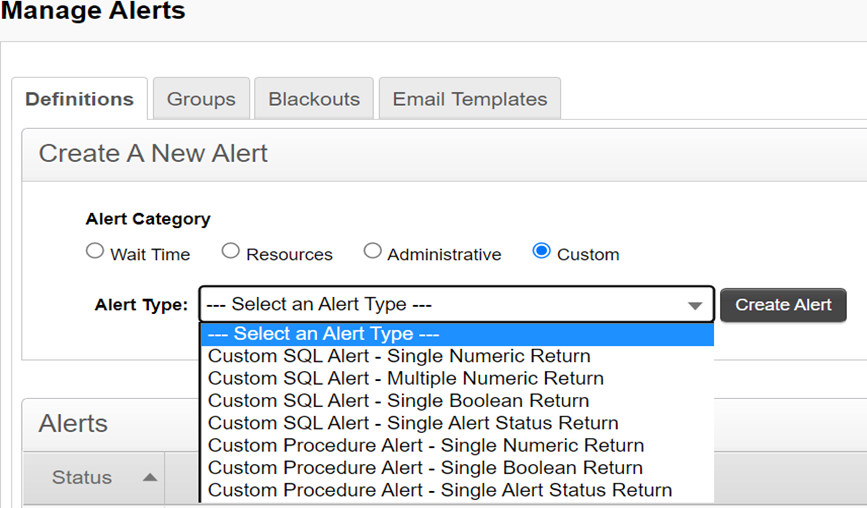
  • アラートカテゴリとして「カスタム」を選択し、アラートタイプを選択してから、「アラートを作成」をクリックします。

image.png

  • アラート情報セクションでは:

– 一意の名前を入力します

– アラートを無効にするには、[有効] チェックボックスをオフにします

– 実行間隔を選択します。(DPAでは、実行間隔を少なくとも10分以上にすることを推奨します。)

– メール通知と共に送信する通知テキストを入力します。問題の説明と推奨される解決策を含めてください。

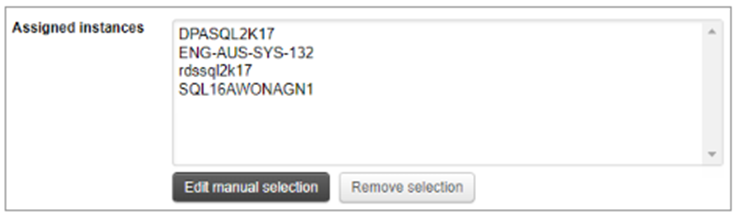
– アラートが適用されるデータベースインスタンスを指定します。これにより、SQLクエリまたはストアドプロシージャが(DPAリポジトリではなく)対象インスタンス上で実行されます。1つ以上の条件を満たすインスタンスは、手動で選択するか、ルールを使用して検索できます

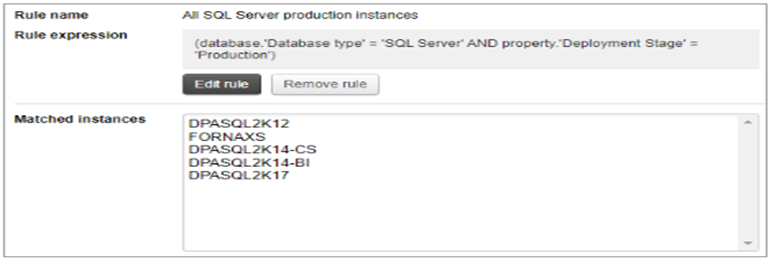
  • ルールを選択すると、DPAはルール条件に基づいてアラートが監視するインスタンスを決定します。環境が変更されるたびに、インスタンスのリストは自動的に更新されます。

– [ルールを使用]をクリック

– [ルール]ページには既存のルールが一覧表示されます

– 既存のルールを選択するか、新規ルールを作成して選択します。

– [ルールの割り当てをクリア]

– アラート定義には、選択したルール名、ルール式、および現在ルール条件を満たしているインスタンスの一覧が表示されます。

image.png

  • データベースインスタンスを手動で選択する場合、リストは静的です

– [データベースインスタンスの選択] をクリックします。

– 利用可能なデータベースインスタンスページにはデータベースインスタンスが一覧表示されます。アラートタイプが特定のデータベースタイプに限定されている場合、該当タイプのインスタンスのみが表示されます。

– 検索バーを使用してインスタンスを検索するか、フィルターを適用してリストを絞り込みます

– リスト内の全インスタンスを選択するには、リスト上部のチェックボックスを選択します。個々のインスタンスを選択するには、各インスタンスの横にあるチェックボックスを選択します。

– [割り当て]をクリックして戻る

– アラート定義画面に選択したインスタンスの一覧が表示されます。

image.png


  • アラートパラメータセクション

– 実行するSQL文を入力するか、ストアドプロシージャの呼び出しを入力します。カスタムタグを使用して、データベースIDなどの変数や、ストアドプロシージャに必要な出力パラメータを含めることができます。

– [実行対象]ドロップダウンで、SQL文またはストアドプロシージャを、選択したデータベースインスタンスに対して実行するか、DPAリポジトリデータベースに対して実行するかを指定します。

– [説明]フィールドが利用可能な場合、アラート用のカスタム説明を入力できます。この説明は、メールテンプレートに[説明]パラメータが含まれている場合、アラートタイプのDPAデフォルト説明に置き換わります。

– アラートが数値を返す場合、返される値の単位を指定します。

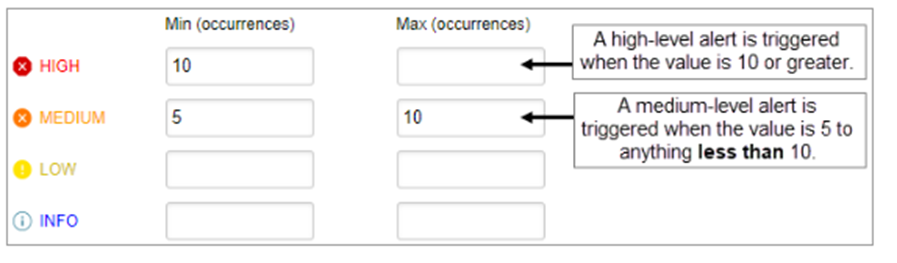
  • アラートが数値を返す場合、有効にする各アラートレベルのしきい値を指定します。

– 最高レベルの最大値は空白のままにすると、そのレベルの最小値を超えるすべての値に対してアラートが通知されます。

– 複数のレベルを設定する場合、下位レベルの最大値は必ず等しい上位レベルの最小値に設定してください。

– レベルの最大値を入力すると、値が最小値を上回るか等しいが、最大値を下回る場合に、DPAはそのレベルでアラートを通知します。例えば、最小値が5で最大値が10の場合、値が5以上10未満のときにDPAはそのレベルでアラートを通知します。

image.png

  • 各アラートレベルがトリガーされたとき、およびアラートが解除されたときに通知を受け取る個人またはグループを選択します(アラートステータスは、実行中にエラーが発生した場合に「解除」に設定されます)。アラートが「正常」に戻ったときに通知を送信するには、「正常」の受信者を選択します。アラートが「正常」に戻ったときに通知を送信するには、通知ポリシーが「レベル変更時に通知」である必要があります。
  • このアラートによって送信されるメール通知の内容を定義するメールテンプレートを選択します。
  • [メールプレビュー]をクリックすると、選択したメールテンプレートと連絡先情報を使用して生成されるメールの例を確認できます。

– アラートが複数のデータベースインスタンスに適用される場合、[メールプレビュー]ダイアログボックスでインスタンスを選択し、[OK]をクリックします。メールを確認後、別のデータベースインスタンスを選択するか、[キャンセル]をクリックして[メールプレビュー]ダイアログボックスを閉じることができます。プレビュー中に評価できないアラートパラメータがあるため、ユーザーに送信されるメールはプレビューと完全に一致しない場合があります。

  • アラートをテストし、現在のアラートレベルを確認するには、[アラートテスト] をクリックします。テストではメールは生成されません。
  • [保存] をクリックします。

追加リソース: カスタムアラートのドキュメント


Name SQL ステートメント

  • 適切なサーバーをクリックしてください
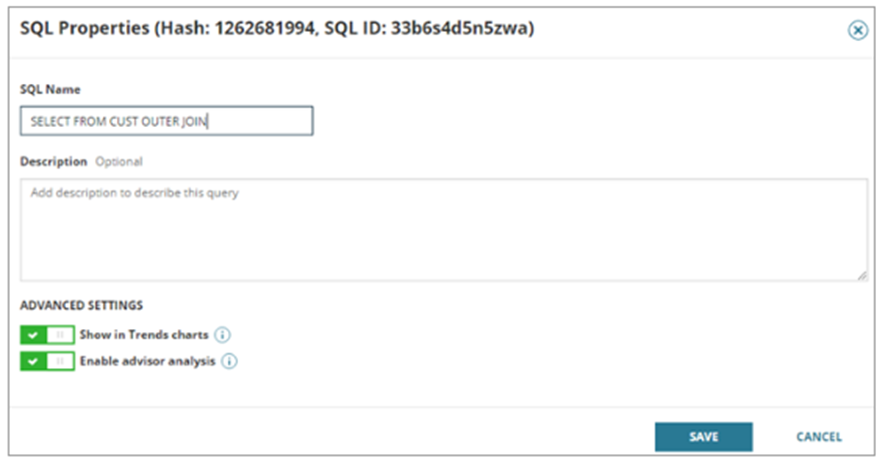
  • チャート内のハッシュ値(トップSQLステートメントの右側)をクリックしてください。注:SQLステートメントはデフォルトでハッシュ値によって識別されます

image.png

  • 右上の「SQL プロパティ」をクリックします
  • SQL 名フィールドに名前を入力します。

image.png

  • 保存をクリック
  • 現在のページの左上にある戻るをクリックして前のページに戻ります

image.png

Kill SQL Session (DPA)

  • パフォーマンスが低下しているサーバーに移動する
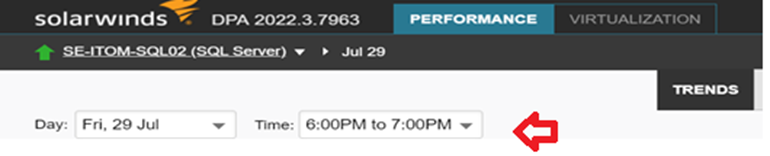
  • ページの左上にある「日付と時間」でフィルタリングする

image.png

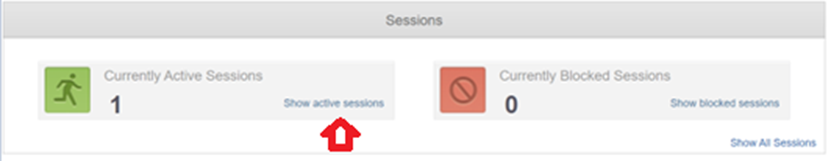
  • 下にスクロールして「アクティブなセッションを表示」をクリックしてください。

image.png

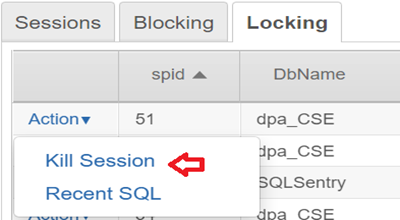
  • ロックまたはブロックタブをクリック
  • アクションのドロップダウンメニューをクリックし、「KILL」を選択

image.png


ロールと権限の管理に関するベストプラクティス

  1. 最小権限の原則 — 必要な権限のみを割り当てます。「万一に備えて」アクセス権を与えることは避けてください。
  2. 管理にはサービスアカウントを使用 — 専用のアカウント(例:backup.admin@company.com)を作成し、従業員の個人アカウントの使用を避ける。
  3. 権限は手動で有効化 — デフォルトでは、ユーザーはサインインおよび復元の権限がプロファイルで明示的に有効化されていない限り、M365/Googleバックアップへのアクセスや復元操作を実行できない。
  4. 代替メールアドレス — 緊急時のアクセスや必要なデータ削除を可能にするため、パスワード付きの代替メールアドレスを追加する。
  5. 定期的な監査 — 役割を定期的に確認し、不要なユーザーアカウントを無効化し、復元権限を持つユーザーを監視してください。元従業員のアカウントを有効なままにすると、攻撃者による不正アクセスにつながる可能性があります。

Climb Cloud Backup バージョン4.8の新機能

Climb Cloud Backup(CCB) for Microsoft 365およびGoogle Workspace バージョン4.8に組み込まれたマネージドクラウドストレージにより、以下のメリットが得られます:


迅速な導入:外部ストレージの設定なしでバックアップを開始できます。

設定の簡素化:MSP360コンソールから直接Amazon S3またはWasabiを選択可能。

設定エラーの削減:手動での認証情報や権限管理が不要。

柔軟な選択:必要に応じてMSP360管理ストレージまたはBYOS(Bring Your Own Storage)を利用可能。

ユーザーエクスペリエンスの向上:ガイド付きワークフロー、明確な警告、監査可視性により初日の設定が簡素化。

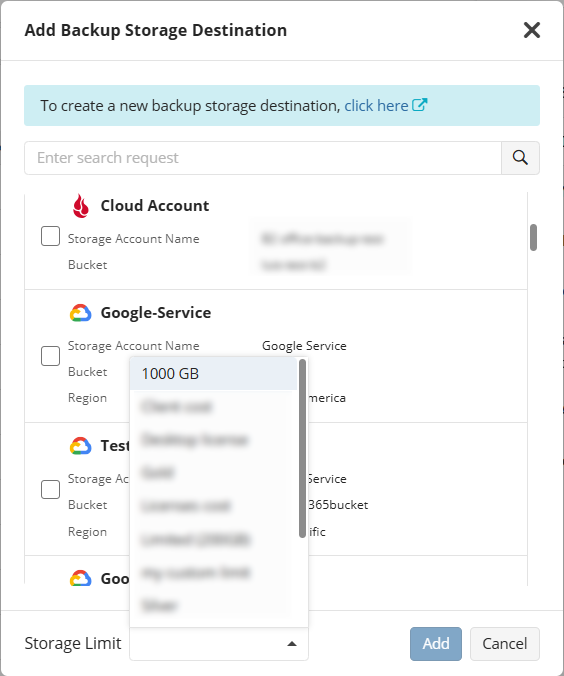
Climb Cloud Backupで、企業単位で保存先ごとの保存容量制限を設定する

会社単位で保存先(バケットまたはローカル)ごとにストレージ制限を設定できる新機能をリリースされました。


このリリースにより、ローカルストレージとクラウドストレージに対して会社ごとに異なる制限を個別に適用可能となります。これにより、クラウドストレージにはより厳格な制限を設定しつつローカルストレージの柔軟性を維持することで、より精密かつ細分化されたストレージコスト管理を実現します。


ストレージ制限付きの新規バックアップ先を追加、または既存のバックアップ先を編集するには、組織タブに移動し、会社セクションを開きます。左側のプラスアイコンをクリックして新規バックアップ先を追加するか、編集ボタンをクリックして既存のバックアップ先を変更します。表示されるスライドインパネルでバックアップ先を選択してください。


Storage Limits