投稿者「climb」のアーカイブ

災害復旧(DR)データにクラウドを利用することは可能ですか?

数テラバイト規模のデータを保有し、オフサイトのアプライアンスを設置する第2の拠点を持たない中小企業は、DRデータをクラウドプロバイダーに保存するソリューションを採用しています。クラウドベースのDRにおける真の課題は、バックアップデータが日々変化するため、データをクラウドに転送する時間が18時間未満しかなく、多大な帯域幅を必要とする点にあります。セキュリティの観点から見ると、自社のデータは他社のデータも保存されているストレージ上で混在することになります。

さらに、データ復旧が必要な場合、妥当な時間内に復旧することは事実上不可能です。数十テラバイトからペタバイト規模のデータを保有する企業は、セカンドサイト用のバックアップストレージシステムを収容するために、第2のデータセンターを保有しています。3年間の総コストで比較すると、自社でオフサイトのDRアプライアンスを運用する方が、DRデータをクラウドにレプリケートするよりもコストが低く、復旧時間もはるかに短縮されます。また、データは組織の物理的およびネットワーク上のセキュリティの背後で管理され、他組織のデータと混在しないため、セキュリティ面でもはるかに優れています。

重複排除されたデータは、ランサムウェアからの復旧に役立つのでしょうか?

ExaGridの「Tiered Backup Storage」のように、2層構造のアプローチを採用したソリューションであれば、重複排除された長期保存データはハッカーから守ることができます。ExaGridのディスクキャッシュ「Landing Zone」は、高速なバックアップと復元を行うための、ネットワークに接続されたストレージ層です。一方、「リポジトリ」は、長期保存用のデータ格納を行う、ネットワークに接続されていないストレージ層です。ハッカーはネットワークに接続された階層にはアクセスできますが、ネットワークに接続されていない階層にはアクセスできません(これによりエアギャップが形成されます)。

リポジトリ(長期保存階層)には、不変の重複排除オブジェクトが必要です。つまり、これらは決して変更、削除、上書きされないことを意味します。バックアップアプリケーションによってパフォーマンス階層内でデータが暗号化されたり、パフォーマンス階層に書き込まれたりした場合、新しい重複排除オブジェクトが追加されますが、以前の重複排除オブジェクトを上書きすることは決してありません。このアプローチにより、長期保存データが侵害されることはありません。

パフォーマンス用のプライマリ層と、削除を遅延させる機能を備えた長期保存用のネットワーク非接続層を組み合わせることで、バックアップデータが削除されず、いつでも復元可能な状態が保たれます。さらに、2つ目のネットワーク非接続層と不変の重複排除オブジェクトを組み合わせることで、長期保存データが侵害されるのを確実に防ぎます。プライマリサイトのデータを復元しても、長期保存データはすべて保持されたままです。

最大30日間の削除遅延を維持する場合、ストレージ容量はわずか10%の追加で済みます。これに対し、完全に独立した保存ロックストアを使用すると、バックアップストレージが2倍になり、2つのデータストアを維持する必要が生じます。

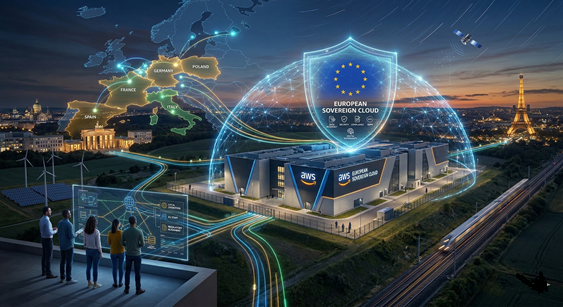
MSP360 Backup では、AWS European Sovereign Cloudをバックアップストレージ先として利用可能に

AWS欧州主権クラウドとは(そして顧客が求める理由)

AWSは、既存のAWSリージョンからの追加的な分離、ID/アカウントおよび請求管理のための独立したシステム、EU要件向けに設計された運用措置など、EUの主権目標に沿って設計された環境を必要とする顧客向けにESCを提供しています。

お客様の組織が公共部門や規制産業(金融、医療、重要インフラ)に属する場合、議論は「EUリージョン」から「主権的立場」へと移行することが多い。ESCは、その次のレベルの要件に対応するために存在する。

提供開始:ストレージ先として「Amazon S3 EU」

MSP360 Backup PROでは、クラウドストレージアカウントを追加する際にAmazon S3 EUが表示されるようになりました。

これにより、AWSのクラウドモデルに沿った保存先を選択しながら、慣れ親しんだバックアップワークフロー(プラン、保持期間、暗号化、復元)を維持できます。

対象となるユーザー

●「バックアップデータをAWS欧州主権クラウドに保存できますか?」という問いに対し、明確な「はい」が必要なチーム

●EU顧客向けに主権クラウドオプションを明示的に要求されるユーザ

●より厳格なEUガバナンス要件に対応した環境でのバックアップ保存を求める規制対象組織

データ中心型企業になる方法

物理世界では、メールから猫動画、このブログ記事に至るまで、情報は絶えず生成され、管理され、消費されている。エラーメッセージやシステムログ、誰も読まないアラートメールは言うまでもない。そしてこのデジタルデータは決して消滅せず、ROT(冗長・陳腐・無意味な情報)の氾濫を招く。

データ中心の姿勢を強化すれば、ROTの過剰を削減し、適切なデータのみを収集して情報に基づいた意思決定が可能になる。複雑である必要はない。このサーバーは何度再起動されたか?再起動にはどれくらい時間がかかるか?データ収集は、こうした単純な質問に過剰なデータ加工なしで答えられるようにすべきです。データは何に使うのか?プレゼン資料や監視環境のダッシュボード用かもしれません。あるいは開発マネージャーに「チームが2週間データベースサーバーにログインしていない」と示すためのメトリクス収集かもしれません。最終目標を明確に把握することで、最も合理的な方法でデータを収集できます。質問はしばしば仮定に基づきますが、データから得られる情報は偏見を裏付けるのではなく、事実を明らかにする助けとなるべきです。例えば、サーバー再起動がパッチの頻繁な適用によって引き起こされているかどうかを判断したい場合、「パッチはどのくらいの頻度で適用されていますか?」と尋ねる代わりに、「再起動を必要とするパッチはいくつありますか?」と尋ねることができます。この数値をサーバー再起動の総数と比較することで、パッチ適用が再起動に与える影響頻度を結論付けられます。

  1. 適切な質問から始める
  2. 最終目標を設定する
  3. 良い質問を投げかける

データが容易に入手できる現代では、価値あるデータのみを収集することに集中するのが難しい場合があります。データ中心の考え方を強化し、データ駆動型のアプローチを採用することで、環境内のROT(Redundant, Obsolete, Trivial)を減らし、データの過剰蓄積を防ぐことができます。

Database Performance AnalyzerはSQLパフォーマンスに何ができるのか

Database Performance Analyzer(DPA)は、継続的な監視を提供し、応答時間分析と履歴動作ログを組み合わせることでパフォーマンスのベースライン確立を支援し、SQLパフォーマンスチューニングプロセスにおける推測作業を大幅に削減するように設計されています。DPAを使用すると、特にDPAのインテリジェントな機械学習機能と組み合わせることで、異常な動作を迅速に検出することも可能です。

DPAに統合されたテーブルチューニングアドバイザー機能は、クエリと実行計画を分析し、非効率なSQLクエリが実行されているテーブルを特定することで、Microsoft SQL Serverの最適化機会に対処し、情報に基づいたチューニング判断を下せるよう支援します。DPAの組み込みSQLパフォーマンス分析ツールでは、相対的なワークロード順にランク付けされた、テーブルにアクセスする非効率なSQLの詳細な分析も確認可能です。

DPAにはクエリパフォーマンスアナライザー機能も含まれており、クエリに関する最重要データを収集し、直感的で分かりやすいダッシュボードビューで表示します。クエリ詳細ページでは待機タイプやクエリ・チューニングアドバイザーを色分け表示し、チャートを組み立てることで、ユーザーは特定されたパフォーマンス問題を容易に検証・対処できます。カスタマイズ可能なレポートとアラートにより、ブロック階層やブロッキングがデータベース全体のパフォーマンスに与える影響に関する洞察も提供します。

SQLパフォーマンス・チューニング・ツールどう役立つのか

多くの企業や組織(オンライン小売業者から政府機関まで)の主要な機能は、データベースにおける情報の保存とアクセスを中心に展開しています。内部ユーザーも外部ユーザーも、アプリケーションやウェブサイトが効率的かつ迅速に動作することを期待しています。このため、サーバーとデータベースが可能な限り効率的に機能することが重要です。

1回のクエリで数ミリ秒の遅延はさほど大きく感じられないかもしれませんが、データベース内の各クエリで遅延が発生すると、それはすぐに累積していきます。これに、生成され続ける膨大なデータ量が加わることで、データベースへの書き込みや情報取得のプロセスはますます煩雑で時間のかかるものとなります。ビジネスに不可欠なプロセスに遅延や速度低下が生じると、組織全体の機能が損なわれる可能性があります。

効果的なMS SQLチューニングには、データベース管理者とIT専門家がSQL Serverのパフォーマンスを常に把握し、データベース関連の操作が可能な限り効率的に実行されるようにすることが求められます。

なぜSQLパフォーマンス・チューニングは重要なのか

多くの企業や組織(オンライン小売業者から政府機関まで)の主要な機能は、データベースにおける情報の保存とアクセスを中心に展開しています。内部ユーザーも外部ユーザーも、アプリケーションやウェブサイトが効率的かつ迅速に動作することを期待しています。このため、サーバーとデータベースが可能な限り効率的に機能することが重要です。

1回のクエリで数ミリ秒の遅延はさほど大きく感じられないかもしれませんが、データベース内の各クエリで遅延が発生すると、それはすぐに累積していきます。これに、生成され続ける膨大なデータ量が加わることで、データベースへの書き込みや情報取得のプロセスはますます煩雑で時間のかかるものとなります。ビジネスに不可欠なプロセスに遅延や速度低下が生じると、組織全体の機能が損なわれる可能性があります。

効果的なMS SQLチューニングには、データベース管理者とIT専門家がSQL Serverのパフォーマンスを常に把握し、データベース関連の操作が可能な限り効率的に実行されるようにすることが求められます。

SQLパフォーマンス・チューニングはどのように始動するのか

SQL Serverデータベースのパフォーマンスチューニングの第一歩は、必要または望まれるほど効率的に実行されていない遅いSQLクエリを特定することです。

SQLチューニングには、将来予測可能な問題を未然に防ぐ「予防的」アプローチと、特定のユーザー問題が発生した際の「事後対応的」アプローチがあります。データベースクエリのチューニングにおいて、DBAが考慮すべき基本的なベストプラクティスを以下に示します:

  • インデックスは慎重に作成する。 インデックスはデータ取得用のデータ構造であり、行の選択を高速化しますが、ボトルネックを避けるため慎重に作成する必要があります。
  • ループ処理を避ける。 クエリ実行時の繰り返し処理や過剰負荷を回避すべきです。
  • SQLサブクエリの相関を避ける。 サブクエリは親クエリを参照し、行単位で処理されるため、処理速度が低下します。

待機時間と統計情報は、SQL Serverのパフォーマンスチューニングの重点領域を特定する有効な手段です。SQL Serverは「スレッド」を介してユーザー要求を管理し、各種スレッドのパフォーマンスを監視することで、管理者はどのクエリが低パフォーマンスであるかをより正確に判断できます。チューニングプロセスの目的は以下の通りです:

応答時間の短縮: ステートメント実行から応答までの時間

スループットの最適化: ステートメント処理に必要なリソース量

ただし、SQL Server パフォーマンス問題の根本原因を特定するには、データベース管理者はデータベースとサーバーの全レイヤーに関する洞察が必要となる場合があります。SQL Server チューニングツールは、上位 SQL ステートメント、待機タイプ、ブロックされたクエリ、およびインデックス不足がサーバーやデータベースのパフォーマンスに与える影響に関する理解を深めるプロセスを迅速化・効率化するのに役立ちます。

SQLパフォーマンス・チューニングとは

SQLパフォーマンスチューニングは、リレーショナルデータベースのクエリを可能な限り迅速かつ効率的に実行するために設計された一連の手順とプロセスです。SQLチューニングにはいくつかのステップが含まれます。まず、遅延が発生しているクエリを特定し、次にそれらのクエリを最適化して効率を最大化し、応答時間を短縮します。SQL Server、MySQLなど、多くのリレーショナルデータベースでSQLチューニングが必要となる場合があります。

管理者はシステムレベルでサーバーのパフォーマンス問題に対処しようと試みることができます(追加メモリやプロセッサの導入など)。しかし、これらの対策は実装コストが比較的高く、SQL Serverへの遅延クエリの根本原因に対処できない場合があります。SQLパフォーマンスチューニングは、不適切に記述されたSQLクエリや非効率的なインデックスを特定することでパフォーマンス向上を支援します。これはハードウェアや技術仕様の改善よりも、より的を絞った解決策となり得ます。

ただし、SQLのパフォーマンスチューニングは、特に手動で行う場合や大量のデータを管理する組織にとっては困難な作業となり得ます。こうした調整(たとえ小さな変更であっても)は、SQLサーバーやデータベースのパフォーマンスに広範な影響を及ぼす可能性があります。

Azure バックアップの暗号化へのヒント

地理的に冗長化された暗号化対応の実装: 地理的に冗長化されたストレージ(GRS)を利用する場合でも、暗号化されたバックアップデータは暗号化された状態で複製されることを理解してください。CMKを使用する場合は、プライマリ地域とセカンダリ地域の両方でキーが利用可能であることを確認してください。地域災害時の復元失敗を回避するため、キーの複製または協調的な復旧戦略を計画してください。

メンテナンス期間中にキーバージョンの変更を事前準備:キーローテーションは透過的に見えるかもしれませんが、依存サービスが新バージョンを認識していない場合、バックアップや復元が遅延する可能性があります。計画されたメンテナンス期間中にキー更新を段階的に実施し、ダミーバックアップでテストして、特に高スループット環境において下流への影響がないことを確認してください。

ポリシースキャンによる保管庫暗号化ドリフトの監視: カスタム Azure Policy 定義を使用し、想定される暗号化構成から逸脱したリカバリ サービスまたはバックアップ保管庫(例: CMK ではなくプラットフォーム管理キーの使用)をフラグ付けします。CI/CD パイプラインまたは Azure ガバナンス ダッシュボードに統合し、構成ドリフトを防止します。

暗号化構成を規制ゾーンにマッピング:コンプライアンスゾーン(「PCI」「HIPAA」「内部」など)でベールをタグ付けし、ベール暗号化(CMK、インフラストラクチャ暗号化)が各ゾーンの規制要件に準拠していることを確認します。このアプローチは監査の自動化に役立ち、混合コンプライアンスレベルの共有環境で有効です。

キーボルト管理者には条件付きアクセスとジャストインタイム(JIT)アクセスを適用:Azure AD条件付きアクセスポリシーと特権ID管理(PIM)経由のJITアクセスでこれらの役割を保護します。これにより、必要な場合にのみアクセスが許可され、厳密に制御されます。

Azure における N2WSを使用した暗号化されたクラウド バックアップ

N2WSは、AWSおよびAzureのお客様向けにポリシーベースのバックアップと災害復旧の自動化を提供します。N2WSはスナップショットベースのバックアップ層として機能し、Azureのネイティブ暗号化インフラストラクチャの上に位置し、お客様が既に設定済みのディスク暗号化と連動して動作します。

N2WSによるAzureバックアップの保護方法

暗号化

AzureはAES-256を用いて、データ暗号化キー(DEK)を介してバックアップデータを保護します。DEKはさらに、Azure Key Vaultに保存されたキー暗号化キー(KEK)によって保護されます。N2WSは、設定不要でデフォルトで有効なプラットフォーム管理キー(PMK)と、Azure Key Vaultに保存されたRSAキーでエンドツーエンドの暗号化を制御する顧客管理キー(CMK)の両方をサポートします。

N2WSがCMKで暗号化されたディスクのスナップショットを作成すると、追加手順なしで自動的にディスクの暗号化が継承されます。バックアップデータは、Azure Key Vaultのキーによって常に保護された状態を維持します。必要に応じて、N2WSは復元時に別のディスク暗号化セット(DES)を適用することも可能であり、復元されたデータを保護するキーを変更する柔軟性を提供します。

不変性

暗号化に加えて、N2WSは不変バックアップという形で追加の保護層を追加し、最高水準の保護を使用してバックアップの改ざんや削除から守ります。不変バックアップのポリシーが有効化されると、特定の保持期間に対して「削除」ロックタイプが割り当てられ、その期間中のいかなる変更や削除も防止されます。ストレージアカウントリポジトリの場合、N2WSは保存されたオブジェクトごとにリースを設定します。リースされたオブジェクトは、リースが明示的にキャンセルされるまで削除または変更できず、偶発的または悪意のある削除に対するさらなる安全策となります。

アクセス制御

データ自体の保護に加え、N2WSはAzureのロールベースアクセス制御システムと連携し、コンプライアンス基準に沿った安全なアクセスポリシーを適用します。プラットフォーム設定の一環として、組織はAzure内でカスタムIAMロールを構成します。これにより管理者はバックアップリソースとのやり取りを許可する対象を厳密に制御でき、最小権限の原則に沿ったアクセス権限を保証します。

毎週金曜日に実施できる30分の復元(リストア)テスト

ほとんどの「バックアップテスト」は大きすぎるために失敗します。
こちらが軽量な週ごとのルーティンです:

ステップ 1️– ターゲットを1つ選ぶ
• 1つのエンドポイントまたは1つのクリティカルフォルダー
• クライアント/エンドポイントを週ごとにローテーションする

ステップ 2️ – 2回の復元を実行する
• ファイルレベル:1つのファイルを別の場所に復元する
・システムレベル:小さな画像スナップショットや重要なアプリ設定(該当する場合)を復元する

ステップ 3️– 検証
• 可能であればチェックサム/ハッシュ
・許可/所有権確認
• App Openテスト(設定/データベースダンプ用)

ステップ 4️ – 3桁だけ記録する
・時間を回復する
• 位置(どこ)を復元する
・壊れたもの(もしあれば)

4〜6週間後にはパターンが見えます:
✔️ 帯域幅のボトルネック
✔️ 保持ギャップ
✔️ 許可の驚き
✔️ きれいに復旧しない「グリーンジョブ」

これが本当のバックアップ成熟度、つまり回復の再現可能な証明です。

Acronis サイバー脅威アップデート – 2026年2月

🔹 Acronisは2026年1月にエンドポイントで170万+件の悪意ファイルをブロックしましたが、これは12月の230万件から減少しましたが、URL攻撃は35.6%増加しました。
🔹 1月には約723件の公表データ漏洩が記録されました
🔹 最も活動的なランサムウェアグループ:Qilin(被害者102人)、Cl0p(被害者79人)、0apt(被害者71人)
🔹 主なマルウェア脅威:Mirai、XWorm、AsyncRAT

Windowsユーザのためのdockerで知っておくべき点は?

WindowsでDockerを利用する場合、以前は様々な苦労がありましたが、現在はWSL 2(Windows Subsystem for Linux 2)の登場により、MacやLinuxとほぼ変わらない快適な環境が構築できるようになりました。

WindowsユーザがDockerを扱う上で、特に知っておくべき重要なポイントを5つにまとめました。


1. 「WSL 2」バックエンドが必須かつ最強

現在の「Docker Desktop for Windows」は、WSL 2ベースのエンジンを使用するのが標準です。

  • メリット: 従来のHyper-Vを使った方式に比べて、起動が圧倒的に速く、メモリの消費も効率的です。また、Windows HomeエディションでもDockerが動くようになりました。
  • 注意点: インストール時に必ず「Use WSL 2 based engine」にチェックを入れるようにしてください。

2. ファイルの置き場所でパフォーマンスが激変する

Windows側(C:\ など)にソースコードを置き、それをコンテナ(Linux)にマウント(Bind Mount)すると、OS間のファイル変換処理が発生して動作が非常に遅くなります(特にNode.jsの node_modules などファイル数が多い場合)。

  • 解決策: ソースコードは**WSL 2のファイルシステム内(\\wsl$\Ubuntu\home\user\... など)**に配置してください。これにより、ネイティブのLinux環境と同等のI/O速度が出ます。
  • 開発手法: VS Codeの拡張機能「WSL」や「Dev Containers」を使うと、WSL内のファイルをWindows側のVS Codeでシームレスに編集できて非常に快適です。

3. 改行コード問題(CRLF vs LF)

Windowsユーザが最もハマりやすい罠です。Windowsの標準の改行コードは CRLF ですが、Linux(Dockerコンテナ内)は LF です。

  • 起きる問題: Windows上で作成したシェルスクリプト(.sh)などをコンテナ内で実行しようとすると、「コマンドが見つからない」といった謎のエラーが起きます。
  • 解決策: エディタの設定で改行コードを LF にして保存する癖をつけるか、Gitの設定で core.autocrlf を適切に設定(またはプロジェクトに .gitattributes を配置)して、勝手に CRLF に変換されないように防ぐ必要があります。

4. WSL 2のメモリ・CPU制限(.wslconfig

WSL 2は初期設定のままだと、Windowsのシステムメモリを最大で50%(またはそれ以上)も確保しようとするため、PC全体の動作が重くなることがあります。

  • 解決策: Windowsのユーザーフォルダ(C:\Users\<ユーザー名>\)直下に .wslconfig という設定ファイルを作成し、WSL 2(つまりDocker)が使えるメモリ上限を設定しておくことを強くおすすめします。

.wslconfig の記述例:

Ini, TOML

[wsl2]
memory=8GB
processors=4

5. 「Linuxコンテナ」と「Windowsコンテナ」の違い

Docker for Windowsには、通常のLinux環境を動かす「Linuxコンテナ」モードと、Windows Server環境などを動かす「Windowsコンテナ」モードの2つが存在し、タスクトレイのアイコンから切り替えることができます。

  • 基本はLinux: Web開発などで使うイメージ(Ubuntu、Alpine、Python、Node、Nginxなど)はすべてLinuxコンテナ向けです。基本的には「Linuxコンテナ」モードのままでOKです(標準設定です)。

WindowsでのDocker開発は、**「WSL 2内にコードを置き、VS CodeのDev Containersで繋ぐ」**というスタイルが現在のベストプラクティスです。

N2WSによるクラウドバックアップコスト最適化戦略

クラウドデータセンターの長期的な展望

長期的に状況が一変しています。AIモデルはメモリ効率と演算効率が向上し、高性能SSDやDRAMへの過度の負荷が軽減されると予想される。同時に、新たなファブやデータセンターが稼働を開始し、供給制約は徐々に緩和されるでしょう。

歴史的に、ハイパースケーラーはインフラ構築時に容量を過剰に確保する傾向があり、一時的な供給過剰を生み出してきました。そうなると競争が復活する:プロバイダーはワークロード獲得で競い合い、価格圧力は緩和され、企業は低コストなストレージオプション、より柔軟な階層化、改善されたクラウド経済性の恩恵を受けます。

時間の経過とともに、この短期的な不足のサイクルは、ハイパースケーラー間のクラウド市場におけるより競争的な状況へと変化します。効率性、拡張、過剰供給、そして競争の復活が常態化し、クラウド戦略と企業のコスト最適化の両方を形作るでしょう。

イノベーションの成長痛

企業にとってより重要なのはパニックではなく計画です:AI駆動型インフラ経済が今日のクラウドコストにどう波及するかを理解し、このサイクルを乗り切るためのアーキテクチャを構築することです。AIは企業が構築するものを変えるだけではありません。静かにクラウド請求書の様相も変えつつあるのです。

要約:

ストレージコストを簡単に削減したい場合、N2WSはAWSおよびAzureワークロードの保護をより費用対効果が高く(かつシンプルに)実現します。

・クラウドバックアップコストの最適化とは、長期ストレージの階層化を効率的に活用することです。具体的には、低コストリポジトリへの移行や初回フルバックアップのホットストレージ料金の削減を実現しつつ、データの可用性と即時復元可能性を確保します。

・長期ストレージにおける最大のコスト要因は、隠れたライセンス費用と、安価なアーカイブストレージをサポートしないバックアップツールによる限定的なストレージ選択肢です。

・N2WSを利用するお客様は、予算を圧迫することなく、データライフサイクル管理を簡素化し、長期保存データを効率的に保管し、長期保持期間を要求する様々な規制に準拠しています。

・今すぐAWSまたはAzureバックアップストレージの年間節約額を予測しましょう。

AI駆動型クラウド災害復旧の導入方法

これまで、データバックアップおよび災害復旧ベンダーのほとんどは、自社製品にAI機能を直接統合していません。技術購入者は、ツールに「AI」というラベルを安易に貼っているベンダーには警戒すべきです。なぜなら、ベンダーが「あらゆる自動化はAIの一形態である」と主張し、この用語を大雑把に用いているケースがあるからです。実際にはそうではありません。

競合他社を過度に批判していると非難されないよう、IDCの災害復旧におけるAIに関するレポートを引用しておこう。「災害復旧および事業継続ソリューションにおける包括的なAIの活用はまだ初期段階にある。ただし、厳密な定義には当てはまらない場合でも、ほとんどのベンダーが何らかの技術をAIとして位置付けている」と述べている。IDCはさらに、AI搭載機能が災害復旧ツールの主要要素となるのは少なくとも2025年以降と予測している。

つまり、クラウド災害復旧戦略にAIを統合するには、単に「AI対応」を謳うツールを購入して終わりでは不十分です。しかし企業ができるのは、汎用的なAI技術を災害復旧シナリオに応用することです。

そのための基本手順は以下の通りです。

#1. AI活用事例を特定する

まず、災害復旧の文脈でAIに何を期待するかを明確にする。過去の課題から復旧作業の精度と信頼性を高めることが目的か?予算制約からコスト削減を目指すか?それとも別の目的か?

AIソリューションに何を期待するかを把握することは、実現方法を決める上で重要。

#2. AIツールまたはプラットフォームの選択

次に、想定するユースケースをサポート可能なAIツールまたはプラットフォームを選択します。一般的に、OpenAIのGPTモデルやGoogle Geminiなどのいわゆる生成AI基盤モデルは、復旧計画の分析やプレイブック生成など、AI駆動型災害復旧に関連するタスクを実行できます。これらのソリューションの利点は、事前学習済みで使いやすいことです。

とはいえ、ソフトウェア開発リソースと専門知識があれば、独自のAIモデルを構築したり、既存のオープンソースモデルをカスタマイズしたりすることも可能です(容易ではありませんが)。

#3. モデルに関連データを学習させる

使用するAIツールやプラットフォームを選んだら、ユースケースを理解するために必要なデータをモデルに学習させます。例えば、プレイブック生成が目的なら、ファイル・ディレクトリ・データベースのマッピングをモデルに提示し、復旧手順の提案を依頼できます。あるいは、バックアップデータ構造と本番システムのマッピングを投入し、復旧成功率を高めるバックアップ改善策を求められます。

機密性の高いビジネスデータをサードパーティのAIツールやプラットフォームに公開することは、プライバシーリスクを伴う可能性があることに留意してください。これを軽減するには、ユーザーデータの管理方法について厳格な保証と制御を提供するモデルを選択します。あるいは、可能であれば、ディレクトリ自体ではなくファイルディレクトリ構造などの情報を共有することで、機密情報の公開を完全に回避します。

#4. AI駆動ワークフローの訓練と更新

バックアップと復旧の要件は頻繁に変化する可能性が高いため、運用を支えるAI駆動ワークフローの更新も必要です。例えば、新しいアプリケーションやデータベースを導入した場合、変更を確実に反映させるために、更新されたプレイブックを生成したり、復旧戦略を再評価したりすることが望ましいでしょう。

AWS:N2Wでバックアップを簡単にコールドストレージに保存

AWS Backupのコールドストレージポリシーを手動で管理するのは、すぐに複雑になります。ライフサイクルルール、Glacier移行、復元テスト…やることが山積みです。N2WSなら驚くほど簡単になります:

自動アーカイブ:AnySnap Archiverで(増分)EBSスナップショットやRDSバックアップをGlacierやDeep Archiveへ即時移動。

●1クリックで復元:個々のファイル、サーバー全体、VPC全体をコールドストレージから閲覧・復元。煩雑な手動プロセスを待つ必要はありません。

コスト可視化:組み込みのコストエクスプローラーダッシュボードで、コールドストレージによる節約額を一目で確認。

クロスクラウド対応:AWSバックアップをAzureやWasabiに復元する必要が?問題ありません。コールドストレージはロックされたストレージを意味しません。

N2WSなら、ストレージコストを最大92%削減できるだけでなく、制御性、速度、コンプライアンスを損なうことなく維持できます。

Wasabi とAmazon S3の統合について

小ファイルのストレージ最適化: アップロード前に小ファイルを大きなアーカイブファイル(例: TARやZIPを使用)にまとめ、APIのオーバーヘッドを削減し、取得パフォーマンスを向上させます。

マルチスレッドアップロードの活用: Wasabiは高速性を重視して設計されていますが、マルチスレッドアップロード(aws s3 cp –multipart-chunksize または SDKベースの並列アップロードを使用)を利用することで、アップロード時間を大幅に短縮できます。

Wasabi Direct Connectの利用: 大量のデータを頻繁に移動する場合は、専用ネットワークリンクにより高帯域幅と低遅延を実現するWasabi Direct Connectをご利用ください。

使用量計測でストレージ増加を監視: Wasabiはストレージ使用量をリアルタイムで追跡するAPIを提供します。請求書待ちではなく、これを利用してストレージ需要を事前に管理しましょう。

バケットライフサイクルポリシーを戦略的に実装: AWS S3とは異なり、Wasabiはデータエクソージットに対して課金しませんが、ライフサイクルポリシーは不要なオブジェクトを自動削除し、不要な散乱を防ぎ、取得効率を向上させることで、ストレージコストの最適化に依然として役立ちます。

Outlookのバックアップの重要性について

マイクロソフトの共同責任モデル

Microsoft 365 は何をサポートするか

●インフラストラクチャの安定性
M365 インフラストラクチャの稼働時間Microsoft 365 をホストするインフラストラクチャおよびソフトウェアの最大稼働時間

●データ複製データは複数の場所に複製されますが、手動によるファイル削除からの保護は提供されません

●アクセス制御利用可能なアクセス制御には、基本的なパスワード認証と多要素認証が含まれます

●物理的アクセス物理インフラストラクチャへの不正アクセスからの保護

●設定と管理Microsoft は Microsoft 365 をホストするインフラストラクチャの設定と管理を行います

ユーザはどのような責任を負うのか?

●データ安全性とコンプライアンス

●M365 データ可用性データの可用性とアクセス権限は、M365 ユーザーの責任です
データ保持データは、業務上の必要性、適用される法令、または社内ポリシーで定められた期間保持する必要があります

●内部攻撃悪意のある従業員が意図的にデータを削除する可能性があります

●仮想/デジタルアクセスMicrosoft 365リソースへのアクセス権を得た第三者による保護が必要です。ランサムウェア攻撃の一環として、データを暗号化し身代金を要求する可能性があります

●規制コンプライアンスM365ユーザーは、当該データを管理する規制ポリシーに準拠した方法で機密データを保管する必要があります

Climb Cloud Backupを利用する理由

Climb Cloud Backupの Outlook Backup機能は、Microsoft 365およびGoogle Workspace向けのクラウド間バックアップソリューションを提供します。ローカルインフラを必要とせず、重要なExchange Onlineデータの安全な保護と迅速な復元を保証します。また、設定が容易な自動化オプションも備えています。

●メールフォルダーとメール
受信トレイ、送信済み、アーカイブ、カスタムフォルダーを含む全ユーザーのメール(添付ファイルとヘッダー付き)

●連絡先と配布リスト
業務上重要な連絡先、同期されたアドレス帳、カスタムフィールド

●カレンダーイベントとスケジュールデータ
会議、招待状、繰り返しイベント、関連メタデータ

●サブフォルダーとフォルダー構造
正確な復元のため、ユーザー定義のメール整理構造を保持

●メタデータ
宛先、差出人、件名、タイムスタンプ、カテゴリ。コンプライアンス、監査、フォレンジック保存に不可欠

●共有メールボックスと委任アクセス
共有または委任された権限を通じてユーザーがアクセス可能なアイテム

パブリックフォルダーのメールコンテンツ
●Exchangeパブリックフォルダーに保存されたメールアイテム

●削除済みアイテムと復元可能なフォルダー
Microsoftの保存期限を超えたアイテムの復元もサポート

Climb Cloud BackupでOutlookをバックアップ

主な機能:
・M365およびGoogle Workspaceのバックアップ
・自社所有ストレージの活用
バックアップ履歴
・役割ベースのアクセス制御
・高度な暗号化
・アイテム単位のバックアップと復元
・隠れた費用なし
・レポート機能
・保存ポリシー
・監査ログ
・多要素認証
・グループ管理操作
・PSTファイルへのエクスポート
・メール通知

バックアップとリカバリーに関するWasabiの活用方法

●冗長化のためWasabiと二次バックアップ場所を組み合わせる: 別のバックアップ先(オンプレミスまたは他クラウドプロバイダー)と組み合わせることで、予期せぬ障害発生時にも事業継続性を確保します。

●バージョン管理と併せてWasabiオブジェクトロックを活用する: 両者を組み合わせることで、部分的な破損や意図しない変更が発生した場合にファイルの状態を以前の状態にロールバックでき、ランサムウェアに対する強固な防御策となります。

●移行後のデータ検証と整合性チェックを実行:定期的な整合性チェック(チェックサム検証経由)を実行し、重要なバックアップファイルが完全かつ変更されていないことを確認します。これにより、時間の経過に伴うサイレントデータ破損を防ぎます。

●高速復元目標によるバックアップスケジュールの最適化:バックアップウィンドウを最小化するスケジュールを設計します。バックアップが時間依存性を持つ場合、オフピーク時間帯のWasabiの高速性を活用し、パフォーマンスを最大化します。

●バックアップテストと復旧シミュレーションの自動化:テスト実行を自動化し、バックアップデータが目標RTO(復旧時間目標)とRPO(復旧ポイント目標)内で復元可能であることを確認します。Wasabiはデータ転送量(エグレス)を課金しないため、定期的な訓練でも予期せぬコストが発生しません。

AV-TEST ATP結果:Climb Cloud Backup & Securityは高度なWindows攻撃に対する完全な保護を提供

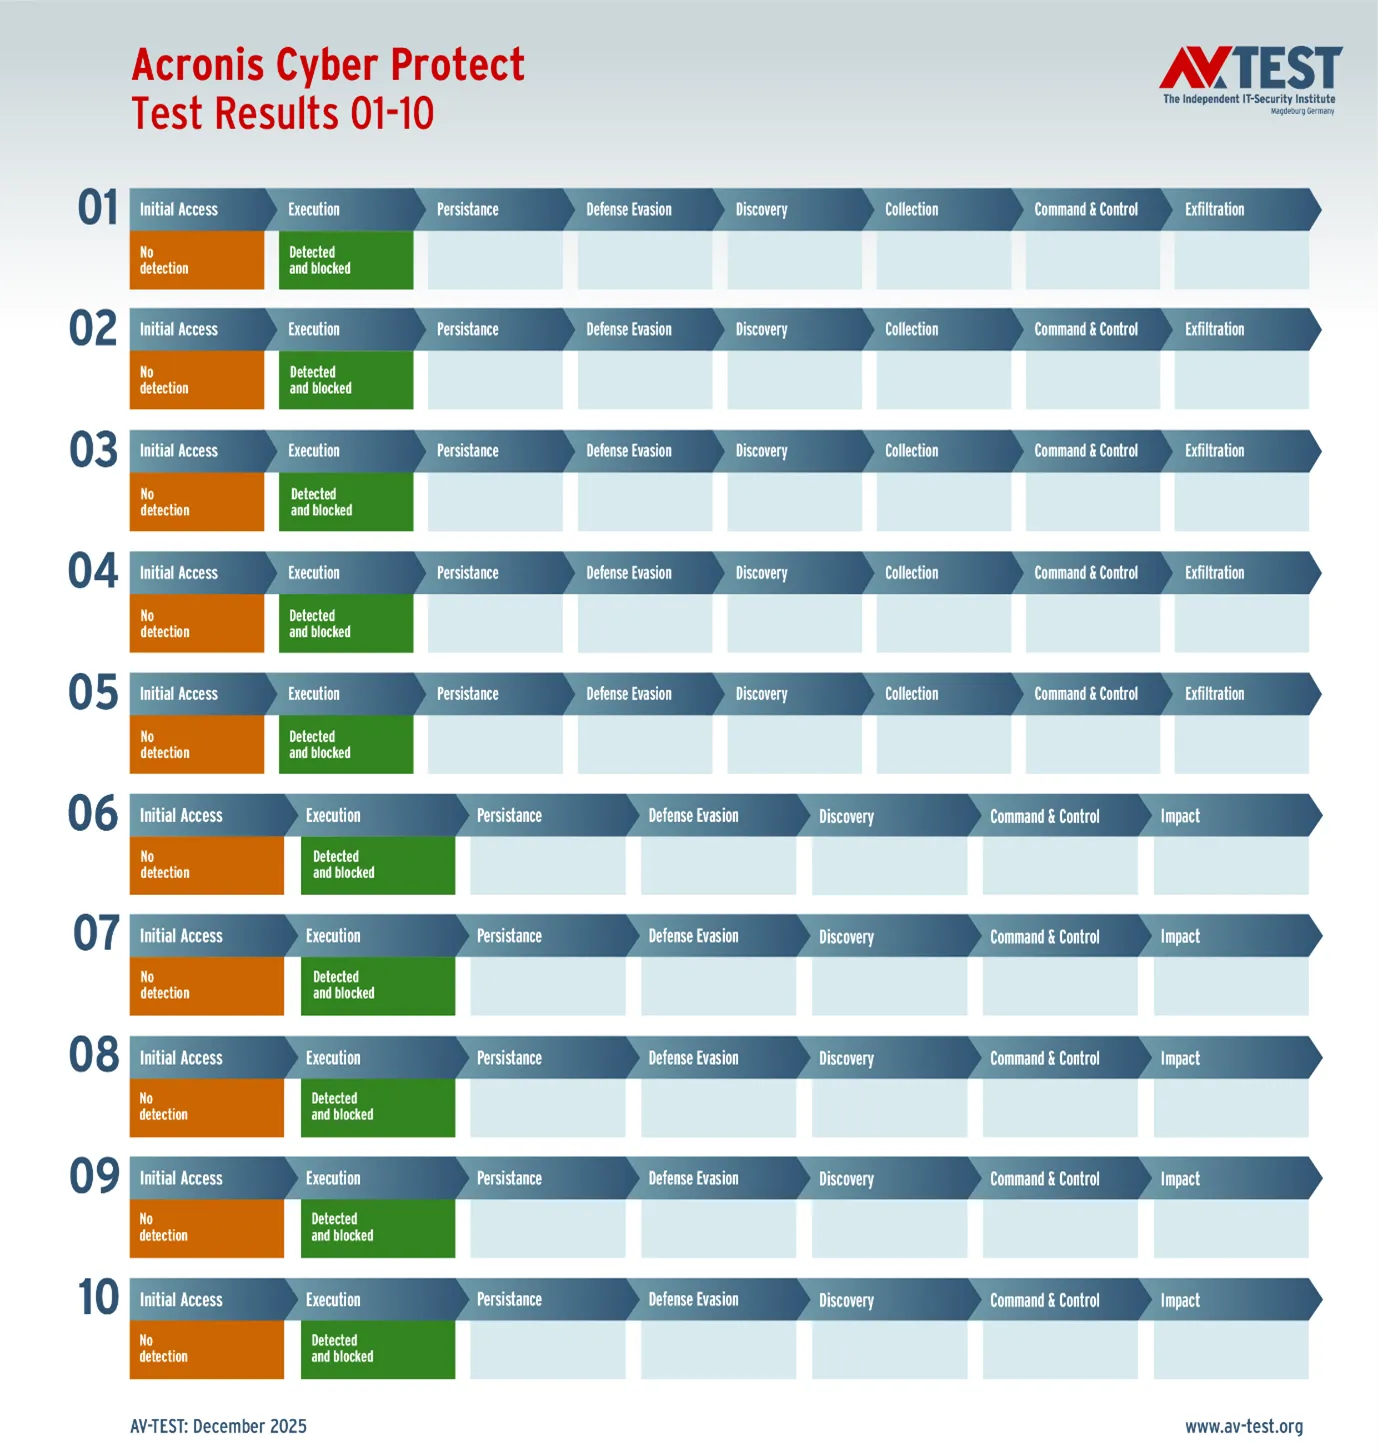
Climb Cloud Backup & Securityのベース・サービスであるAcronis Cyber Protect Cloudは、AV-TESTによる最新の高度脅威対策(ATP)評価において最高保護スコアを達成しました。 Acronis Cyber Protect Cloudは35点満点中35点の完全スコアを獲得し、ランサムウェアと情報窃取の両手法を含む10の高度なWindows攻撃シナリオをすべてブロックしました。 攻撃者が巧妙な「現地資源利用型」手法に依存する傾向が強まる中、この結果はアクロニスの行動検知技術と実環境防御能力の強みを裏付けるものです。

評価対象の企業向けエンドポイントソリューションの中で、Acronis Cyber Protect Cloudは完璧なパフォーマンスを発揮しました。実際、Acronisソリューションはテストに含まれた高度な攻撃シナリオ10件すべてを防御に成功し、35点満点中35点という最高の保護スコアを達成しました。これにより、主要ベンダーと並ぶ企業セグメントのトップクラスのパフォーマンスを実現しています。

Acronisは優れた結果で保護スコア要件を満たしたものの、テスト対象の特定製品はAV-TESTの定期的な公的認証シリーズの対象外でした。このため、Acronisは今回のATP評価において正式な認証称号を取得していません。

詳細レポートはこちら:https://www.av-test.org/en/antivirus/business-macos/manufacturer/acronis/

AWS European Sovereign Cloud をバックアップの保存先(Amazon S3 EU)として利用する

「AWS European Sovereign Cloud をバックアップの保存先(Amazon S3 EU)として利用する」というのは、簡単に言うと「EUの極めて厳しい法規制やセキュリティ基準をクリアするために、通常のAWSとは完全に切り離された『EU専用の特別なAWS環境』にあるS3にデータをバックアップすること」を意味します。

それぞれの要素について、分かりやすく解説します。

1. AWS European Sovereign Cloud とは?

AWSがヨーロッパの政府機関や、規制の厳しい業界(金融、医療、通信など)向けに提供している完全に独立したクラウド環境です。通常のAWSリージョンとは以下の点で異なります。

  • 完全なデータ主権(データ・ソブリンティ): データがEU圏外に出ないことはもちろん、インフラの運用やサポートを行うスタッフもEU圏内に居住するEU市民に限定されています。
  • 他国の法律からの保護: 米国などの外国の法律(CLOUD法など)によるデータ開示要求からデータを守るための強力な防壁が設けられています。

2. なぜそれをバックアップ先(Amazon S3)として使うのか?

企業や組織がシステム障害やランサムウェア攻撃に備えてバックアップを取る際、**「本番データだけでなく、バックアップデータも厳格な法規制に従って保管しなければならない」**というルールがあります。

  • コンプライアンスの遵守: GDPR(EU一般データ保護規則)などの厳しいプライバシー・セキュリティ要件を満たしつつ、安全な場所にデータを退避させることができます。
  • Amazon S3の強力な機能の活用: S3の「11ナイン(99.999999999%)」と呼ばれる圧倒的なデータ耐久性や、ランサムウェア対策となる「S3 オブジェクトロック(一度書き込んだら一定期間削除・変更できない機能)」を、主権が担保された環境でそのまま利用できます。

3. どのような組織に必要なのか?

主に以下のような組織で利用(または利用が検討)されます。

  • ヨーロッパの政府機関や自治体
  • ヨーロッパで活動する金融機関、医療機関、重要インフラ企業
  • EU域内でビジネスを展開しており、顧客から最高レベルのデータ保護を求められているグローバル企業(日本企業も含まれます)

要約すると:

AWS European Sovereign Cloudをバックアップ先にするメリットとコストの関係は、以下のように要約できます。

「バックアップ担当者の操作感や設定方法は今まで通り(完全互換)で、コストを15%ほど上乗せするだけで、EUの最高レベルの法的保護とデータ主権(他国からのデータ開示要求などを受けない権利)をユーロ建てで買うことができる」

EU圏内で厳格なデータ保護規則(GDPRや、金融業界向けのDORA、重要インフラ向けのNIS2指令など)の対象となるビジネスを展開されている企業にとっては、監査をクリアするための非常に強力で確実な選択肢となります。

N2WSMSP360 Backup は AWS European Sovereign Cloudを完全サポートしています。

Climb Cloud Backup & Securityの新機能

C26.04での新機能

・Synology NASに対して、マーケットプレイスからのエージェントのデプロイ
・Linuxカーネル6.16~6.19をサポート
・DRネットワーク間ファイアウォール
・Windows Server 2025のDRサポートによるフェイルオーバ
・MDRレポートのウィジェット化
・パートナーレベルでのソフトウェアおよびハードウェアのインベントリリスキャン


C26.03での新機能

・テナント単位での保護計画の適用(エージェントベースバックアップのみ)
・バックアップに設定したパスワードの変更が可能に
・M365の保護計画において「組織全体」のバックアップが選択可能に
・ARM版Windows用のエージェントが実装
・テナント単位でのEDRおよびXDRのアクティブ化
・Acronis MDRの統合
・AIによるリモートデスクトップセッションの可視化
・カスタムユーザロールによる操作制御


C26.02での新機能

・Acronis GenAI Protection
・サポートOSの追加
 Red Hat 9.7、10.1
 Ubuntu 25.10
 Fedora 43
 Rocky Linux 9.7、10、10.1
 AlmaLinux 9.7、10、10.1
 CloudLinux 10
 Oracle Linux 9.6、9.7、10、10.1
・Promxmox VEへのフルリストアおよびインスタントリストア
・Virtuozzoへのフルリストア
・Scale Computingへのフェイルオーバおよび自動増分フェイルバック
・週次での自動フェイルオーバテスト
・自動フェイルオーバテストの実行結果をエグゼクティブサマリーレポートへ組み込み


C26.01での新機能

・自動テストフェールオーバの実行結果をPDF形式でレポート
・すべての顧客テナントに対する脆弱性診断とパッチ管理を一元管理
・リモートセッションでのクリップボード貼り付け対応
・Web UIへのサインオン方式をユーザ単位で設定
・IdP統合によるシームレスなユーザ管理


C25.11での新機能

・Advanced Backup機能の標準化と調整
 ※S3等のパブリッククラウドへの直接バックアップ機能を除く
・アーカイブ用ストレージの実装
・M365およびGoogle Workspaceのバックアップデータの重複排除
・イベント検索による脅威の検出
・Proxmox VMのディザスタリカバリのサポート
・RMMオペレーターロールによるアクセスや操作の制御
・RHEL 9.xのDRサポート


C25.10での新機能

・MacOS 26のサポート
・エージェントのアンインストール防御の自動的な有効化
・Eメール通知での技術者の個人署名
・MSP向けのサービスデスクの電子メール通知
・SIEM Connector 2.0リリース


C25.08での新機能

・Proxmox VE 9のエージェントレスバックアップ
・EmailデータをPSTファイルとしてアーカイブ
・Azureへのコールドフェイルオーバの高速化
・Nutanix AHV VMのフェイルオーバのサポート
・WindowsおよびmacOSのCLIのリモート実行
・管理対象デバイスのシリアル番号の表示

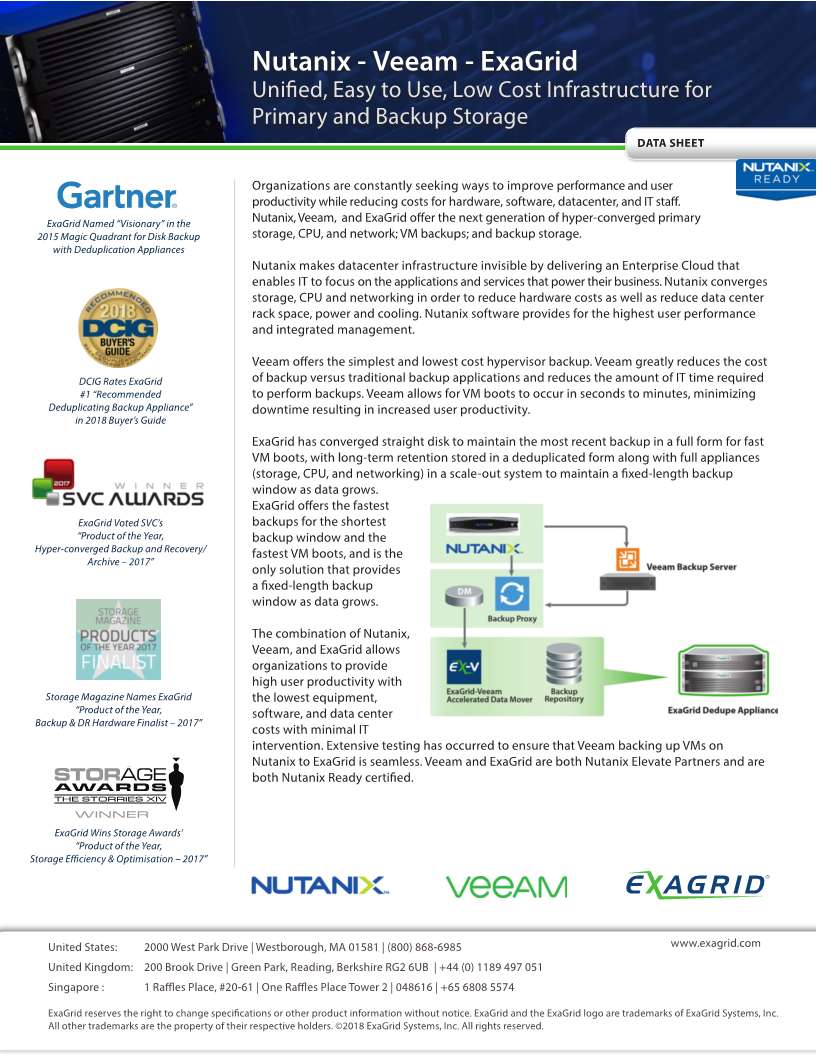
Nutanix – Veeam – ExaGrid: プライマリストレージとバックアップストレージのための統合型・使いやすい・低コストなインフラストラクチャ

現在のバックアップ・リカバリーソリューションは、データが増えるにつれて管理が複雑になりコストがかかることはありませんか?

Nutanix、Veeam、ExaGrid は統合し、プライマリストレージとバックアップストレージの統合的で使いやすいインフラを提供し、高性能を推進しつつコストを大幅に削減します。

  • Nutanix Enterprise Cloudは、コンピュート、ストレージ、ネットワークをハイパーコンバージドプラットフォームに統合し、インフラを目立たなくし、ハードウェア、電力、冷却コストを削減します。

・Veeamはシンプルで低コストのハイパーバイザーバックアップを提供し、IT管理時間を大幅に短縮し、VMの復旧を数秒から数分で可能にし、ダウンタイムを最小限に抑え生産性を向上させます。

  • ExaGridのスケールアウトバックアップストレージは、最新のバックアップを完全な非重複形式で保持し、高速復元を可能にします。一方、長期保持データは重複除去形式で保存し、データ成長に伴う固定長のバックアップウィンドウを維持します。

  • この統合ソリューションは、NutanixからExaGridへのシームレスなVMバックアップを保証し、最小限のIT介入で最速のバックアップウィンドウとVM復旧を実現します。

https://www.climb.co.jp/soft/exagrid

Kubernetesのバックアップと復旧をN2WSで実現

Kubernetesのセキュリティは、予防策が失敗した際の信頼性の高い復旧手段がなければ不完全です。根本原因がランサムウェア、誤削除、設定ミス、認証情報の侵害のいずれであっても、組織はKubernetesワークロードを迅速かつクリーンに、確信を持って復元する能力を必要とします。

N2WSは、AWS EKS上で動作するKubernetes環境向けにポリシー駆動型のバックアップと復旧を提供し、データだけでなくKubernetesの完全な状態を保護するように設計されています。これにはネームスペースやクラスターも含まれ、チームがアプリケーションを元の状態(単なるストレージではなく)で復旧できることを保証します。

手動のetcdスナップショットや、実際の負荷下で機能しなくなる可能性のある自作ツールとは異なり、N2WSはKubernetesのバックアップを自動化し、他のクラウドリソース保護に使用される同一プラットフォームに統合します。この統合アプローチにより、運用上の複雑さが軽減されると同時に、セキュリティ態勢が強化されます。

主要なセキュリティおよび回復力機能には以下が含まれます:

自動化されたEKSバックアップと復旧(ネームスペースまたはフルクラスター対象)、アプリケーションを意識した一貫性のあるスナップショット

同一クラスターまたは異なるクラスターへの復旧、迅速なロールバック、侵害後のクリーンな復元、制御された移行を実現

不変のバックアップとエアギャップDRアカウント、攻撃者による復旧ポイントの削除や暗号化を防止

●定期的なDRテストと復旧シナリオ、インシデント発生前にバックアップが使用可能であることを保証

N2WSにより、復旧は予測可能、監査可能、かつ迅速になり、チームがセキュリティ、コンプライアンス、事業継続性の要件を満たすのに役立ちます。不要な複雑さを追加することなく実現します。